
百度渲染蜘蛛抓取排查:搞定百度渲染蜘蛛抓取排查
进行百度渲染蜘蛛抓取排查,最核心的动作就是用日志分析结合本地 Puppeteer 模拟器,直接对比 Baiduspider-render 请求下的真实 DOM 结构与原生 HTML 源码,一旦发现由于 ES6+ 语法报错、接口异步超时(超过3秒)或 Webpack 懒加载失败导致的“白屏”现象,最快的解决办法就是放弃对百度前端渲染能力的幻想,直接部署 Nginx + Prerender 服务或 SSR 服务端渲染。
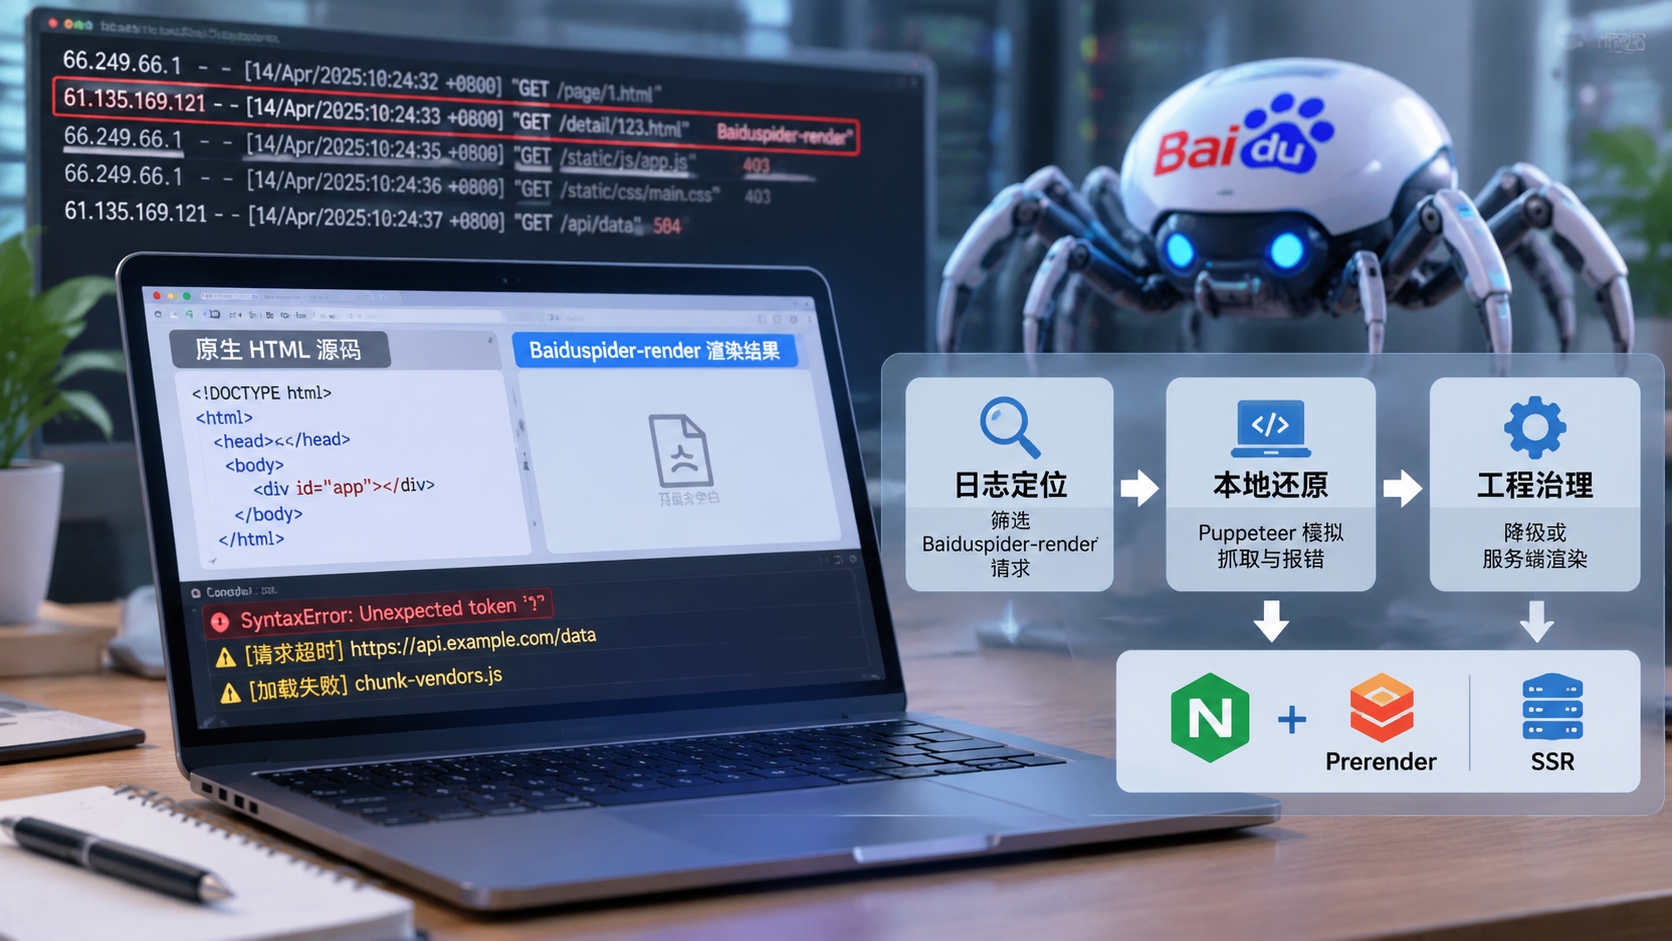
说句掏心窝子的话,搞了这么多年技术,我见过无数前端程序员和 SEO 经理扯皮。前端说:“我本地 Chrome 打开好好的,Vue/React 跑得飞起,绝对没问题”;SEO 说:“百度收录全是空白页,快照里啥也没有”。本质原因就是:百度渲染蜘蛛(Baiduspider-render)的内核版本极低,JS 执行资源配额抠门得很,超时就强行截屏落库。别指望百度会像谷歌 Chrome 一样完美运行你的复杂 SPA 应用,遇到问题必须老老实实做排查和降级。
核心方案速览
搞百度渲染蜘蛛抓取排查,别盲目改代码,按照下面这套“三步走”流程,半小时内就能定位根因:
[第一步:日志定位] 提取 Nginx 日志 -> 筛选 Baiduspider-render 轨迹 -> 确认 HTTP 状态码与响应体积
       │
       ▼
[第二步:本地还原] 匹配百度 User-Agent -> 用老旧 Chromium 或 Puppeteer 抓取 -> 拦截 Console 报错与 Network 超时
       │
       ▼
[第三步:工程治理] 源码降级 (Babel 语法降级)  OR  架构改造 (服务端预渲染 / Nginx 动态路由分发)
实操细节深度拆解
第一步:从 Nginx 日志中精准捕抓渲染蜘蛛
百度普通的抓取蜘蛛(Baiduspider)只拿文本和 HTML 框架,而百度渲染蜘蛛(Baiduspider-render)才会去加载 CSS、JS 以及调异步接口。你得先看看它到底来没来、抓了啥。
在服务器终端直接跑这条命令,从今天的 Nginx 访问日志里把渲染蜘蛛剥离出来:
# 筛选 Baiduspider-render 的请求记录,查看请求 URL、状态码、响应字节数和耗时
cat /var/log/nginx/access.log | grep "Baiduspider-render" | awk '{print $4, $7, $9, $10, $11}' | head -n 30实操避坑点:
如果发现日志里 Baiduspider-render 请求 .js 或 .css 文件时大量返回 403 或 429,赶紧去查防火墙(宝塔系统、雷池 WAF、阿里云 CDN 防刷等)。很多运维把高频静态资源请求当成 CC 攻击给封掉了,JS 文件加载不出来,渲染蜘蛛抓到的必定是白屏。
第二步:本地脚本硬核还原百度渲染过程
千万别拿你最新的 Chrome 浏览器去测试!百度的渲染内核极其古老(甚至还在用类似 Chrome 60+ 时代的渲染引擎),而且对 ES6 语法支持极差(比如可选链操作符 ?.、空值合并运算符 ?? 直接报语法错误,导致整个 JS 脚本中断)。
编写一个简单的 Node.js 脚本,利用 Puppeteer 模拟百度的渲染环境:
// baidu_render_test.js
const puppeteer = require('puppeteer');

(async () => {
  // 启动无头浏览器
  const browser = await puppeteer.launch({
    headless: "new",
    args: ['--no-sandbox', '--disable-setuid-sandbox']
  });

  const page = await browser.newPage();

  // 1. 严格伪造百度移动版渲染蜘蛛的 User-Agent
  await page.setUserAgent('Mozilla/5.0 (iPhone; CPU iPhone OS 9_1 like Mac OS X) AppleWebKit/601.1.46 (KHTML, like Gecko) Version/9.0 Mobile/13B143 Safari/601.1 (compatible; Baiduspider-render/2.0; +http://www.baidu.com/search/spider.html)');

  // 2. 监听页面的 Console 报错(关键!老旧内核语法报错全在这)
  page.on('pageerror', err => {
    console.log('\x1b[31m[页面 JS 抛出异常]\x1b[0m', err.toString());
  });

  // 3. 监听失败的 API 网络请求
  page.on('requestfailed', request => {
    console.log('\x1b[33m[请求失败/被拦截]\x1b[0m', request.url(), request.failure().errorText);
  });

  console.log('正在模拟百度渲染蜘蛛访问...');

  try {
    // 设置超时时间为 5 秒(百度蜘蛛不会等待太久)
    await page.goto('https://yourdomain.com/detail/123.html', {
      waitUntil: 'networkidle2',
      timeout: 5000
    });

    // 获取渲染完成后的 DOM 源码
    const content = await page.content();
    console.log('\x1b[32m[渲染成功]\x1b[0m 最终 DOM 长度:', content.length);

    // 检查核心业务内容是否在 DOM 中
    if (content.includes('你的核心文章内容关键词')) {
      console.log('✅ 百度渲染蜘蛛能够正常抓取到有效文本');
    } else {
      console.log('❌ 警告:DOM 中未发现核心内容,页面可能被渲染为空白或加载中状态');
    }

  } catch (error) {
    console.log('\x1b[31m[抓取超时或渲染失败]\x1b[0m', error.message);
  } finally {
    await browser.close();
  }
})();运行调试:
执行 node baidu_render_test.js。如果你看到 [页面 JS 抛出异常] SyntaxError: Unexpected token,恭喜你,直接定位原因——你的前端打包配置(Babel / Vite)没有做低版本浏览器兼容,百度蜘蛛解析 JS 卡死在第一行。
第三步:架构级终极解决方案(Nginx + 动态渲染分发)
如果你的项目是纯 Vue/React 的单页应用(SPA),改造 SSR(如 Nuxt/Next)成本太高,最干脆落地的方案就是在服务器端部署 Prerender.io(或自己搭一个 Puppeteer 渲染集群),通过 Nginx 判断 UA,如果是百度蜘蛛,就把请求转发给预渲染服务,普通用户依然走 SPA。
以下是能够直接套用的 Nginx 生产环境配置:
server {
    listen 80;
    server_name yourdomain.com;

    location / {
        root /var/www/dist;
        index index.html;

        # 设置变量,默认不进行预渲染
        set $prerender 0;

        # 匹配百度渲染蜘蛛、普通蜘蛛以及其他常见搜索引擎蜘蛛
        if ($http_user_agent ~* "Baiduspider|Baiduspider-render|YisouSpider|Sogou web spider") {
            set $prerender 1;
        }

        # 排除静态资源,静态资源绝对不要走预渲染!
        if ($uri ~* "\.(js|css|xml|less|png|jpg|jpeg|gif|pdf|doc|txt|ico|rss|zip|mp3|rar|exe|wmv|doc|avi|ppt|mpg|mpeg|tif|wav|mov|psd|ai|xls|mp4|m4a|swf|dat|dmg|iso|iso|apk|torrent|tf|ttf|woff|svg|eot)") {
            set $prerender 0;
        }

        # 如果是蜘蛛访问,转发到本地 3000 端口的 Prerender 服务
        if ($prerender = 1) {
            # 这里的 127.0.0.1:3000 是你本地启动的 prerender node 服务
            rewrite .* /http://$host$request_uri break;
            proxy_pass http://127.0.0.1:3000;
        }

        # 普通用户依然走单页应用路由机制
        try_files $uri $uri/ /index.html;
    }
}
高频关联问题拓展
问题一:百度蜘蛛抓取的快照是空白,但抓取诊断工具显示“正常”
这是很多站长踩过的天坑。百度官方的“抓取诊断”工具,很多时候使用的仅仅是基础抓取蜘蛛的返回结果(即直接拿源码),如果你的源码里有 HTML 骨架和基础 <title>,诊断工具就会提示“成功”。但到了实际索引阶段,渲染蜘蛛运行 JS 失败,导致提取索引词库时啥也没有,最后出现“不收录”或“索引量暴跌”。
- 排查避坑:别只信站长平台的诊断面板。必须通过日志确认
Baiduspider-render的真实行为,或直接查看百度快照。如果快照一片空白,100% 是前端 JS 脚本在百度内核里挂掉了。
问题二:动态渲染(Dynamic Rendering)会被百度判定为“作弊/伪装(Cloaking)”吗?
明确回答:只要展示内容一致,绝对不会被罚。 百度官方和 Google 官方都公开发布过标准:为了解决单页应用(SPA)搜素引擎抓取困难的问题,允许服务端针对 Spider 输出渲染后的 HTML 文本。只要你给蜘蛛看的内容,和给真实用户看的内容是一致的(没有故意给蜘蛛插入违规词或做诱导跳转),这就是合规的技术手段,放开手脚去搞。
问题三:Prerender 服务频繁崩溃,Node.js 进程内存泄漏
用 Puppeteer 搭建预渲染服务时,每个抓取请求都会拉起一个 Chromium 页面,极其消耗内存。如果没处理好,百度蜘蛛一密集访问,服务器内存瞬间爆满,导致 Nginx 报 502 Bad Gateway。
- 落地方案:必须使用
PM2进行进程管理,并设置最大内存重启限制,同时在 Puppeteer 中做请求拦截,禁止渲染蜘蛛在预渲染阶段加载图片和媒体文件。
PM2 配置文件 ecosystem.config.js 套用模板:
module.exports = {
  apps : [{
    name: 'prerender-node',
    script: './server.js',
    instances: 2, // 根据 CPU 核心数调整
    autorestart: true,
    watch: false,
    max_memory_restart: '1G', // 内存占用超过 1G 自动重启进程释放内存
    env: {
      NODE_ENV: 'production',
      PORT: 3000
    }
  }]
};
总结
对百度搜索引擎而言,“能运行复杂现代前端框架的渲染蜘蛛”更像是一个成本高昂的产物。在百度渲染蜘蛛抓取排查的实际工作中,不要把希望寄托在百度技术团队更新内核上。最稳妥、最节省人力成本的铁律只有一条:静态化是王道,SSR 是正统,SPA 必须靠动态渲染兜底。只要你在服务端把包含完整文本数据的纯 HTML 送到 Baiduspider-render 嘴里,收录和索引问题自然迎刃而解。