
RAG检索增强生成架构优化:RAG老答错?教你动手优化它
很多团队刚把大模型和知识库连起来时觉得挺惊艳,但一跑真实业务就傻眼了:搜出来的文档八竿子打不着,模型天天一本正经地胡说八道,响应还慢得像蜗牛。面对这种业务瓶颈,单纯换个更贵的闭源大模型往往解决不了根本问题,真正见效的解法在于系统性的RAG检索增强生成架构优化。今天我就结合几个月在生产环境摸爬滚打的落地上线经验,抛开那些云山雾罩的学术论文,聊聊怎么把这套架构拆开、改透,让你的AI应用变得又准又快。
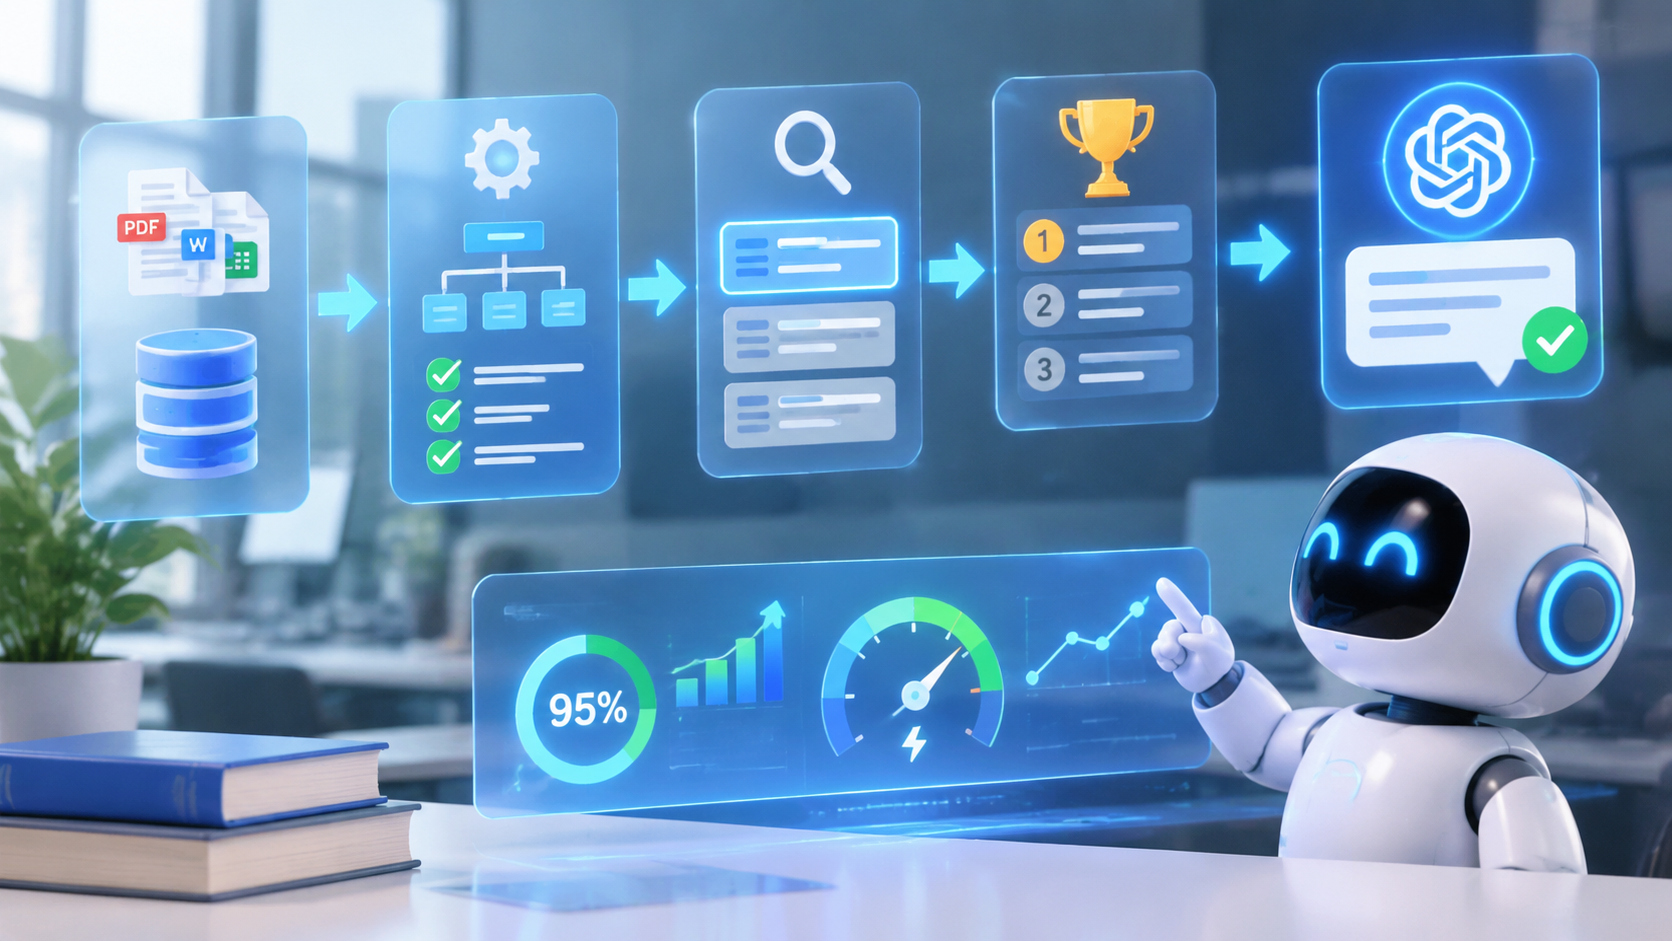
一、 先找病根:为什么你的RAG跑不出效果?
绝大多数效果差的RAG系统,不是技术路线错了,而是“粗放施工”导致的。最典型的工作流就是:把PDF文本无脑按500字切开,扔进开源Embedding模型转成向量存进向量库,用户提问就Top-K召回前3条喂给LLM。
这么干十有八九会踩三个坑:
- 语义碎成渣:表格被切断、标题和正文分离,检索召回的片段前言不搭后语。
- 向量检索的“偏科”:语义检索擅长理解模糊意图,但遇到专有名词、产品型号、工单ID时,精准度还不如老旧的SQL模糊查询。
- 大模型“迷失在中间”:给模型塞了四五篇长文档,它往往只看开头和结尾,核心答案刚好落在中间段落时直接被忽略。
搞清楚问题出在哪,优化才能刀刀见血。
二、 落地见效的四大优化实操
想把召回率和准确率提上来,不需要推倒重来,沿着数据流从前往后改这四个模块就够了。
1. 数据入库清洗与动态切块(Chunking)
别再用固定的字符长度切分文本了,这是效果差的罪魁祸首。
- 层级切块(Parent-Child Chunking):这是目前工程上最好用的方案。把文档切成较小的子块(比如100~200 token)用于做向量匹配,但给子块打上标记,对应一个更大的父块(比如800 token)。向量搜索命中子块后,实际传给大模型的是信息完整的父块上下文。
- 元数据注入(Metadata Enrichment):切块不能光存正文。写个脚本在切片时自动提取文档来源、章节标题、时间、关键实体,打包存入Metadata中。在检索阶段可以先用Metadata做硬过滤,大大减少检索范围。
2. 拥抱混合检索(Hybrid Search)
单一依赖向量检索在专业领域必翻车。工业界成熟的标配方案是:密集向量检索(Dense Retrieval)+ 稀疏关键词检索(Sparse Retrieval/BM25)。
实战配置建议: 用 Elasticsearch 或带有全文检索能力的向量库(如 Milvus, Qdrant)。用户输入问题后,两路并发检索:BM25负责精准抓取特定的专有名词、编号;Embedding负责抓取同义词、意图匹配。最后使用倒数排名融合算法(RRF,Reciprocal Rank Fusion)把两边的得分合并。
3. 加入重排机制(Rerank):性价比最高的“杀手锏”
如果你只能做一个优化动作,那就选 加一个 Cross-Encoder Reranker。
双塔结构的Embedding检索为了速度牺牲了精度,召回的前20条数据往往鱼龙混杂。在向量检索和大模型生成之间,插一个重排模型(比如 BGE-Reranker 或 Cohere Rerank):
| 处理阶段 | 输入规模 | 处理速度 | 语义精度匹配度 |
|---|---|---|---|
| 初筛(向量+BM25) | 全量知识库(数万~数百万) | 极快(毫秒级) | 中等(单文本独立计算) |
| 精排(Rerank模型) | 前 30~50 条候选片段 | 较快(几十毫秒) | 极高(计算Query与Doc交互) |
| 最终输入(LLM Context) | 筛选后保留得分前 3~5 条 | 视Token量而定 | 剔除90%噪音,显著降低幻觉 |
这一步能直接把端到端回答的准确率拉升20%~30%,而且改造成本极低,加个本地微服务就搞定了。
4. 上下文动态压缩与Prompt提纯
很多人喜欢把召回的内容不管三七二十一全拼进Prompt,结果导致Prompt费用暴涨、推理延迟增加,还经常触发模型的“迷失中间”效应。
- 重排后去重截断:设置阈值,相关度低于0.6的内容哪怕在Top-K里也直接扔掉。
- 按相关性倒序排列传给LLM:既然LLM对上下文的“头部”和“尾部”最敏感,那就把重排得分最高的片段放在最前面和最后面,次优的放在中间。
三、 运维视角:怎么量化优化到底有没有用?
优化不能凭感觉,业务方跑过来说“好像准了一点”是没法交差的。在架构改造时,必须在后台建立量化指标:
- 召回率指标(Hit Rate & MRR):准备50个典型业务问题及标准答案切片,每次调整切块或检索参数后跑一次批量测试,看标准切片有没有进Top-5。
- 端到端耗时拆解:
- 检索耗时(Embedding + 向量查询)应控制在 50ms 以内。
- 重排耗时控制在 100ms 左右。
- 首字生成时间(TTFT)重点卡在LLM本身的响应上。
- 无答案拒答率:当检索结果的最高得分都低于安全阈值时,直接让系统回复“知识库中未找到相关内容”,而不是让大模型强行瞎编。敢于拒答才是系统走向成熟的标志。
四、 常见避坑问答
Q:我们的业务需要频繁更新文档,增量更新怎么做最优雅? A:千万别每次全量重新切片。文档入库时必须基于内容生成哈希值(Hash),按“文档ID-切片序号”做唯一标识。更新时只对比文档哈希,发生变化的文档做“先删后插”,冷热数据一定要在向量库层做好分区。
Q:小团队没卡,自己部署重排模型划算吗? A:划算。像 BGE-Reranker-Large 这类模型,用一张普通消费级显卡(甚至优化好的CPU推理环境)就能跑出很漂亮的并发。比起直接调更贵、上下文更长的大模型API,本地跑个重排在成本上划算得多。
写在最后
优化RAG架构从来不是靠某个“黑科技模型”一招制敌,它本质上是一个经典的搜索与推荐工程。多花心思在文本清洗、混合召回以及精准重排这些脏活累活上,比整天琢磨提示词工程有用得多。先搭一套简单的评估集把基线跑出来,按上面说的步骤一步步打补丁,你的知识库系统很快就能从“玩具”蜕变成真正靠谱的生产力工具。