
全站死链排查与404重定向:全站死链清洗与404重定向实操
全站死链排查与404重定向的核心逻辑只有两步:用爬虫配合服务端日志把死链连根拔起,然后在Web服务器层面做标准状态码分流,绝不能简单粗暴地把所有失效链接一股脑全301跳到首页。很多新手站长甚至部分老运维为了图省事,配个通配符把所有找不到的页面统统 rewrite 回首页,这种“软404”操作在搜索引擎眼里就是典型的作弊和体验灾难,不仅无法继承权重,还会导致全站收录断崖式下跌。
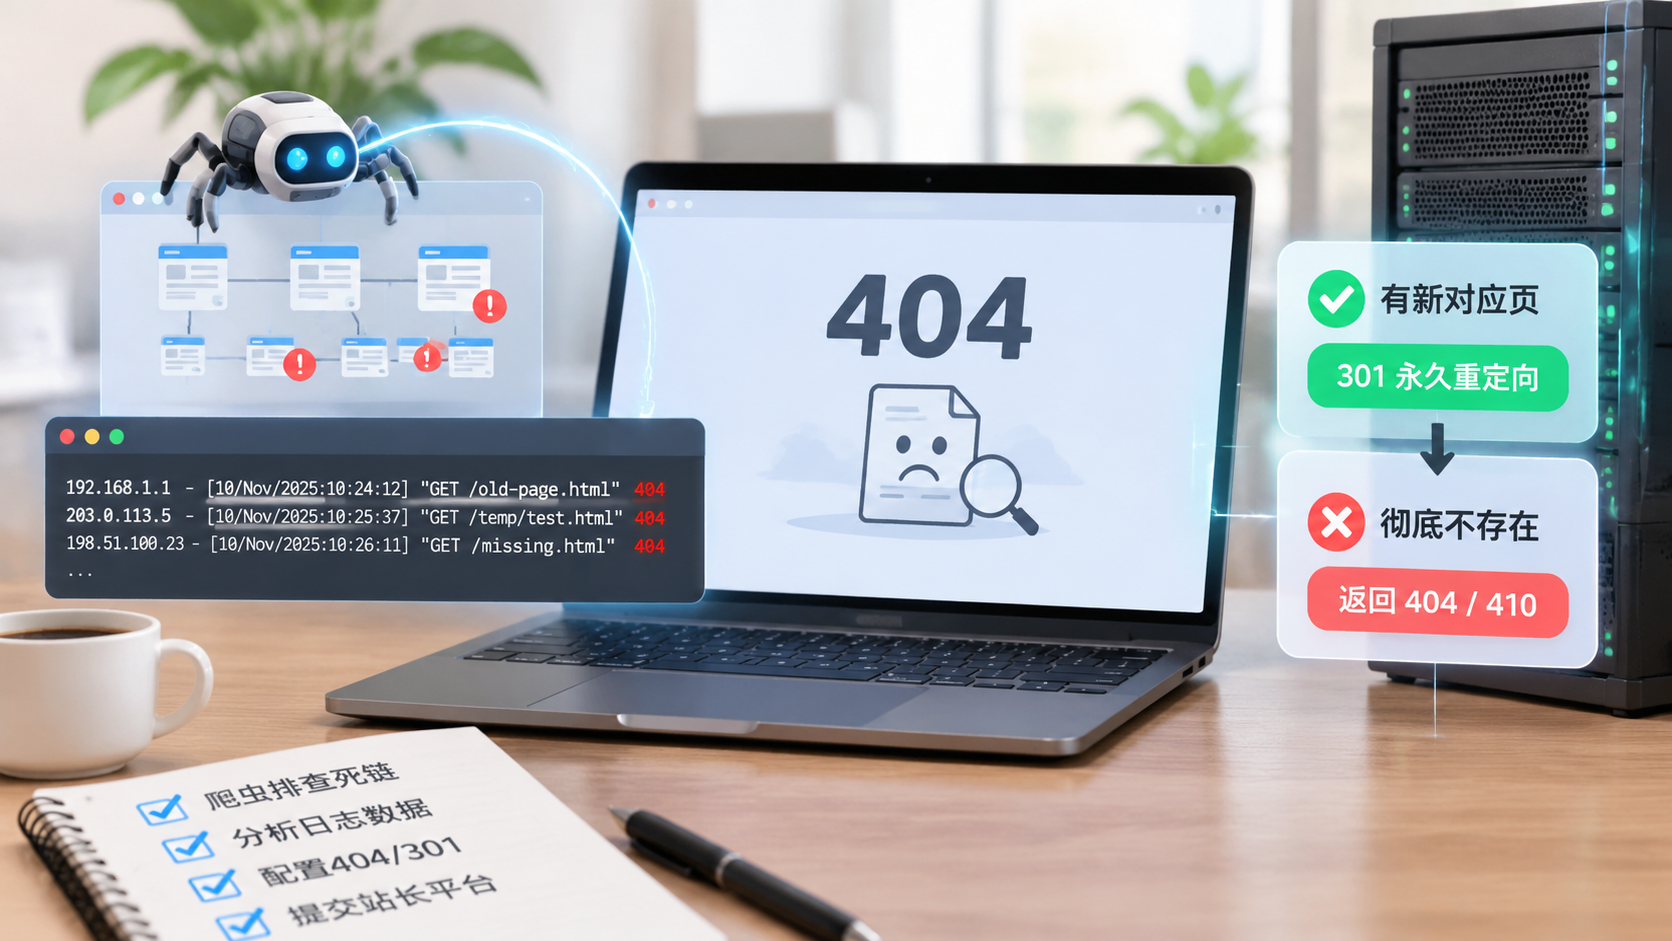
核心方案速览
搞定网站死链与重定向,一套标准的闭环落地流程如下:
- 死链发现:利用自建脚本/离线爬虫(爬全站内链)+ 生产环境 Nginx 日志分析(抓取外部访问导致的 404)。
- 死链定性:区分“路径迁移产生的死链”(有新对应页)和“彻底删除的内容/恶意扫描”(无对应页)。
- 分流处置:
- 有新对应页:服务器层配置 301 永久重定向 到精准新 URL。
- 彻底不存在:服务器层坚决返回 标准 404 状态码(如果是明确不再恢复的死链接,可返回 410 Gone 加速注销)。
- 自动化监控:定时任务跑日志分析脚本,产生报警,定期向搜索引擎站长平台提交 Deadlink 列表。
实操细节深度拆解
步骤一:全站死链排查(两头堵策略)
很多线上死链不是内部链接搞出来的,而是历史外链、用户收藏夹或者黑客扫出来的。因此,排查必须“内爬+外抓”。
1. 内链爬取排查(Python 异步脚本直接跑)
市面上的商业 SEO 工具动不动限制爬取页数还要收费。用下面这个轻量 Python 脚本(依赖 requests 和 beautifulsoup4),扔到测试机或者本地直接扫内链死链:
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin, urlparse
from concurrent.futures import ThreadPoolExecutor

TARGET_DOMAIN = "example.com"
START_URL = "https://example.com"
visited_urls = set()
dead_links = []

headers = {"User-Agent": "InternalDeadLinkChecker/1.0"}

def check_and_extract(url):
    if url in visited_urls:
        return
    visited_urls.add(url)

    try:
        response = requests.get(url, headers=headers, timeout=5, allow_redirects=True)
        # 捕捉 404 以及 5xx 错误链接
        if response.status_code >= 400:
            print(f"[DEAD] {response.status_code} -> {url}")
            dead_links.append((url, response.status_code))
            return

        # 只提取站内链接继续爬
        if urlparse(url).netloc == TARGET_DOMAIN and "text/html" in response.headers.get("Content-Type", ""):
            soup = BeautifulSoup(response.text, "html.parser")
            links = [urljoin(url, a.get("href")) for a in soup.find_all("a", href=True)]
            with ThreadPoolExecutor(max_workers=5) as executor:
                executor.map(check_and_extract, [l for l in links if l.startswith("http") and l not in visited_urls])
    except Exception as e:
        dead_links.append((url, str(e)))

if __name__ == "__main__":
    print("开始排查内链死链...")
    check_and_extract(START_URL)
    with open("dead_links.txt", "w") as f:
        for link, code in dead_links:
            f.write(f"{code}\t{link}\n")
    print(f"排查完成,发现 {len(dead_links)} 个死链,已存入 dead_links.txt")
2. 服务端日志挖掘(抓外部访问死链)
这是最容易被忽略的盲区。直接在 Nginx 接入层服务器上跑 Shell 命令,捞出最近日志里被频繁访问但返回 404 的链接:
# 提取 access.log 中状态码为 404 的请求 URL、来源 IP 及访问频次(按频次倒序排前 50)
awk '($9 ~ /404/)' /var/log/nginx/access.log | awk '{print $7}' | sort | uniq -c | sort -rn | head -n 50
把排名前列的高频 404 挑出来。如果是历史改版导致的大批量访问,说明曾经有权重,必须配置精准重定向;如果是 wp-login.php、.env 这种被恶意扫出来的,直接忽略即可。
步骤二:规范配置 Web 服务器的 404 响应
最忌讳的配置就是用前端 JavaScript 做跳转的“伪 404”,或者状态码返回 200 但页面写着“对不起,找不到页面”。不仅浪费爬虫配额,还可能被搜索引擎判定为低质内容聚合页。
以下是 Nginx 中最干净利落的标准 404 页面配置:
server {
    listen 80;
    server_name example.com;
    root /data/www/html;

    # 关键:指定 404 错误页面的本地路径
    error_page 404 /404.html;

    # 确保 404.html 本身存在,且直接通过静态文件响应
    location = /404.html {
        # 内部访问限制,防止外部直接显式访问 /404.html 显示 200
        internal;
        root /data/www/html;
    }

    # 业务路由代理或静态解析
    location / {
        try_files $uri $uri/ =404;
    }
}避坑重点:切记在配置 error_page 404 /404.html; 时,不要写成 error_page 404 =200 /404.html;!加了 =200 就会强制把 HTTP 状态码改写为 200,立刻掉进软 404 的大坑。
步骤三:301 永久重定向的高效配置实操
针对网站改版、分类目录迁移、URL 规则优化后的死链,必须使用 301 永久重定向 将流量与权重引导至新地址。
场景 A:整批目录规则变更(正则级重定向)
例如:网站原路径为 /archive/2021/1001.html,改版后路径统一为 /posts/1001.html:
location ^~ /archive/ {
    # 提取末尾的文章ID直接拼接跳转,返回 301
    rewrite ^/archive/[0-9]+/([0-9]+)\.html$ /posts/$1.html permanent;
}
场景 B:零散死链的批量映射(Nginx Map 模块)
如果是几百个没有特定正则规律的历史死链,别傻傻在配置文件里写几百条 rewrite,那会导致 Nginx 性能严重下降。推荐使用 map 指令处理:
在 nginx.conf 的 http 块中定义映射表:
http {
    # 建立原死链与新链接的映射关系
    map $request_uri $new_target_url {
        default "";
        /old-category/about-us.html    /about;
        /help-v1/install-guide.html    /docs/installation;
        /product-2020.html             /products/latest;
    }

    server {
        listen 80;
        server_name example.com;

        # 命中映射表则直接 301 跳转
        if ($new_target_url != "") {
            return 301 $new_target_url;
        }

        # 正常业务逻辑...
    }
}
map 基于哈希表实现,几千条映射依然是毫秒级查询,对服务器 CPU 几乎零损耗。
高频关联问题拓展与避坑点
-
SPA(单页应用/Vue/React)的全站“假 200”问题
- 现象:很多前端为了实现路由刷新不报错,在 Nginx 里配置
try_files $uri $uri/ /index.html;。这导致任何乱七八糟的 URL(如/dsjkahdks)都返回了 200 状态码和首页 HTML,然后前端再通过路由守卫去渲染一个 404 组件。 - 后果:搜索引擎爬虫认为这些垃圾链接全都是有效页面,全网抓取并收录大量内容一模一样的页面,直接拉垮整站权重。
- 解法:SPA 尽量采用 SSR(服务端渲染) 处理关键页面;若必须纯前端静态托管,请在 404 路由守卫里,利用 Prerender 或边缘节点(如 Cloudflare Workers)截获并向爬虫输出真正的 HTTP 404 状态头。
- 现象:很多前端为了实现路由刷新不报错,在 Nginx 里配置
-
死循环重定向(Redirect Loop)
- 现象:A 页面 301 到 B 页面,B 页面因为某些路由机制又 301 跳回 A 页面;或者带有斜杠
/的 URL 与不带斜杠的 URL 互相强制跳转。 - 排查手段:用终端命令追溯跳转链:
curl -IL https://example.com/target-path查看响应头里的
Location,严格确认跳转层级不超过 2 次,一旦发现重复的 URL 链条,立刻回退 Nginx 的正则规则。
- 现象:A 页面 301 到 B 页面,B 页面因为某些路由机制又 301 跳回 A 页面;或者带有斜杠
-
搜索引擎死链提交的正确姿势
- 不要以为做完 404 就万事大吉。百度、谷歌等爬虫重新校对死链的周期极长。
- 规范做法:用上面提取出来的死链列表生成纯文本
deadlink.txt,挂在站点根目录,然后前往百度搜索资源平台、Google Search Console 的“死链提交”入口主动投递。注意:提交到死链文件中的 URL,必须确保 HTTP 状态码坚决为 404/410,否则会被站长平台判定为文件格式不合规并直接打回。
结尾总结
全站死链排查与404重定向绝不是单纯写个好看的报错网页,它本质上是一套关于流量路由与状态码的运维纪律。
遇到死链,遵循这套铁律:有新家就走 301 精准映射,查无此人就果断返回真实 404,绝不全站跳首页,绝不用 200 状态码糊弄爬虫。把上文中的 Python 爬虫和 Nginx 规则直接套入日常运维,每月定期复盘一次服务端 404 访问日志,网站的架构和抓取健康度自然就能稳稳维持在最优状态。
相关文章
- 长尾关键词挖掘实操:自动化挖掘长尾词的实操打法
- 落地页转化漏斗优化:落地页转化漏斗优化实操指南
- 全站死链排查与404重定向:全站死链清洗与404重定向实操
- CDN缓存命中率调优:CDN缓存命中率拉满实战
- Core Web Vitals性能达标方案:Core Web Vitals实操达标方案
- 网站TTFB首字节耗时排查:网站TTFB首字节耗时排查实战
- 恶意爬虫拦截与服务器防刷策略:恶意爬虫拦截与服务器防刷实战
- 聚合标签页内链权重布局:聚合标签页内链权重布局实战
- 百度API主动推送与快速收录配置:搞定百度API主动推送与快速收录
- Google Search Console抓取错误修复:GSC抓取错误实战排查与修复