
长尾关键词挖掘实操:自动化挖掘长尾词的实操打法
长尾关键词挖掘的核心逻辑只有一条:放弃那些被大厂垄断的行业大词,直接用 Python 脚本批量调取搜索引擎的公开 Suggest API 和问答社区,抓取用户真实搜索时打出的完整疑问句,再按意图聚类洗出高转化词库。
市面上动辄卖几千上万的 SEO 拓词软件,底层大多就是封装了这套公开接口。这篇文章不讲虚的,直接把工业级的长尾词拓词方案、现成脚本和清洗策略交给你,拿去就能跑出数万条精准长尾词。
核心方案速览
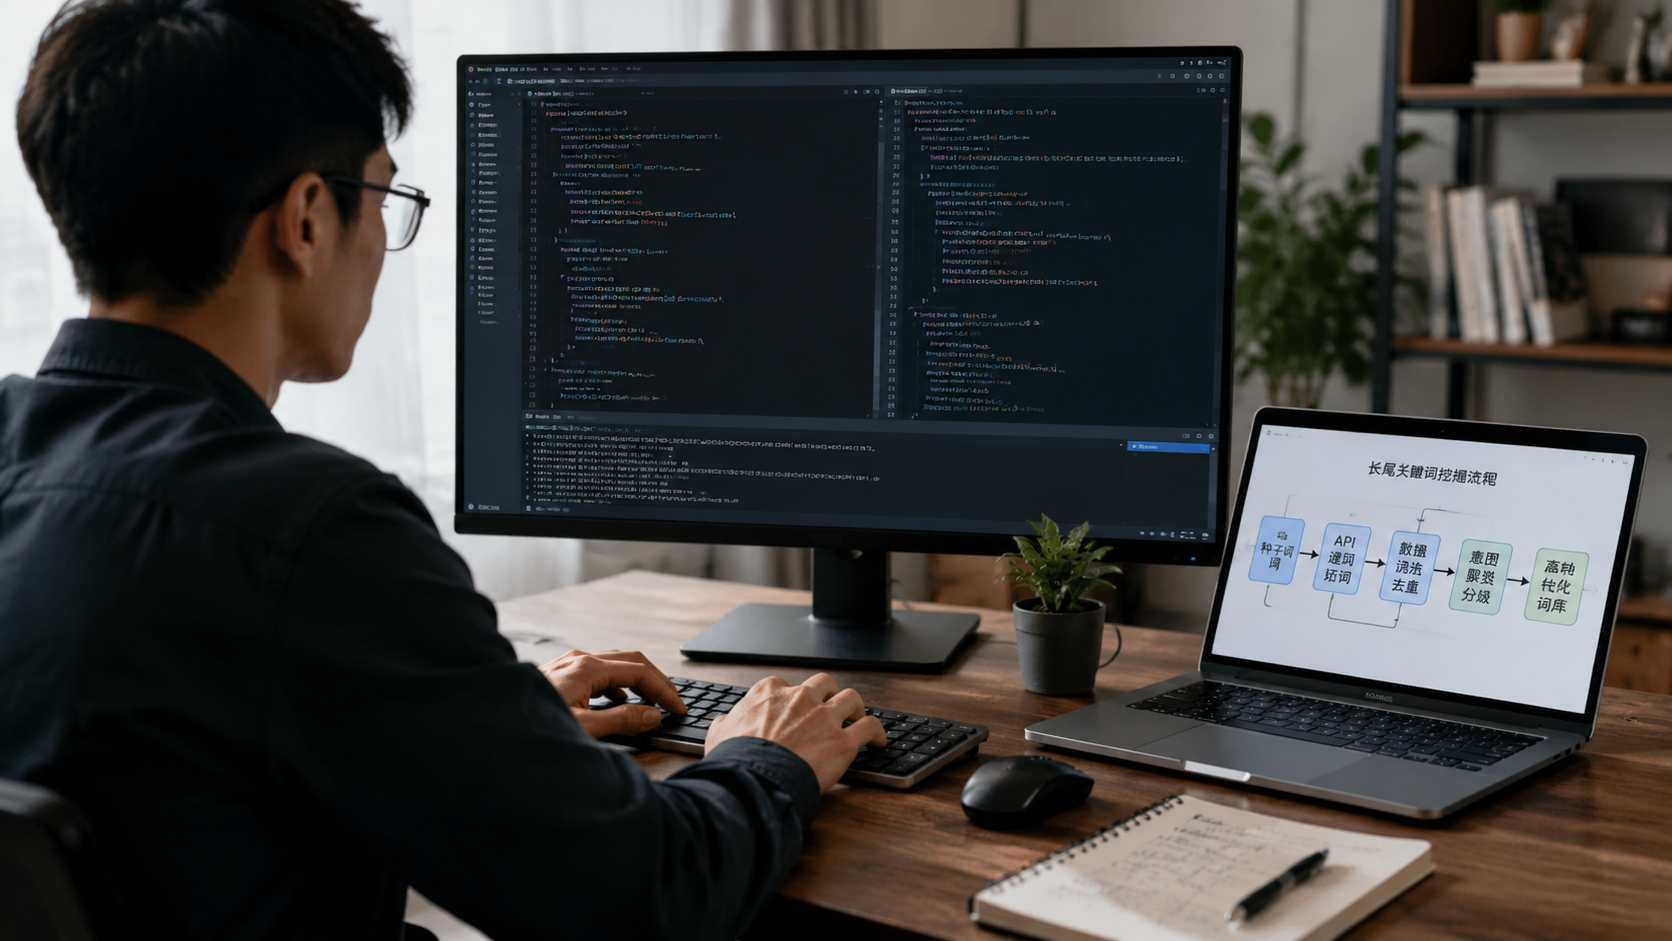
高效挖掘长尾词的核心闭环分为四步:
- 种子词扩充:确定核心产品/服务词(如“Redis”),横向衍生场景词(“报错”、“配置”、“迁移”)。
- 自动化递归抓取:调取百度、必应、Google 的联想词(Suggest)接口,以 A-Z、拼音、疑问代词(怎么、为何、哪个好)为变量递归爬取 2~3 层。
- 数据清洗与去重:剔除无商业价值词、地域无关词,基于 Levenshtein 相似度或语义向量聚类,合并同质词。
- 意图分级与落地:根据“信息型”、“对比型”、“交易型”打标,分别对应生产教程内容、对比选型页或产品落地页。
实操细节深度拆解
步骤一:零成本白嫖搜索引擎 Suggest API 递归拓词
别去用浏览器一个个手动复制下拉框,低效且视野极窄。搜索引擎其实对搜索框下拉词开放了轻量级的 HTTP 接口,没有变态的反爬机制,响应速度在毫秒级。
以百度和必应为例,其联想接口格式非常固定:
- 百度:
https://suggestion.baidu.com/su?wd={keyword}&p=3&cb=window.bdsug.sug - 必应:
https://api.bing.com/qsonhs.aspx?q={keyword}
这里提供一段即拷即用的 Python 异步拓词脚本,带递归深度控制,抓取效率极高:
import asyncio
import aiohttp
import json
import re

HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

async def fetch_baidu_suggest(session, keyword):
    url = f"https://suggestion.baidu.com/su?wd={keyword}&action=opensearch"
    try:
        async with session.get(url, headers=HEADERS, timeout=5) as resp:
            if resp.status == 200:
                text = await resp.text()
                # OpenSearch 格式返回的是纯 JSON 数组: [query, [results]]
                data = json.loads(text)
                return data[1] if len(data) > 1 else []
    except Exception as e:
        return []
    return []

async def expand_keywords(seed_word, depth=2):
    visited = set()
    current_level = {seed_word}

    # 前缀/后缀修饰符,专门用来挖高意向长尾词
    modifiers = ["怎么", "如何", "哪个好", "报错", "教程", "替代品", "价格", "优化"]

    async with aiohttp.ClientSession() as session:
        for d in range(depth):
            print(f"[*] 正在抓取第 {d + 1} 层,当前待拓展词数量: {len(current_level)}")
            tasks = []

            # 第一层加入修饰符组合,加速裂变
            expand_targets = set(current_level)
            if d == 0:
                for mod in modifiers:
                    expand_targets.add(f"{seed_word} {mod}")

            for kw in expand_targets:
                if kw not in visited:
                    visited.add(kw)
                    tasks.append(fetch_baidu_suggest(session, kw))

            results = await asyncio.gather(*tasks)
            next_level = set()
            for res in results:
                for kw in res:
                    if kw not in visited:
                        next_level.add(kw)

            current_level = next_level
            await asyncio.sleep(0.5)  # 礼貌抓取,避免打爆自身IP

    return visited

if __name__ == "__main__":
    seed = "Nginx"
    result = asyncio.run(expand_keywords(seed, depth=2))
    print(f"[+] 拓词完毕!共获得 {len(result)} 个长尾词。部分结果示例:")
    for word in list(result)[:10]:
print(f" - {word}")适用场景:新站起步、新业务线建站前期批量储备内容选题。 避坑点:递归深度严禁开到 4 层以上。由于指数量级裂变,第 4 层可能会抓出数十万个与核心业务严重脱钩的泛词(比如从“Nginx配置”一路飘到“电脑开机蓝屏怎么办”)。深度设为 2,最多设为 3 足够使用。
步骤二:行业社区真实问答词逆向提取
搜索引擎下拉词反映的是“大家正在搜什么”,而知乎、V2EX、各类垂直论坛等社区抓下来的,才是“用户遇到了什么痛点解不开”。这种词转化率奇高。
实操打法不用直接爬整站,直接用各大搜索引擎的高级搜索指令(Search Operators)批量扒:
- 组合指令构建:
site:zhihu.com/question "Docker" "报错" site:v2ex.com/t "替代方案" "开源" -
提词正则规则: 问答社区的标题天然就是长尾词。获取页面标题后,用简单的正则去除非关键词主体内容:
import re

def clean_title(raw_title):
   # 剔除社区常见尾缀
   cleaned = re.sub(r'(- 知乎| - V2EX|_百度知道|【.*】|\(.*\))', '', raw_title)
   # 过滤无用字符
   cleaned = cleaned.strip()
   return cleaned
业务价值:此类词往往包含明确的痛点,如“Docker 镜像拉取超时 怎么解决”、“ClickHouse 写入内存溢出 排查”。针对这类长尾词写一篇 800 字的直接避坑贴,排名极快,且来的全是高意向技术人员。
步骤三:语义聚类与垃圾词剔除(拒绝词库虚胖)
拓完词后,你手里可能有数万条数据,直接去写内容会产生严重的“关键词自相残杀”(Keyword Cannibalization)——比如“Nginx 反向代理配置教程”和“Nginx 如何配置反向代理”,搜索引擎认为这俩是一个东西,如果各自做个页面,两个页面都会拿不到排名。
必须做语义聚类清洗。直接用 Python 简单的 Jaccard 相似度或编辑距离就能搞定:
from difflib import SequenceMatcher

def is_similar(a, b, threshold=0.75):
    """计算两个词的字面相似度"""
    return SequenceMatcher(None, a, b).ratio() >= threshold

def deduplicate_keywords(keyword_list):
    unique_clusters = []

    for kw in sorted(keyword_list, key=len, reverse=True):
        matched = False
        for cluster in unique_clusters:
            # 如果新词与聚合根词高度相似,归入同一簇,不再单独作为页面关键词
            if is_similar(kw, cluster['canonical']):
                cluster['variants'].append(kw)
                matched = True
                break
        if not matched:
            unique_clusters.append({'canonical': kw, 'variants': []})

    return unique_clusters

# 演示去重
raw_keywords = [
    "Nginx反向代理配置",
    "Nginx反向代理怎么配置",
    "Nginx如何配置反向代理",
    "Nginx负载均衡算法有哪些",
    "Nginx负载均衡配置实例"
]

clusters = deduplicate_keywords(raw_keywords)
for c in clusters:
print(f"核心落地词: 【{c['canonical']}】,衍生变体: {c['variants']}")实操避坑:
- 别盲目依赖词根分词,中文的长尾意图重叠度极高。
- 过滤规则里,务必加入“黑名单库”:破解版、挂机、成人、赌博等灰黑产词,哪怕自带大流量也必须一键过滤,否则新站分分钟被算法降权。
高频关联问题拓展
Q1:抓出来的长尾词,月搜索量全是 0(零搜词),到底做不做?
做,但不要单独立页。 很多第三方工具(爱站、站长之家、Ahrefs)显示的搜索量是基于抓取指数估算的,但大量的长尾疑问词由于表达高度分散,在工具里全是 0 搜索量。真实情况是:只要在搜索引擎下拉框里能跑出来的词,近 30 天内必然有真实用户在搜。
- 策略:把这批零搜长尾词当做主内容页的 H2/H3 副标题,或者做成页面的 FAQ 模块。主词吃大流量,零搜词吃隐藏的精准流量。
Q2:词库有了,该用文章页落地,还是批量做 Tag 标签页?
这是最常见的翻车点。很多技术人员写个脚本抓了 5 万个长尾词,写个模板拼成 5 万个 Tag 标签聚合页直接上线,结果直接被当成低质垃圾站被 K 掉。
- 做内容的原则:有没有独特增量信息?
- 表达明确疑问的(如“XX报错怎么办”、“XX代码怎么写”):必须用单篇独立文章落地,直接给出解决方案。
- 表达实体对比的(如“XX与XX哪个好”、“XX替代品”):可以做对比测评专题页。
- 只有包含数个强关联文章的词,才允许生成一个带索引价值的 Tag 聚合页。空内容、分页内容少于 5 篇的 Tag 页必须全站
noindex。
Q3:怎么防止长尾词页面互相蚕食权重?
建立内部的锚文本拓扑图。 如果核心词是“Docker 入门”,衍生词是“Docker 安装”、“Docker 常用命令”、“Docker 端口映射”。
- 规则:所有衍生子页面的内容中,必须包含一个指向核心词页面(“Docker 入门”)的精准锚文本,告诉搜索引擎这个页面是父级;
- 衍生子页面之间(如“端口映射”与“常用命令”)可以通过“相关阅读”单向互链,严禁无脑全站全量互相乱链。
总结
做长尾关键词挖掘,核心不是看你买的工具库有多大,而是看你把意图拆解得有多细。
不要在大词上死磕去当炮灰。用 Suggest API 跑出两千个带具体场景的疑问词,聚类合并成两三百个高价值选题,每个选题用专业实操内容去攻克,一个月之内你的站点就会开始稳定涌入极具商业价值的长尾流量。抓取脚本已经给你了,现在去终端建个 .py 文件,把你的主词放进去跑一遍,比看任何 SEO 理论课都管用。
相关文章
- 长尾关键词挖掘实操:自动化挖掘长尾词的实操打法
- 落地页转化漏斗优化:落地页转化漏斗优化实操指南
- 全站死链排查与404重定向:全站死链清洗与404重定向实操
- CDN缓存命中率调优:CDN缓存命中率拉满实战
- Core Web Vitals性能达标方案:Core Web Vitals实操达标方案
- 网站TTFB首字节耗时排查:网站TTFB首字节耗时排查实战
- 恶意爬虫拦截与服务器防刷策略:恶意爬虫拦截与服务器防刷实战
- 聚合标签页内链权重布局:聚合标签页内链权重布局实战
- 百度API主动推送与快速收录配置:搞定百度API主动推送与快速收录
- Google Search Console抓取错误修复:GSC抓取错误实战排查与修复