
恶意爬虫拦截与服务器防刷策略:恶意爬虫拦截与服务器防刷实战
搞恶意爬虫拦截与服务器防刷策略,千万别指望一个 robots.txt 就能让对方良心发现,最行之有效且成本最低的打法是分层绞杀:边缘层挡死脚本特征、Nginx 层掐死高频并发、应用层设蜜罐与行为验签,把绝大部分垃圾流量直接摁死在到达业务代码之前。
很多团队服务器 CPU 飙到 100%、数据库连接池爆满,排查半天发现全是同行拿着几十块钱买的动态代理池在硬刷接口。防御这玩意儿不是靠单一手段,而是一场成本对抗。我们的目标不是追求 100% 的绝对防御,而是把对方的抓取成本拉高到他自己主动放弃。
核心方案速览
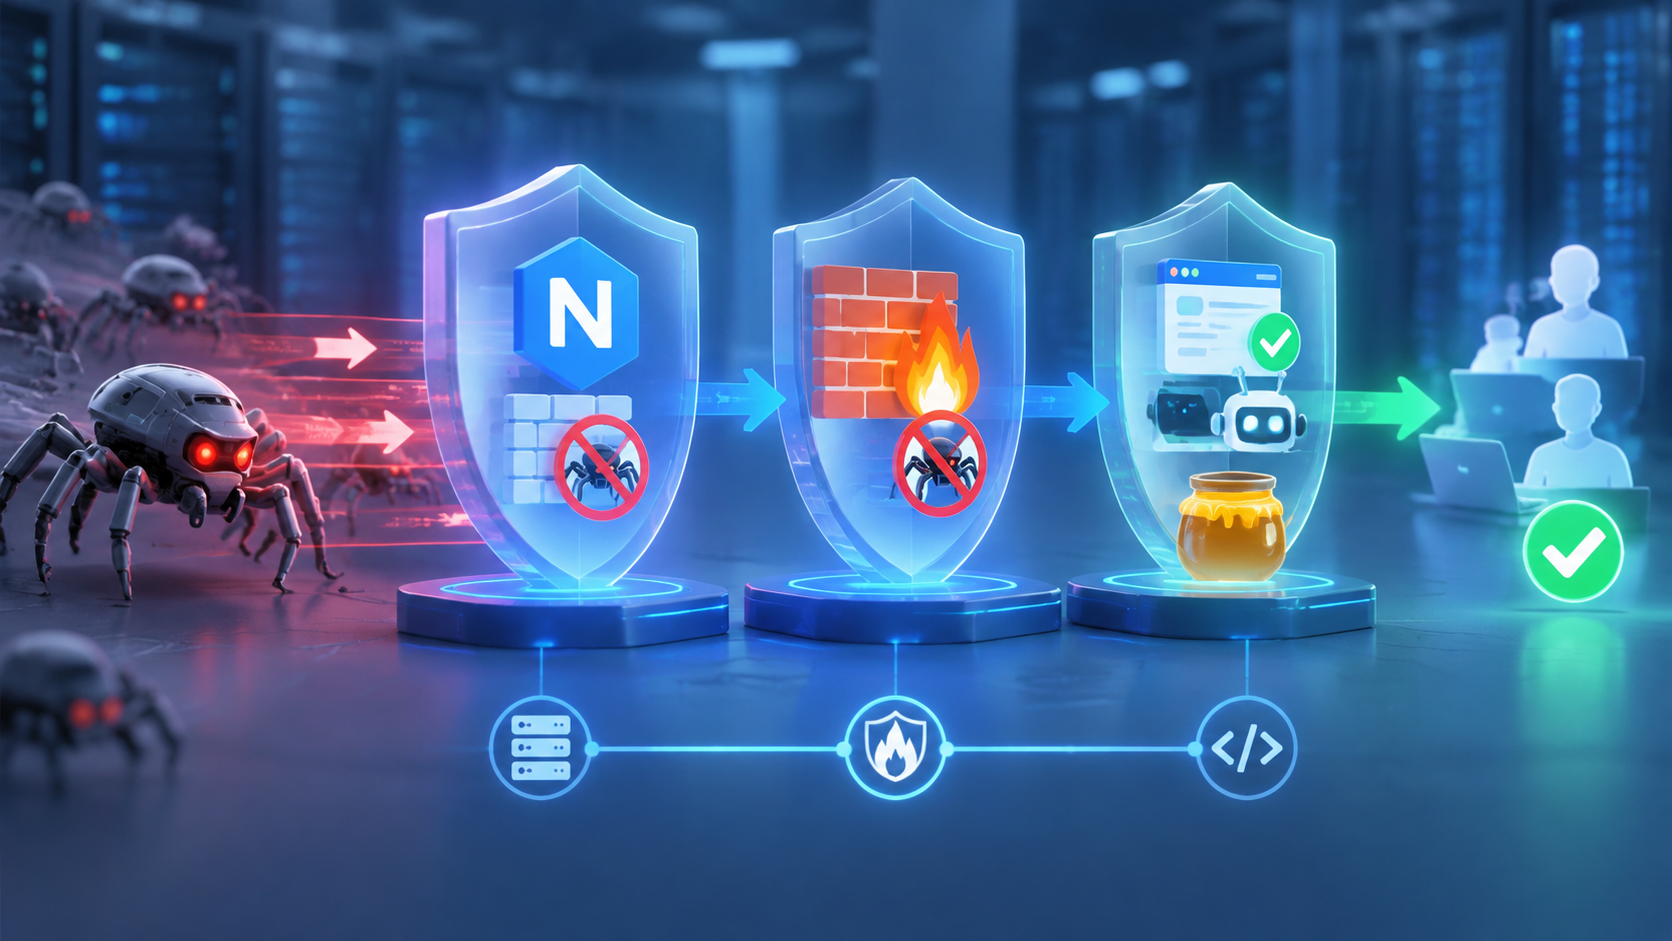
一套能打的防御矩阵,必须按照流量进入的路径层层设卡:
- 第一道坎(网关/Nginx 层):封死空 UA、Python-requests、Scrapy 等原生特征,利用
limit_req对 IP 和接口维度做速率硬限制。 - 第二道坎(系统/防火墙层):利用 Fail2ban 监控访问日志,对高频触发 403、404 或特定限流状态码的恶意 IP,直接调用
iptables丢进黑名单关禁闭。 - 第三道坎(应用/前端层):部署隐藏“蜜罐”链接,前端对关键 API 引入动态签名,结合 Turnstile 等轻量人机验证阻断自动化脚本。
实操细节深度拆解
1. Nginx 暴力限频与指纹快速绞杀
别等流量打到 PHP/Java/Node 进程里才去校验,直接在 Nginx 层面丢弃。以下这套配置属于生产环境拿来即用的基础防御模版:
# 放在 http 块中
# 定义限流空间:10MB 内存大约能存 16 万个 IP,每个 IP 每秒允许 5 个请求
limit_req_zone $binary_remote_addr zone=anti_spider:10m rate=5r/s;
# 定义敏感接口(如搜索、详情页)限流空间:每秒 1 个请求
limit_req_zone $binary_remote_addr zone=strict_api:10m rate=1r/s;

# 屏蔽低级扫描器与常见脚本 UA
map $http_user_agent $bad_client {
    default 0;
    ~*curl|wget|python|scrapy|httpclient|java|aiohttp 1;
    "" 1; # 空 UA 直接算作恶意
}

server {
    listen 80;
    server_name example.com;

    # 1. 命中恶意 UA 直接返回 403,不给任何反应时间
    if ($bad_client) {
        return 403;
    }

    # 2. 全站常规限流
    location / {
        # burst=10 允许应对正常突发,nodelay 保证突发请求立即处理,超过直接 503
        limit_req zone=anti_spider burst=10 nodelay;
        limit_req_status 429; # 别用默认的 503,返回 429 方便后续分析

        proxy_pass http://backend_upstream;
    }

    # 3. 核心查询/敏感数据接口单独做更严苛的限制
    location /api/v1/search {
        limit_req zone=strict_api burst=2 nodelay;
        limit_req_status 429;
        proxy_pass http://backend_upstream;
    }
}- 适用场景:单机防御、中小规模站点抵御工具党扫描、无脑多线程爬取。
- 避坑点:
burst参数必须加,不加burst会导致正常用户点击快一点就被抛弃;状态码建议改为429 Too Many Requests,不要用默认的503,否则在监控报警时很难区分是后端宕机了还是触发了限频。
2. Fail2ban + Iptables 自动化封杀 IP
光返回 429 还是会占用服务器 TCP 连接。既然对方已经触发了限流,说明不是正常访客,直接用 Fail2ban 抓取 Nginx 日志,联动系统防火墙在内核层把 IP 给 DROP 掉。
第一步:定义抓取规则
在 /etc/fail2ban/filter.d/nginx-anti-crawl.conf 创建规则:
[Definition]
# 匹配 Nginx 日志中返回 429 或者是访问特定被禁路径的日志
failregex = ^<HOST> -.*"(GET|POST|HEAD).*" 429
ignoreregex =
第二步:配置防护 Jail
在 /etc/fail2ban/jail.local 中激活:
[nginx-crawl-ban]
enabled  = true
port     = http,https
filter   = nginx-anti-crawl
logpath  = /var/log/nginx/access.log
maxretry = 30        # 1 分钟内触发 30 次 429
findtime = 60        # 统计时间窗口 60 秒
bantime  = 86400     # 封禁 24 小时
action = iptables-multiport[name=NoSpider, port="http,https"]- 适用场景:自建机房、无高防 CDN 的单台或集群主机,对付顽固高频 IP。
- 避坑点:如果前置了 CDN(如 Cloudflare),
logpath里的 IP 必须是获取到的真实访客 IP(即通过 Nginx 的real_ip模块将$http_x_forwarded_for映射为真实地址),否则 Fail2ban 会把 CDN 节点的 IP 给封死,导致整个站点瘫痪。
3. 应用层设蜜罐(Honeypot)与主动诱捕
商业级爬虫通常会买动态代理,IP 随时换,甚至自动绕过 Nginx 的频率限制。这时在应用层放诱饵是最有效的手段。
在页面 HTML 中悄悄塞一个对人不可见、但爬虫解析 DOM 必爬的隐藏链接:
<!-- 给正常用户隐藏,爬虫如果只解析 HTML 标签则一定会抓取 -->
<div style="display:none;" aria-hidden="true">
    <a href="/internal-metrics-system/health-check" rel="nofollow">运维监控节点</a>
</div>
然后在服务端实现该接口的逻辑:
# FastAPI / Flask 伪代码示例
@app.get("/internal-metrics-system/health-check")
def honeypot_trap(request: Request):
    client_ip = request.client.host

    # 1. 记入 Redis 黑名单,设置过期时间 12 小时
    redis_client.setex(f"blacklist:{client_ip}", 43200, "honeypot_triggered")

    # 2. 调用系统命令或者发异步任务,直接把 IP 推给堡垒机/防火墙阻断
    logger.warning(f"蜜罐命中!捕获恶意爬虫 IP: {client_ip}")

    # 3. 故意返回虚假的 200 或无限挂起延迟响应(消耗它的连接池)
    time.sleep(5)
return {"status": "ok", "code": 200}- 适用场景:防范抓取全站数据的深度爬虫、页面数据采集工具。
- 避坑点:蜜罐链接千万不要加入到站点地图(sitemap.xml)中,并确保该链接被
robots.txt明确禁止。既然在robots.txt里声明了禁止访问,对方还是强行请求,那就是非正常爬虫无疑,封杀完全不用心软。
高频关联问题拓展
Q1:对方伪造百度、谷歌蜘蛛的 User-Agent 怎么办?
很多写脚本的特别喜欢把 UA 伪装成 Mozilla/5.0 (compatible; Baiduspider/2.0...) 来骗过基础规则。千万不要只根据 UA 字符串就放行流量。
解决办法:对宣称是主流搜索引擎的请求做反向 DNS 查询(rDNS)。
以 Google 蜘蛛为例,先拿 IP 反查域名,其域名后缀必须是 .googlebot.com 或 .google.com,接着再用这个域名去正向解析一次,看得到的 IP 是否和来访 IP 完全一致。如果在链路中觉得每次实时 DNS 查询太慢,可以提前把各大主流搜索引擎公布的官方 IP 网段刷入 Nginx 的白名单中(如通过 geo 模块),其余打着搜索引擎旗号却不在网段内的,一律按流氓爬虫处理。
Q2:面对海量住宅代理 IP(动态代理池),IP 封禁彻底失效怎么破?
现在的灰产爬虫人手一个隧道代理池,一个请求换一个 IP,限制单个 IP 的频次毫无作用。
解决办法:
- 废黜纯 IP 逻辑,转向会话/指纹识别:结合前端生成设备指纹(Canvas 指纹、WebGL 指纹、音频指纹),用指纹作为频控主键。
- 阻断无头浏览器(Headless Chrome):检测自动化特征,比如
navigator.webdriver属性。 - 关键接口上轻量验证:对敏感数据接口引入无感的人机验证(例如 Cloudflare Turnstile 或极验),不用拼图,正常用户点击无感知即可通过,但能让 95% 的自动化抓取框架成本剧增。
- 前端接口加动态时间戳签名:接口参数附带
_sign = md5(timestamp + path + salt),前端代码混淆,让爬虫必须逆向 JS 逻辑才能组装合法请求,直接劝退大部分初级外包。
总结
做好恶意爬虫拦截与服务器防刷策略的核心思想,永远是“把过滤成本留给自己最低的层级,把破解成本留给对方最高的一侧”。
不要一上来就在业务逻辑代码里写一堆花哨的算法,那只会拖垮你的后端。优先用 Nginx/网关层把那些连特征都懒得改的无脑脚本拍死在门外;再用蜜罐和 Fail2ban 自动化踢掉伪装度一般的爬虫;最后留给应用层的,就只剩核心接口的签名混淆与人机交互验证。把这条防线立起来,服务器的负载和带宽成本立刻就能降下大半。
相关文章
- 长尾关键词挖掘实操:自动化挖掘长尾词的实操打法
- 落地页转化漏斗优化:落地页转化漏斗优化实操指南
- 全站死链排查与404重定向:全站死链清洗与404重定向实操
- CDN缓存命中率调优:CDN缓存命中率拉满实战
- Core Web Vitals性能达标方案:Core Web Vitals实操达标方案
- 网站TTFB首字节耗时排查:网站TTFB首字节耗时排查实战
- 恶意爬虫拦截与服务器防刷策略:恶意爬虫拦截与服务器防刷实战
- 聚合标签页内链权重布局:聚合标签页内链权重布局实战
- 百度API主动推送与快速收录配置:搞定百度API主动推送与快速收录
- Google Search Console抓取错误修复:GSC抓取错误实战排查与修复