
网站TTFB首字节耗时排查:网站TTFB首字节耗时排查实战
网站TTFB首字节耗时过长,90%的情况下根本不是前端打包或者资源体积的问题,问题全在动态后端计算慢(数据库慢查询/PHP阻塞)、Nginx未开启静态缓存或上游连接复用、以及DNS与TLS握手延迟过高这三件事上。
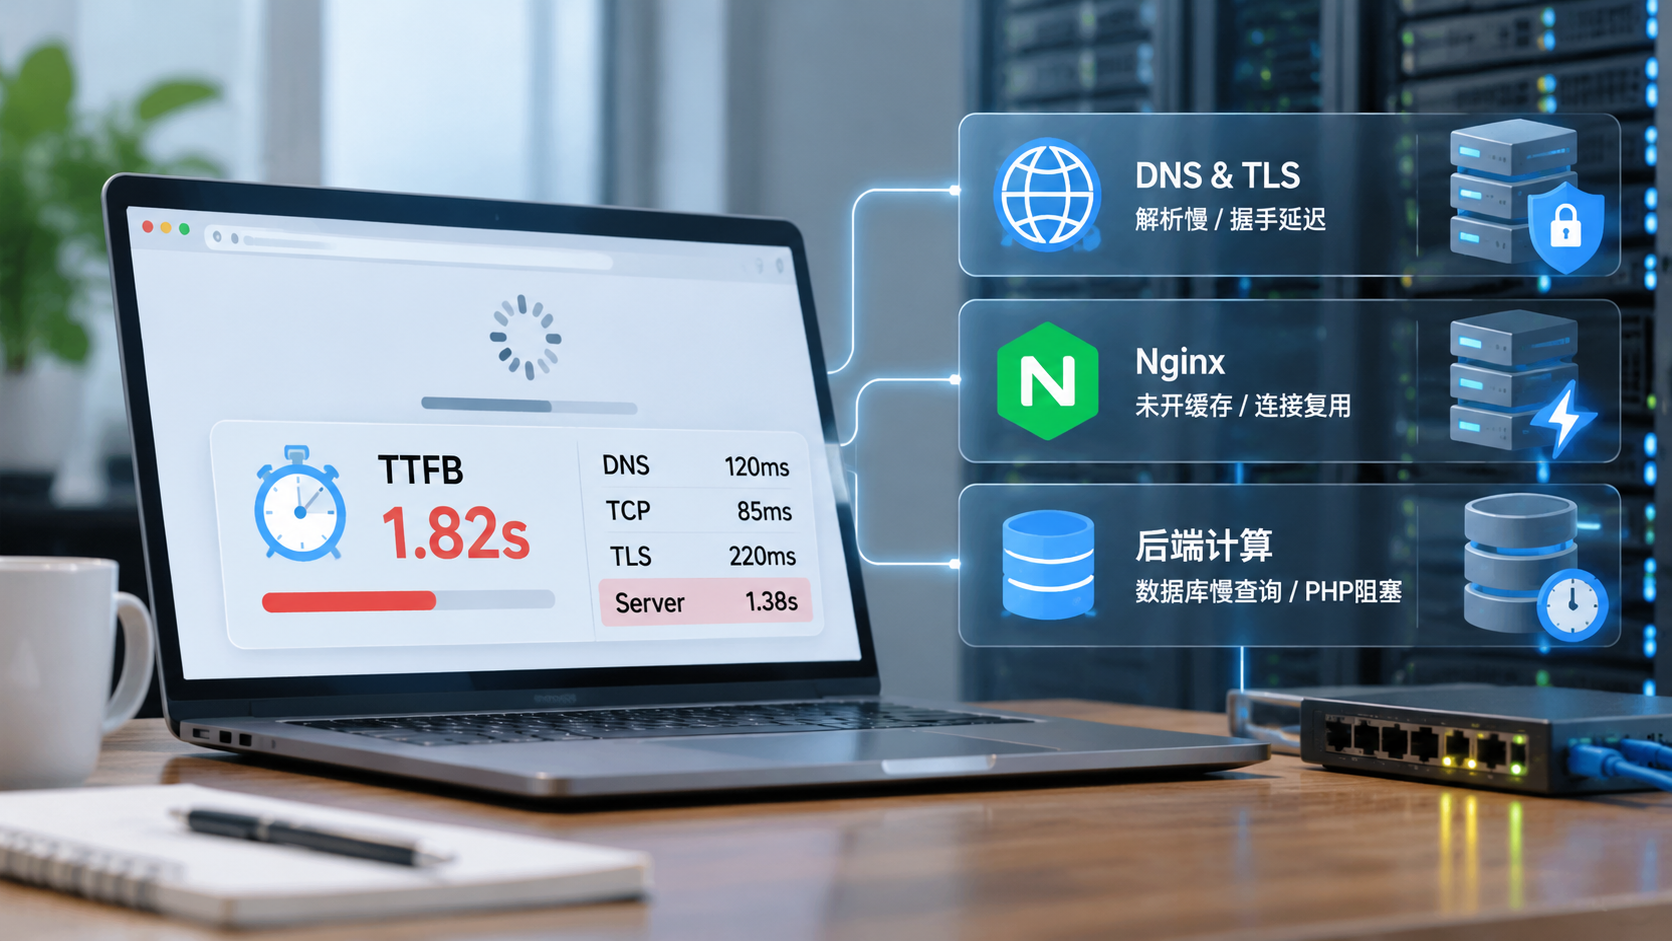
别一看到页面打开慢就忙着压缩图片、拆JS代码包,那些只能救FCP(首次内容绘制)和LCP(最大内容绘制);如果你的TTFB(Time to First Byte)卡在800ms甚至2秒以上,浏览器连HTML文档的头都没拿到,前端做再多优化全是在白费力气。
核心排查链路速览
遇到网站TTFB首字节耗时异常飙高,按照以下漏斗链路逐层剥离,绝不瞎猜:
- 测定纯网络握手成本:剥离DNS解析、TCP连接、SSL握手时间,拿到服务端的“纯反应时间”。
- 区分静态与动态资源:静态HTML/文件慢,查CDN边缘节点与Nginx文件缓存;动态接口慢,查应用进程与数据库。
- 查应用层慢查询与代码阻塞:打开PHP慢日志/Node.js APM,看数据库执行时间和外部API调用。
- 查网关反代与连接池:排查Nginx反向代理到Upstream时是否使用了短连接、是否开启了Proxy Buffering。
实操细节深度拆解
第1步:用一段 cURL 脚本剥离网络层噪音
别只用 Chrome 的 DevTools 测 TTFB,本地网络波动、浏览器扩展、本地缓存都会干扰数据。直接上服务器或本地终端执行以下命令,用最客观的底层时序定位问题:
curl -o /dev/null -s -w "\
HTTP状态码: %{http_code}\n\
DNS解析耗时: %{time_namelookup}s\n\
TCP握手耗时: %{time_connect}s\n\
SSL完成握手: %{time_appconnect}s\n\
准备传输耗时: %{time_pretransfer}s\n\
TTFB首字节耗时: %{time_starttransfer}s\n\
总传输耗时: %{time_total}s\n" \
https://你的域名.com/目标路径
诊断标准与结论:
time_namelookup超过 100ms:DNS解析服务商拉胯,赶紧切 Cloudflare、DNSPod 或阿里云解析,换 Anycast DNS。time_appconnect明显大于time_connect的两倍:SSL证书链过长、未开启 TLS 1.3,或者服务端未开启 Session Resumption(会话复用)。time_starttransfer减去time_pretransfer的差值很大(比如差了0.8秒):这是最关键的指标,说明网络握手早就完成了,服务器的后端程序卡了0.8秒才吐出第一个字节。责任100%在服务端逻辑或网关层。
第2步:网关层优化(Nginx 必改的几处死穴)
很多运维图省事,Nginx配个最基础的 proxy_pass 就完事了。动态请求转发到后端(PHP-FPM、Gunicorn、Node、Tomcat)时,默认可能每来一个请求就建一次 TCP 握手,白白吃掉几十毫秒。
1. 开启 Upstream 长连接(Keepalive)
这是降低内网反代TTFB耗时最立竿见影的配置。
upstream backend_server {
    server 127.0.0.1:8080;
    # 必须显式保持连接池大小,根据并发量调整
    keepalive 32;
}

server {
    listen 443 ssl http2;
    server_name example.com;

    location / {
        proxy_pass http://backend_server;

        # 必须强制指定 HTTP/1.1,默认的 1.0 不支持长连接
        proxy_http_version 1.1;
        proxy_set_header Connection "";

        # 缓冲设置:避免后端服务被慢客户端拖死
        proxy_buffering on;
        proxy_buffer_size 4k;
        proxy_buffers 8 32k;
        proxy_busy_buffers_size 64k;
    }
}
2. SSL/TLS 握手极致压榨
握手延迟直接叠加在TTFB上。打开会话复用和 TLS 1.3:
# 启用 TLS 1.3
ssl_protocols TLSv1.2 TLSv1.3;

# 开启 SSL 会话缓存,避免每次都重新协商对称秘钥
ssl_session_cache shared:SSL:10m;
ssl_session_timeout 1d;
ssl_session_tickets on;

# 开启 OCSP Stapling,省去客户端验证证书有效性的网络往返
ssl_stapling on;
ssl_stapling_verify on;
resolver 8.8.8.8 1.1.1.1 valid=300s;
resolver_timeout 5s;
第3步:应用与数据库层排查(代码为什么吐不出字节)
当通过 cURL 确认服务端计算耗时占了大头后,排查重点立刻切到后端。
场景A:PHP 应用(WordPress / Laravel 等)
绝大多数个人站长和内容站的 TTFB 爆炸都源于此。PHP 是同步阻塞执行的,必须全部跑完逻辑才开始输出。
-
开启 PHP-FPM 慢日志: 在
php-fpm.d/www.conf中配置:request_slowlog_timeout = 1s slowlog = /var/log/php-fpm/slow.log只要 TTFB 超过1秒,去翻
slow.log,里面会精确打印出卡在哪个文件的哪一行(通常是mysqli_query或者是调用了某个外部不可达的第三方 API)。 -
暴力且有效的手段:加缓存层 如果是内容类站点,动态请求每次查库拼装完全是浪费资源。 直接在 Nginx 层给动态请求上 FastCGI Cache,让 TTFB 从 800ms 直降到 15ms:
# 定义缓存路径 fastcgi_cache_path /dev/shm/nginx_cache levels=1:2 keys_zone=WORDPRESS:100m inactive=60m max_size=1g; fastcgi_cache_key "$scheme$request_method$host$request_uri"; server { ... location ~ \.php$ { fastcgi_pass unix:/run/php/php8.2-fpm.sock; fastcgi_index index.php; include fastcgi_params; # 开启缓存 fastcgi_cache WORDPRESS; fastcgi_cache_valid 200 301 302 10m; fastcgi_cache_use_stale error timeout updating invalid_header http_500; add_header X-Cache-Status $upstream_cache_status; } }避坑点:登录用户、带特定 Cookie 的后台管理请求必须通过
fastcgi_cache_bypass绕过,否则会出现全站串号、后台无法登录的严重故障。
场景B:Node.js / Python / Go 等常驻进程应用
- Node.js 单线程 Event Loop 阻塞:
查代码里有没有大规模的 JSON 序列化/反序列化(例如处理超大配置文件)、密集的同步加密算法,或者直接跑了类似
fs.readFileSync的死锁代码。 - 连接池耗尽: 检查数据库连接池配置。并发稍高时,后端处理请求不是在计算,而是在排队等待获取数据库连接实例,导致首字节输出无限期后延。
高频关联问题拓展
坑点1:加了 CDN 之后,TTFB 反而从 50ms 暴涨到 600ms?
这是典型“负优化”翻车现场,重点查两点:
- 缓存未命中(Cache MISS)导致的回源放大:动态请求本就无法被 CDN 缓存,客户端请求先到 CDN 节点,CDN 节点再跟你的源站建立 TCP 握手并回源请求数据,链路直接长了一倍。针对全动态接口,直接在 CDN 配置规则:指定接口或路径不走 CDN 代理,或者开启纯网络层 TCP/TLS 动态加速。
- CDN 节点到源站未开启 HTTP Keep-Alive:很多国内云厂商的 CDN 默认回源是短连接,每次回源都拉起一次全套握手,必须在控制台把“回源长连接”强制打开。
坑点2:高并发下平时 TTFB 挺好,流量一冲瞬间崩掉
这通常是由于全链路资源队列积压:
- Linux 连接队列溢出:查看系统日志
dmesg是否出现TCP: request_sock_TCP: Possible SYN flooding on port 80. Dropping request.。需要调整内核参数:sysctl -w net.core.somaxconn=65535 sysctl -w net.ipv4.tcp_max_syn_backlog=65535 - Nginx worker_connections 满载:检查
error.log有无worker_connections are not enough报错,适度提高并发限制并开启multi_accept on;。
总结
排查网站TTFB首字节耗时不要凭感觉瞎碰。先用终端 cURL 命令拆解网络各阶段开销,只要确认握手时间没问题,核心矛盾就必然锁定在服务端的动态代码执行效率、数据库I/O堵塞和网关反代调度上。
先把 TLS 1.3、Nginx Upstream 长连接和会话复用配齐,把该省的网络握手挤干;再通过慢日志抓出拖后腿的慢查询与外部依赖调用。如果是纯内容站,果断上 FastCGI Cache 或 Redis 页面缓存,把原本由 CPU 计算的逻辑转化为内存读取,TTFB 压进 50ms 并不是难事。
相关文章
- 长尾关键词挖掘实操:自动化挖掘长尾词的实操打法
- 落地页转化漏斗优化:落地页转化漏斗优化实操指南
- 全站死链排查与404重定向:全站死链清洗与404重定向实操
- CDN缓存命中率调优:CDN缓存命中率拉满实战
- Core Web Vitals性能达标方案:Core Web Vitals实操达标方案
- 网站TTFB首字节耗时排查:网站TTFB首字节耗时排查实战
- 恶意爬虫拦截与服务器防刷策略:恶意爬虫拦截与服务器防刷实战
- 聚合标签页内链权重布局:聚合标签页内链权重布局实战
- 百度API主动推送与快速收录配置:搞定百度API主动推送与快速收录
- Google Search Console抓取错误修复:GSC抓取错误实战排查与修复