
SEO诊断报告解读教程:彻底读懂SEO诊断报告实战指南
拿到一份SEO诊断报告解读时,别去看那些动辄上百页的花哨图表和打分,直接按“抓取-索引-渲染-排名”四个底核指标反推问题,因为市面上80%的第三方工具报告充斥着无意义的机械报警,优先修复阻断性技术Bug才能真正救命。
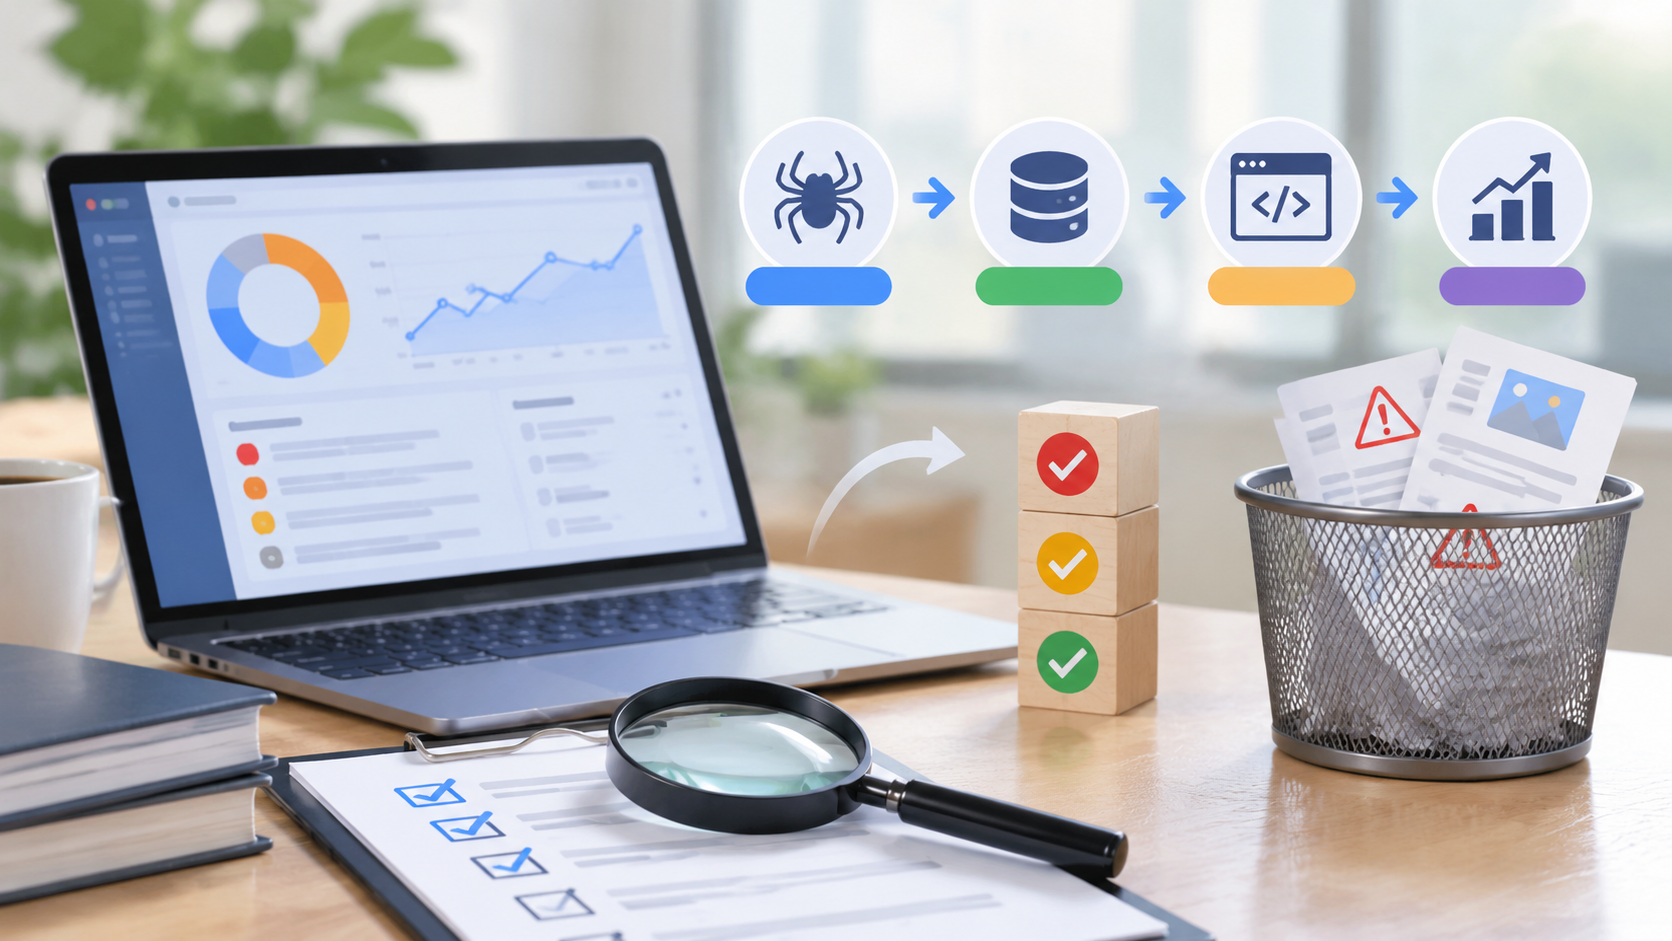
很多外包公司或自动化SaaS扫描出来的报告,动不动给你整出几万个“严重错误”,定睛一看全是“图片缺少Alt标签”、“Meta Description微量超长”这种细枝末节。如果你被这些流水线垃圾信息牵着鼻子走,折腾两周改了几千个页面,流量依旧是一潭死水。读报告的本质,是在噪音里找致命伤。
核心方案速览:三级过滤法
看任何SEO诊断报告,直接建立优先级过滤器,不要从第一页顺着读:
| 优先级 | 涵盖核心指标 | 典型致命症状 | 处理动作 |
|---|---|---|---|
| P0(致命阻断) | HTTP状态码、Robots协议、Canonical规范、无意间加的noindex | 批量5xx报错、全站被robots屏蔽、死循环重定向、主域自杀式Canonical | 24小时内拉研发或运维当场改配置上线 |
| P1(流通受阻) | 抓取预算耗尽、JS客户端渲染白屏、核心Web指标(LCP/CLS)极差 | 分页URL参数无限增生、TTFB超过2秒、SPA页面Googlebot抓不到内容 | 优化Nginx缓存、调整路由与动态渲染、重构内链网络 |
| P2(权重损耗) | 404死链、标题重复、H1缺失、内容空洞(Thin Content) | 大量过时页面占着索引坑位、全站TDK模板千篇一律 | 批量301合并权重、清理废弃URL、重写核心商用词页面 |
实操细节深度拆解:拆穿报告里的四个谎言
1. 抓取与状态码:别信爬虫工具的“静态模拟”
报告里往往有张饼图,告诉你“全站状态码分布”,比如标出几百个4xx或5xx错误。
避坑实操: 第三方工具(如Ahrefs、Semrush或本地跑的Screaming Frog)是拿它们自己的IP去爬你的站,遇到反爬机制(如Cloudflare的WAF、Nginx频率限制)时,报出来的403/503根本不是搜索引擎蜘蛛的真实反馈。
排查方案: 抛弃报告里的模拟数据,直接连服务器去挖真实的Nginx访问日志。使用以下Shell命令过滤真Googlebot或百度蜘蛛的状态码分布:
# 过滤Googlebot的抓取状态码并统计数量(假设日志格式为标准combined)
grep -i "Googlebot" /var/log/nginx/access.log | awk '{print $9}' | sort | uniq -c | sort -rn

# 揪出所有让蜘蛛吃到500错误的动态路由URL
grep -i "Googlebot" /var/log/nginx/access.log | awk '($9 ~ /^5/)' | awk '{print $7}' | head -n 20
如果报告中提示有“重定向链(Redirect Chains)”,必须直接用 curl 抓底层响应头核对,切忌拿浏览器直接点:
# 追踪重定向链路,观察每一步的跳转状态码与目标URL
curl -sIL -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://example.com/old-page
一旦发现类似 http -> https -> 带斜杠 -> 终极页面 的三次跳转,直接在Nginx层用正则重写一步到位,省下宝贵的抓取预算:
# 踩坑优化:避免多次重定向,全站强制301合流
if ($scheme = http) {
    return 301 https://$host$request_uri;
}
2. 索引控制与规范标签:杀死“软404”与“参数黑洞”
报告中出现“重复内容过多(Duplicate Content)”时,绝大部分不是抄袭问题,而是系统的URL设计缺陷。
深度排查与配置:
电商或筛选列表页通常会带一堆参数(如 ?sort=price&color=red),爬虫会把每一个参数组合当成全新页面抓取。如果报告提示参数URL数量失控,查看页面头部是否缺了规范链接(Canonical URL)。
正确的标准头部代码必须具备唯一指向性:
<!-- 在所有带参数变体的列表页中,强制指向静态主路由 -->
<link rel="canonical" href="https://example.com/category/shoes" />更阴险的问题是“软404(Soft 404)”:页面内容明明写着“抱歉,该商品已下架”或者“找不到对应内容”,但服务器HTTP状态码却返回了 200 OK。报告常把它归类为“低质量页面”。
解决方案:下架或无内容页面,直接在应用层抛出明确的 404 或 410 Gone(表示永久下线不再恢复),别给蜘蛛留念想:
// Node.js Express 场景下明确抛出 404
if (!productExists) {
  res.status(404).render('404-page');
  return;
}
3. 渲染性能:区分“人看的快”和“爬虫看的全”
很多报告把“Google PageSpeed Insights”跑分当圣旨,90分以下就大惊小怪。别被跑分忽悠,搞清楚TTFB(首字节时间)与客户端渲染的区别。
关键排查:单页应用(SPA)是否给蜘蛛递了白板?
Vue/React开发的前端,如果在诊断报告里发现“页面字符数极少(Word count < 100)”且“缺少内链”,十有八九是搜索引擎根本没执行你的JS脚本,抓回去的只有一个 <div id="app"></div>。
验证方法: 使用本地终端直接模拟Googlebot下载初始HTML,看里面到底有没有实质内容:
curl -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://example.com/product/123 | grep "核心商品标题"如果搜不出内容,报告上所有的SEO优化建议都是扯淡。解决路径只有两条:
- 彻底重构为SSR(服务端渲染):如迁移至 Next.js / Nuxt.js。
- 边缘动态渲染(预渲染方案):在Nginx或Cloudflare Workers上拦截蜘蛛User-Agent,反向代理到无头浏览器服务(如Prerender.io)输出纯静态HTML。
简易Nginx预渲染配置段落:
location / {
    set $prerender 0;
    if ($http_user_agent ~* "googlebot|bingbot|baiduspider|yandex") {
        set $prerender 1;
    }
    if ($args ~ "_escaped_fragment_") {
        set $prerender 1;
    }

    if ($prerender = 1) {
        # 命中蜘蛛,代理到内网的 Headless Chrome 渲染集群
        rewrite .* /render?url=https://$host$request_uri break;
        proxy_pass http://127.0.0.1:3000;
    }

    # 正常用户走原有静态资源或前端单页应用
    try_files $uri $uri/ /index.html;
}
4. 结构化标记与TDK:别堆砌,要连贯
报告中关于“缺少H1”或者“Meta Title重复”的报警往往数以万计。不要人肉去改,写脚本分析规律批量处理。
清洗与自动化套路: 使用一段轻量Python脚本配合BeautifulSoup,在发版前快速跑一遍核心模板的TDK和结构化数据提取,别等诊断报告找上门:
import requests
from bs4 import BeautifulSoup

def verify_page_seo(url):
    headers = {'User-Agent': 'Mozilla/5.0 (compatible; Googlebot/2.1;)'}
    resp = requests.get(url, headers=headers, timeout=5)
    soup = BeautifulSoup(resp.text, 'html.parser')

    title = soup.title.string if soup.title else None
    h1 = [h.get_text(strip=True) for h in soup.find_all('h1')]
    canonical = soup.find('link', rel='canonical')

    print(f"URL: {url}")
    print(f"Title: {title}")
    print(f"H1 Count: {len(h1)} | Values: {h1}")
    print(f"Canonical Target: {canonical['href'] if canonical else 'MISSING'}")

    # 诊断断言
    if len(h1) != 1:
        print("[!] 警告: H1标签必须且仅能存在一个,严禁模板套用多个")

# 本地自测
verify_page_seo("https://example.com/article/demo")
高频关联问题拓展:报告之外的真实博弈
Q1:报告显示几万条“Thin Content(低质量内容)”,要全部删掉吗?
千万别一刀切全删。大量的404会导致搜索引擎降低整站爬取频次。
- 有流量或外链历史的页面:做301重定向映射到相近主题的高价值页面。
- 纯粹由筛选产生、无搜索需求的垃圾页面:直接在页面头部追加
<meta name="robots" content="noindex, follow" />,让蜘蛛保留爬取内部链接的能力,同时退出索引库,干净利落。
Q2:工具打分高达95分,为什么核心关键词排名还在掉?
技术SEO诊断报告只管“路通不通”,不管“车里装的是不是黄金”。 打分高只代表你的网站结构没有明显的爬取技术阻碍(如同铺好了柏油路)。如果排名持续下滑,必须跳出这份诊断报告,去看 Google Search Console 的点击率(CTR)和用户停留交互信号,大概率是页面内容与搜索意图脱节,或者是竞对拿到了更高质量的实体反向链接。
Q3:移动端和PC端在报告中数据脱节,以哪个为准?
无脑以移动端为准。各大主流搜索引擎早已全面推行移动优先索引(Mobile-First Indexing)。如果诊断报告里PC端体验完美,而移动端LCP超过4秒、文字重叠、或者CSS/JS被移动端特定的媒体查询屏蔽,那么PC端的分数毫无意义。
结尾总结
读懂一份SEO诊断报告解读的核心逻辑在于做减法。别去修补那些不痛不痒的格式细节,先把眼光钉死在底层链路:日志里蜘蛛抓得顺不顺、核心业务页是否正确返回200与Canonical、JS渲染后内容是否赤裸呈现给爬虫。搞定这三件事,直接解决80%的技术瓶颈,剩下的所谓“警告”大可以当成背景噪音,分批次视人力成本再做优化。工具只负责报出症状,而真正的架构师负责判定哪个症状才会致命。