
新站每日更新数量建议:新站每天更新多少文章最划算?
关于新站每日更新数量建议,最干脆的核心结论是:精品垂直站每天固定更新2-5篇,AI辅助半自动化站每天10-20篇,纯采集/垃圾站群每天50篇以上——决定收录和权重的从来不是单日爆发力,而是持续稳定的更新节奏与内容质量。
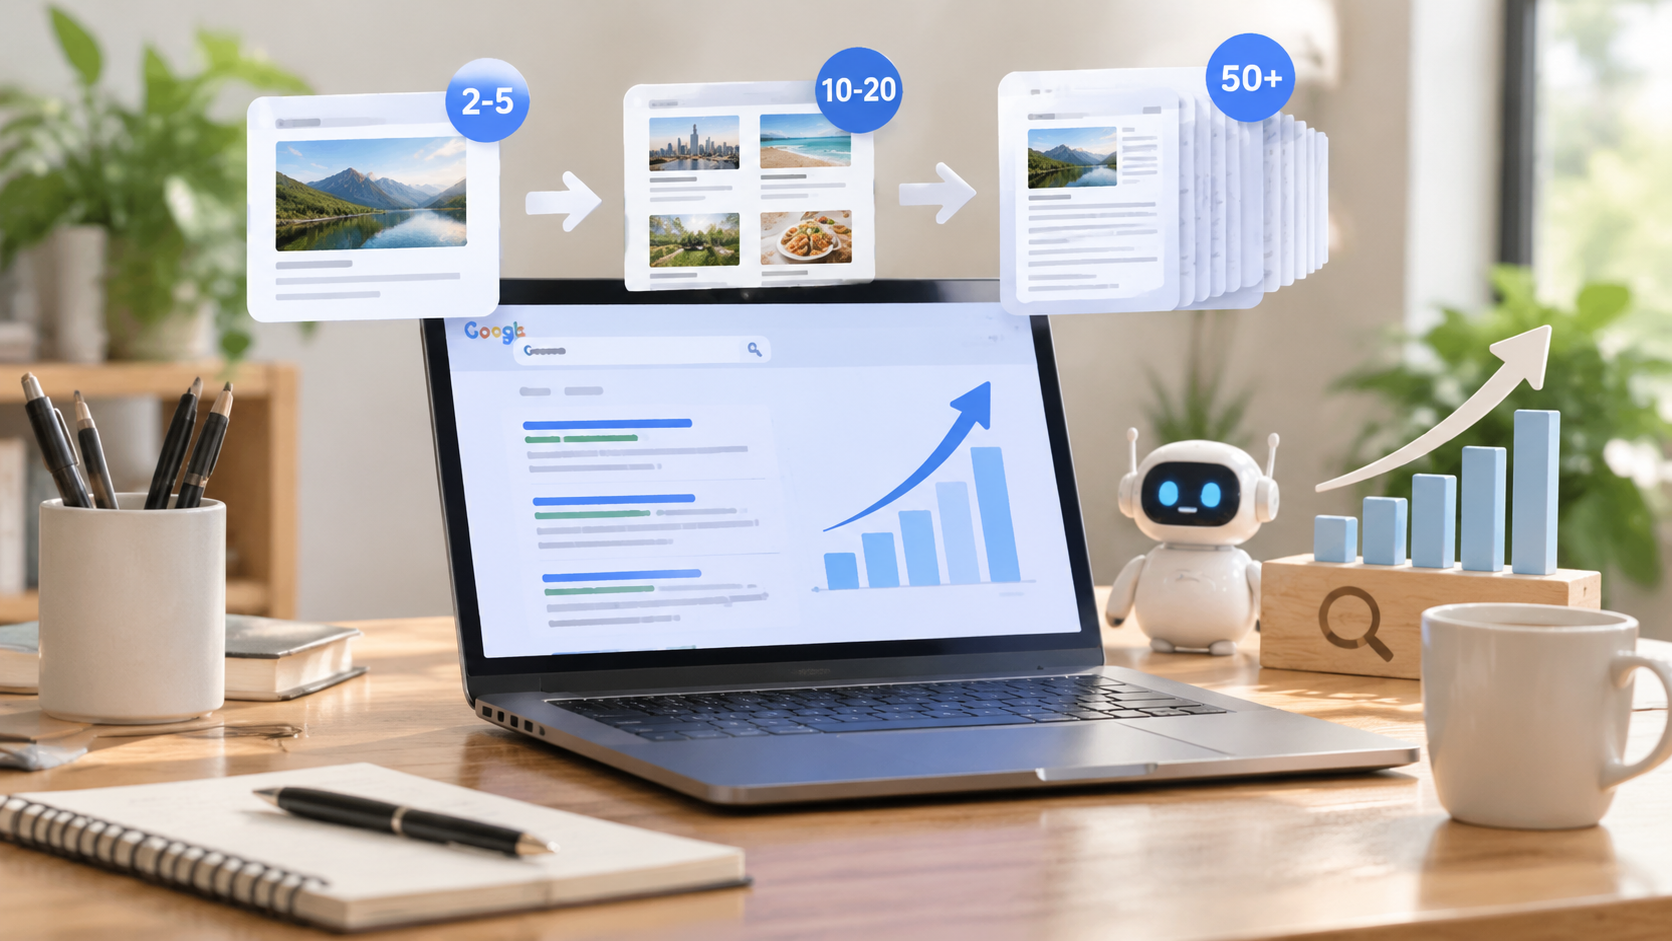
千万别听某些卖课的扯什么“新站必须一天发一百篇才能快速过沙盒”,也别信“一周写一篇精美文章就能自然爆流量”。搜索引擎爬虫(蜘蛛)对新站有一个基础的考核期(沙盒期),在服务器资源和抓取配额(Crawl Budget)极其有限的情况下,盲目堆砌数量只会加速网站被判为垃圾站(Spam),而更新太慢又无法激活蜘蛛的定时抓取机制。
核心方案速览
不同建站目的与运营模式下的新站每日更新数量建议配比表:
| 网站类型 | 每日建议更新量 | 内容产生方式 | 核心指标与策略 | 适用场景 |
|---|---|---|---|---|
| 精品垂直站/企业官网 | 2 - 5 篇 | 手写/深度Rewrite | 解决具体问题,排版精美,内链严谨 | 品牌站、垂直行业博客、高客单价服务站 |
| AI辅助半自动化站 | 10 - 20 篇 | AI生成 + 人工微调 | 批量覆盖长尾词,统一Markdown格式 | 资讯站、工具教程站、Affiliate导购站 |
| 海量采集/无人值守站 | 50 - 200 篇 | 接口采集/大模型纯自动 | 拼收录概率,拼域名基数(随时准备被K) | 流量劫持、泛目录、自动化广告站 |
实操细节深度拆解
1. 抓取配额机制:为什么不能“一天打鱼三天晒网”?
蜘蛛抓取新站是给配额的。一个新上线域名,搜索引擎给的日抓取频次可能只有个位数。
- 错误示范:第一天上线狂发100篇文章,随后整整两周不更新。蜘蛛第一天抓了5篇,第二天发现没更新,第三天缩减抓取频次,后续你的文章就算发出去,蜘蛛也懒得来。
- 正确做法:使用宝塔面板的计划任务或WordPress定时发布功能,平滑发布。
自动化定时发布脚本(Python + WordPress REST API)
如果你是用Python配合大模型批量生成内容,切记不要一次性全部写入数据库并设置为已发布。以下是通过WordPress官方API实现定时排期发布的实操代码:
import requests
from datetime import datetime, timedelta

# WordPress 配置
WP_URL = "https://yourwebsite.com/wp-json/wp/v2/posts"
USERNAME = "your_admin_username"
APPLICATION_PASSWORD = "your_app_password_here"  # 在WP后台用户-应用密码处生成

def post_article_scheduled(title, content, category_id, delay_hours):
    # 计算未来发布时间 (UTC时间)
    publish_time = (datetime.utcnow() + timedelta(hours=delay_hours)).strftime('%Y-%m-%dT%H:%M:%S')

    headers = {
        "Content-Type": "application/json"
    }

    data = {
        "title": title,
        "content": content,
        "status": "future",  # 设置为定时发布状态
        "date": publish_time,
        "categories": [category_id]
    }

    response = requests.post(
        WP_URL,
        json=data,
        auth=(USERNAME, APPLICATION_PASSWORD),
        headers=headers
    )

    if response.status_status_code == 201:
        print(f"成功排期文章: 《{title}》,将于 {publish_time} 自动发布")
    else:
        print(f"发布失败,错误代码: {response.status_code}, 返回信息: {response.text}")

# 示例:将生成好的文章分散在未来48小时内发布,每隔3小时发一篇
# post_article_scheduled("新站SEO优化指南", "<p>正文内容...</p>", category_id=1, delay_hours=3)
2. 内容质量把控:AI生成内容如何避免被识别为垃圾文本?
每天更新10-20篇AI内容是目前效益最高的模式,但直接复制粘贴ChatGPT输出的原生文本,死得极快。AI生成的文章有极强的固定套路(比如“总而言之”、“首先其次最后”、“在当今快节奏的社会中”)。
避坑 Prompt 模板(直接套用)
在使用大模型(DeepSeek / ChatGPT / Claude)生成文章时,必须加入格式约束与去AI痕迹指令:
你是一名拥有10年一线实操经验的IT运维工程师。请针对主题“Linux服务器CPU占用100%排查步骤”写一篇实战教程。

要求:
1. 严禁使用“在当今快节奏的数字时代”、“总而言之”、“不可否认”等废话话术。
2. 开篇第一句直接给出核心命令行组合,不要做任何背景铺垫。
3. 全文使用 Markdown 格式,包含 H2/H3 标题,重点命令必须用代码块(```bash)标注,并附带逐行注释。
4. 插入至少两个真实踩坑场景(如:发现是隐藏进程导致的伪装占用,如何使用 unhide 工具排查)。
5. 字数控制在 1500 字左右,口语化、接地气,多用“直接上干货”、“注意这个坑”等从业者常用口吻。
3. 主动推送机制:不能被动等待蜘蛛来抓
不管你每天更新2篇还是50篇,发布后立刻主动推送URL给搜索引擎是新站提速的核心手段。百度有 API 推送,Bing 有 IndexNow,Google 有 Indexing API。
百度 API 自动推送 Python 脚本
import requests

def push_to_baidu(site_url, token, urls_list):
    """
    site_url: 你的域名 (如 https://yourwebsite.com)
    token: 百度搜索资源平台提供的准入密钥
    urls_list: 需要推送的新发布文章URL列表
    """
    api_url = f"http://data.zz.baidu.com/urls?site={site_url}&token={token}"
    headers = {'Content-Type': 'text/plain'}

    # 将列表转换为以换行符分隔的字符串
    post_data = "\n".join(urls_list)

    response = requests.post(api_url, headers=headers, data=post_data)
    result = response.json()

    print(f"推送结果:成功推送 {result.get('success', 0)} 条,本日剩余配额 {result.get('remain', 0)} 条")
    if 'not_same_site' in result:
        print(f"错误:存在异站URL: {result.get('not_same_site')}")

# 使用示例
# urls = ["https://yourwebsite.com/post-1.html", "https://yourwebsite.com/post-2.html"]
# push_to_baidu("https://yourwebsite.com", "YourBaiduToken", urls)
高频关联问题拓展
Q1:新站刚上线,到底要不要一次性塞入几百篇文章打底?
答案:必须要打底,但不是几百篇,建议首批一次性上线 20-30 篇优质内容。
- 原因:如果网站上线时只有一两篇文章,蜘蛛抓取时会判定该站为“未建设完毕”(Under Construction),直接影响初始信任度;但如果一下子搞几百篇纯采集内容,又容易触发新站垃圾过滤机制。
- 最佳避坑操作:
- 建站前在本地准备好 20-30 篇高质量文章(覆盖网站的主要分类)。
- 一次性导入上线,确保每个分类下都有3-5篇文章,首页不留空。
- 完成上述基础建设后,再向 Google Search Console 和百度资源平台提交 Sitemap。
- 随后转入正常的日更节奏(如每日2-5篇)。
Q2:更新了半个月,搜索引擎就是不收录,要不要加大日更量?
答案:千万别盲目加大数量!应该立刻停下来做诊断。
盲目增加更新量不仅解决不了收录问题,还可能在垃圾站的泥潭里越陷越深。收录差的根本原因通常出在以下四个地方:
- Robots文件配置错误:检查
https://yourdomain.com/robots.txt是否误写了Disallow: /。 - 服务器响应异常或防火墙拦截:有些站长开启了 Cloudflare 防火墙或宝塔 Nginx 防火墙,高安全级别直接把百度/谷歌蜘蛛的 IP 当成 CC 攻击给封禁了。
- 排查方法:在 Linux 终端查看 Nginx 访问日志:
# 查看日志中是否有 Baiduspider 或 Googlebot 的 403 / 502 状态码
cat /www/wwwlogs/yourwebsite.com.log | grep -iE "baiduspider|googlebot" | awk '{print $9}' | sort | uniq -c
- 排查方法:在 Linux 终端查看 Nginx 访问日志:
- 内容重复度极高:AI 批量生成的文章标题极其相似(比如《如何学习Python》《怎样学习Python》《学习Python的方法》),被搜索引擎去重机制直接过滤。
- 页面渲染问题:使用了单页面应用(SPA / React / Vue)而没有做服务端渲染(SSR),蜘蛛拿到的是一片空白的 HTML。
Q3:纯靠 AI 批量生成文章,新站会不会很快被 K 站?
答案:纯自动化且不加人工干预的,100% 会被 K,只是时间早晚问题;做过针对性优化的 AI 站可以活得很好。
搜索引擎(尤其是 Google 的 SpamBrain 系统)打击的不是“AI 生成”这一技术手段,而是打击“对用户毫无价值的垃圾内容”。
避坑 checklist(AI建站必做):
- [ ] 增加结构化数据 (Schema Markup):让蜘蛛清晰识别文章类型、作者和发布时间。
- [ ] 补全上下文内链:新生成的 AI 文章中,必须包含 2-3 个指向站内旧文章的超链接(可编写脚本根据标签 Tag 自动匹配注入)。
- [ ] 统一图片与排版格式:剔除 AI 自动生成的 Markdown 图片占位符,配置 WordPress 自动替换本地高压缩 WebP 图片。
- [ ] 删除 AI 虚构事实:AI 经常捏造不存在的 API 函数或命令行参数,上线前必须用脚本或人工做一次技术指令校验。
结尾总结
对于新站运营,稳定压倒一切,质量决定上限,数量仅是辅助。
- 如果你是单打独斗的站长,做垂直领域,每天固定更新 2-3 篇 深度好文,坚持 3 个月,权重和收录必然水到渠成;
- 如果你走的是流量阵地批量覆盖长尾词路线,利用 AI 配合 Python 自动化脚本,控制在每天 10-20 篇,做好内链排期与主动 API 推送;
- 永远记住:10 篇被搜索引擎收录并带来真实搜索点击的文章,价值远高于 1000 篇存放在数据库里连蜘蛛都没来抓过的垃圾页面。