
读取GSC导出的页面数据
旧文章翻新与SEO权重回收最底层的硬核逻辑,从来不是推倒重写,而是死守原始URL、继承历史外链资产、剔除过期时效信息,并按当前搜索意图注入增量内容与Schema标记——对于手握几百上千篇老内容的站点,这套打法比你盲目死磕发新文章见效快至少3倍。
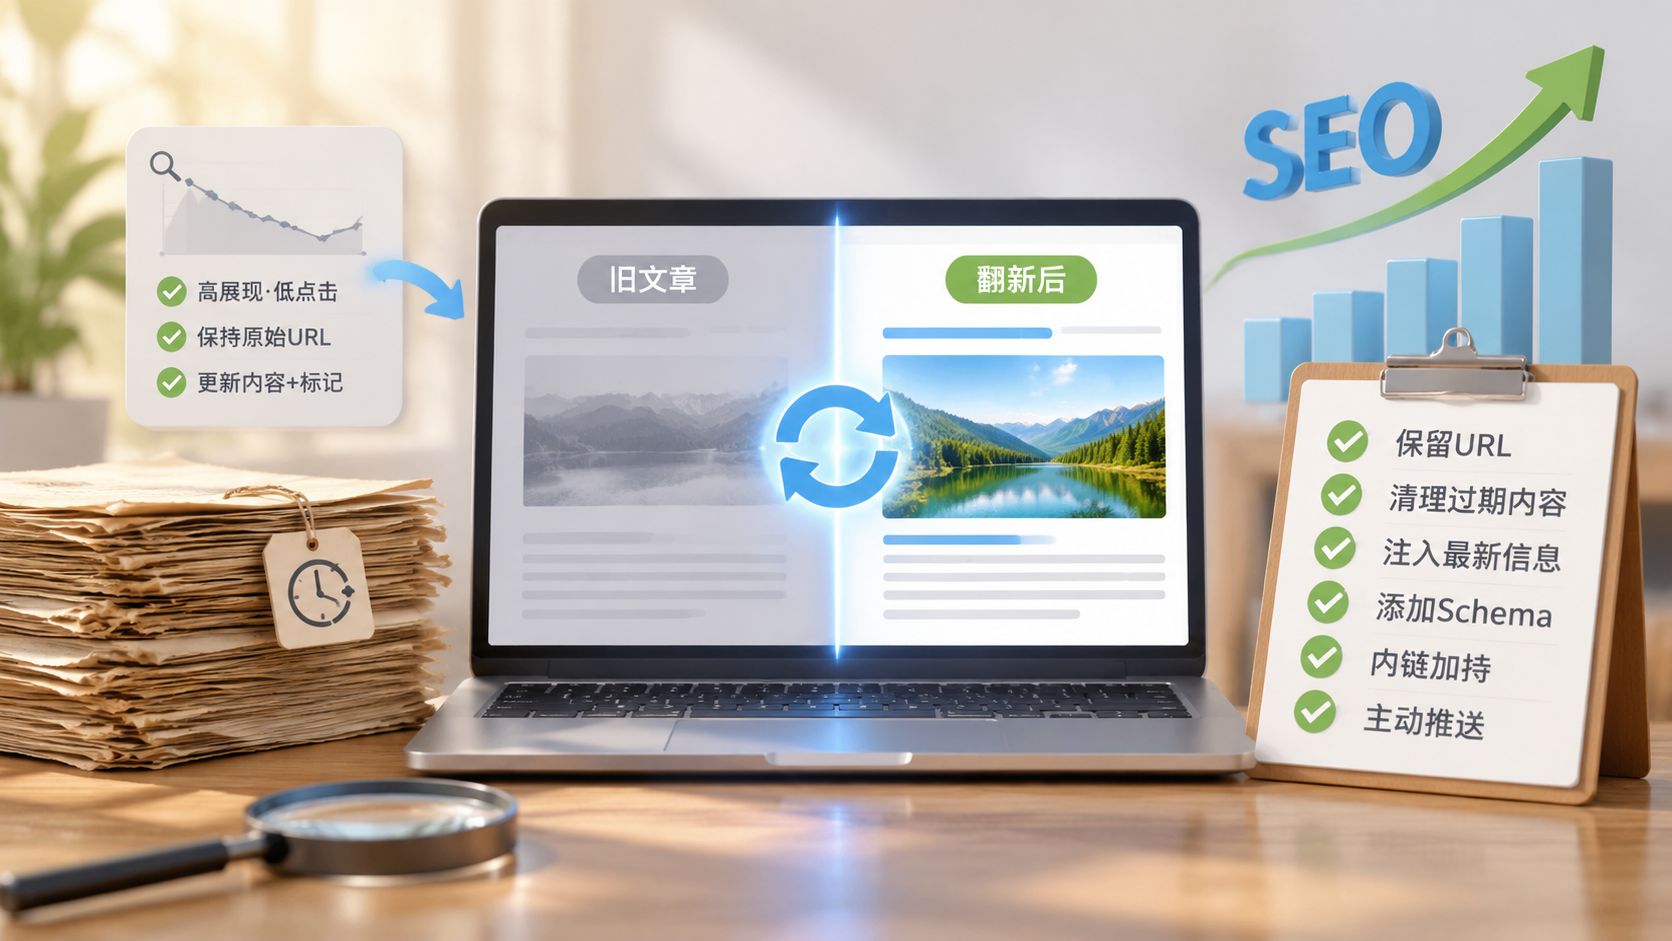
行业里很多所谓的“SEO专家”天天教人堆新词、日更几万字垃圾,纯粹是制造内容焦虑。现实情况是:大量发了2-3年的老文章早就积攒了域名信任度、搜索引擎快照历史甚至自然外链,只是因为信息过期、搜索意图漂移或者被内部孤立,变成了“僵尸资产”。今天我就把一线压箱底的老文章翻新与权重激活流程全盘托出,附带具体脚本和配置,直接抄作业就行。
一、 核心方案速览
老文章翻新不是漫无目的的打扫卫生,遵循以下5步SOP,确保每小时工时都能换来搜索流量回流:
- 精准定位资产:通过Search Console或统计后台,导出“高展现、低点击、排名掉出前3”的历史页面(优先翻新有外链基础的)。
- 严守URL不动:能原地改就绝不换URL,哪怕链接里带着愚蠢的拼写错误或过时年份。
- 外科手术式修剪:砍掉死链与过时废话,重构H2/H3标签,补全新版本实操或配置代码。
- 技术元数据打标:更新页面修改时间戳(
dateModified),严禁篡改原始发布时间(datePublished)。 - 站内权重注入与强推:从当季高权重页面打入锚文本内链,并通过API接口强制搜索引擎重新抓取快照。
二、 实操细节深度拆解
1. 甄别待翻新资产:别在垃圾堆里找黄金
别看文章老就去翻,有些页面底子太差(纯采集、垃圾薄内容),翻新等于给死人化妆。
- 筛选基准:
- 第一梯队(必翻):过去12个月内获得过自然外链,但近90天核心词排名从前5滑落到第10-20名的页面。
- 第二梯队(快翻):Impressions(展现量)极高,但CTR(点击率)低于1.5%的页面(通常是Title落伍或内容与搜索意图脱节)。
- 直接丢弃/合并(301):连续180天0展现、0收录、无任何外链的低质内容,直接301重定向到对应的分类聚合页或核心专题页。
实操工具脚本(Python清洗GSC导出数据示例):
如果你从Google Search Console导出了 Pages.csv,可以用这个小脚本快速抓出“展现高但点击拉胯”的待翻新清单:
import pandas as pd

# 读取GSC导出的页面数据
df = pd.read_csv('Pages.csv')

# 清洗数据格式
df['Clicks'] = df['Clicks'].str.replace(',', '').astype(int)
df['Impressions'] = df['Impressions'].str.replace(',', '').astype(int)
df['CTR'] = df['CTR'].str.rstrip('%').astype(float)
df['Position'] = df['Position'].astype(float)

# 筛选逻辑:高曝光(>1000)、低点击率(<2%)、排名在5到20之间处于下滑期的潜力股
candidates = df[
    (df['Impressions'] > 1000) &
    (df['CTR'] < 2.0) &
    (df['Position'].between(5.0, 20.0))
].sort_values(by='Impressions', ascending=False)

candidates.to_csv('need_to_refresh.csv', index=False)
print(f"筛选出 {len(candidates)} 个急需翻新的核心URL资产!")
2. 内容层翻新:解决搜索意图漂移
很多技术文、工具文排名掉得狠,是因为行业环境变了。比如一篇2021年写的《CentOS 8环境搭建》,今天用户搜这个词,要找的大概率是“CentOS停止维护后的迁移方案”或是“Rocky Linux替代方案”。
- 标题改造公式(直接套用):
- 错误改法:全推倒换个完全不相干的标题。
- 正确改法:
保留核心词 + 增量卖点(年份/版本/踩坑规避) - 例句:原标题《Docker容器跨主机网络配置指南》,改为《Docker容器跨主机网络实战配置(含Overlay与Macvlan性能对比,2024避坑版)》。
- 正文增删原则:
- 删:失效的第三方下载链接、过时的系统版本依赖(如Python 2.7配置)、废弃的API调用。
- 留:历史积淀的原理解析、架构逻辑、排错经验(这些是常青内容)。
- 补:最新版本的配置示例、直观的排错流程图、可复制的CLI命令块。
3. 结构化数据与时间戳改造(致命避坑点)
不少人翻新老文章喜欢把发布时间改成“刚刚”,这是典型的自作聪明。搜索引擎比你清楚这篇页面什么时候第一次入库,直接改发布时间不仅可能被判定为欺诈(Spam),还会丢失原本的时间权威积累。
- 正确做法:保留
datePublished,更新dateModified。 - 页面Schema JSON-LD必须规范:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "TechArticle",
  "headline": "Docker容器跨主机网络实战配置(含Overlay与Macvlan性能对比)",
  "datePublished": "2021-06-15T08:00:00+08:00",
  "dateModified": "2024-10-24T14:30:00+08:00",
  "description": "更新Macvlan在最新内核下的驱动兼容问题解决步骤,补齐生产环境排障指南。",
  "author": {
    "@type": "Person",
    "name": "一线运维老炮"
  }
}
</script>
4. URL处置与重定向策略
- URL包含年份怎么办?(如
/tools-review-2020/)- 首选方案:不改URL! 只要原URL有权威外链,宁可在页面里加粗提示“本文已持续更新”,也不要轻易动URL。
- 次选方案:如果逼迫症发作非改不可,必须在Nginx层做极其严格的301永久重定向,千万别写错正则导致死循环。
# 谨慎:仅在必须丢弃老旧URL结构时使用,301传递权重
location = /tools-review-2020/ {
    return 301 https://example.com/tools-review/;
}
5. 权重激活:内链唤醒与强行收录
改完内容丢在那不管,等于没翻新。老文章在搜索引擎的抓取预算里优先级非常低,蜘蛛可能半个月都不来一次。
- 内链打桩法:找到你站点目前流量最高、每天蜘蛛必来的新文章或首页推荐位,在正文中找相关锚文本,直接硬链接到被翻新的老文章。
- 主动推送:翻新发布后5分钟内,通过API向搜索引擎直接推送URL更新请求。
百度API主动推送Shell命令(服务器Crontab或CLI直接跑):
curl -H 'Content-Type:text/plain' --data-binary 'https://example.com/tools-review/' "http://data.zz.baidu.com/urls?site=https://example.com&token=你的Token"三、 高频关联问题拓展
Q1:老文章翻新后,排名非但没涨,反而彻底从前50掉出去了,怎么排查?
答: 90%是改动时触发了“意图偏差”或“过度优化惩罚”。
- 第一步排查:检查原先带来核心展现的长尾词,是不是被你删掉了?比如原来靠“报错代码 0x0002”拿流量,你翻新时嫌代码太丑给删了,排名瞬间暴毙。翻新前必须看一眼原URL在搜索词报告里吃的是哪口饭。
- 第二步排查:检查HTTP状态码。很多人CMS后台翻新页面时,系统逻辑是“先删后建”,短暂报过404,或者 canonical 标签被自动改成了其他地址。
Q2:手头积攒了3000篇老技术文章,人工改根本改不过来,AI自动化翻新靠谱吗?
答: 全自动AI翻新是找死,但“半自动人机协同”可行。
- 避坑点:千万别把整篇文章丢给大模型让它“润色改写”。AI生成的车轱辘话和幻觉代码会立刻触发低质内容算法(如Google的Helpful Content Update)。
- 可行打法:用脚本批量提取文章中的旧版命令行/代码片段(正则匹配),让模型仅针对“语法更新(例如Python 2转3、旧配置项废弃)”进行定向替换;人工花30秒补充一条当年的真实踩坑Tips。效率提升80%的同时保住内容独特性。
Q3:翻新老文章频率控制在多少合适?
答: 遵循“二八定律”。如果你的站点有1000篇文章,每天产出2篇新内容的同时,翻新1篇核心老资产是最佳配比。切忌一天之内批量修改数百个老页面的发布时间,这在搜索引擎的风控眼里属于典型的黑帽泛目录站群行为。
四、 总结
搞技术和做站久了你就会发现,增量虽然诱人,但存量才是底气。旧文章翻新与SEO权重回收的核心精髓,就在于用最低的内容生产成本,盘活已经被搜索引擎标记过、拥有岁月沉淀的域名内页资产。
记住三个铁律:URL能不动就不动、搜索意图要更新到位、技术元数据与内链必须闭环。别再整天瞎折腾发垃圾新文章了,立刻去翻翻你的后台数据表,那些积灰但曾带来过几万IP的老页面,才是你网站最硬的摇钱树。