
[长尾关键词]:3分钟排查与彻底解决实操指南
长尾关键词内容矩阵布局的核心打法就八个字:拓词聚类、模版落地、内链成网。不要再去死磕“云服务器”、“SEO优化”这种大词交学费了,中小团队和站长靠几个人甚至单兵作战,必须用几百甚至上千篇解决具体技术痛点的高意向长尾文章,去横扫搜索引擎的增量流量。
核心方案速览
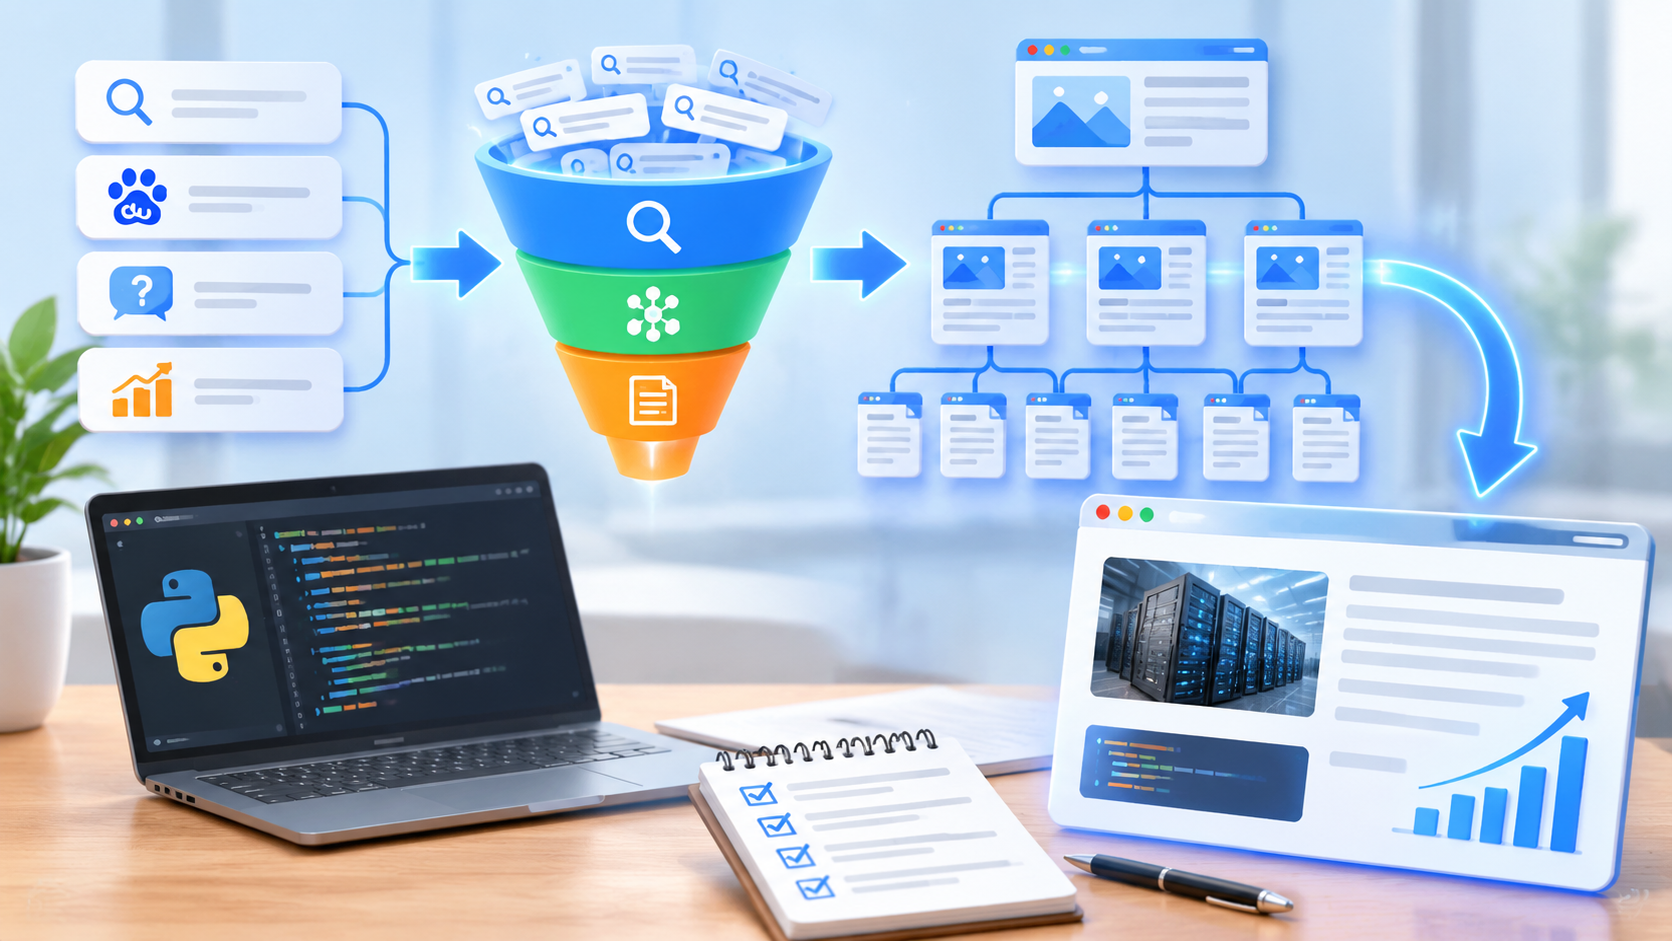
做长尾关键词内容矩阵,本质是在搜索引擎里搭一个“漏斗式的内容拓扑网”。整套打法的全流程标准作业程序(SOP)如下:
- 源头拓词:放弃手动查指数,直接用脚本批量抓取搜索引擎下拉框、相关搜索、竞品Site数据以及问答社区长尾提问。
- 意图聚类:将挖出来的数万个长尾词按“信息查询型”、“排错解决型”、“商业对比型”打标归类,合并同义词,防止自己跟自己打架(关键词自相残杀)。
- 矩阵化生产:拒绝纯人工慢写,也拒绝纯AI生成垃圾水文。采用“固定骨架 + 实操代码/配置 + AI扩写细节 + 人工复核排雷”的流水线模式。
- Silo内链拓扑:长尾页面(Leaf)单向或双向链接归拢到核心专题页(Pillar),同级长尾互链必须基于上下文强相关,绝不全站死循环乱跳。
实操细节深度拆解
一、长尾词自动化挖掘与清洗(附Python脚本)
行业里不少人教拓词还在推荐死贵的SaaS工具,实际上直接去爬搜索引擎的免费接口最精准。下面这个脚本直接拿去跑,输入核心根词,递归获取百度下拉建议词并清洗去重:
import requests
import csv
import time

def get_sug_words(keyword):
    """获取百度下拉框长尾词"""
    url = f"https://suggestion.baidu.com/su?wd={keyword}&sugmode=2&json=1"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }
    try:
        res = requests.get(url, headers=headers, timeout=5)
        res.encoding = 'gbk' # 百度接口历史原因返回gbk
        text = res.text
        # 简单切片提取json数据
        start = text.find('s:[') + 3
        end = text.find(']});')
        if start > 2 and end != -1:
            raw_words = text[start:end].replace('"', '').split(',')
            return [w.strip() for w in raw_words if w.strip()]
    except Exception as e:
        print(f"Error fetching {keyword}: {e}")
    return []

def recursive_expand(root_words, depth=2):
    """递归两层拓展长尾词"""
    all_words = set(root_words)
    current_layer = set(root_words)

    for d in range(depth):
        next_layer = set()
        for kw in current_layer:
            print(f"正在挖掘: {kw}")
            sug_list = get_sug_words(kw)
            for w in sug_list:
                if w not in all_words:
                    all_words.add(w)
                    next_layer.add(w)
            time.sleep(0.3) # 礼貌爬取,防止被封
        current_layer = next_layer
    return all_words

if __name__ == "__main__":
    seeds = ["Nginx 502", "Docker部署", "Python爬虫"]
    result = recursive_expand(seeds, depth=2)
    with open("long_tail_keywords.csv", "w", encoding="utf-8-sig", newline="") as f:
        writer = csv.writer(f)
        writer.writerow(["Keyword"])
        for r in result:
            writer.writerow([r])
print(f"拓展完成,共获取 {len(result)} 个有效长尾词!")实操避坑点:
- 别去抓没有“动作意图”的词,比如纯名词“Redis”,抓出来没有意义。
- 重点抓取带有修饰符的词:“怎么解决”、“报错原因”、“配置教程”、“对比测评”,这种词转化率奇高。
二、语义聚类与树状拓扑架构搭建
拿到几千个词后,最忌讳的是“一个词写一篇文章”。搜索“CentOS 7 安装 Docker 报错”和“CentOS 7 Docker 安装失败”的底层需求是完全一样的,写两篇会被搜索引擎直接判为低质重复站。
- 步骤 1:同义归并(Canonical Keyword) 把搜索意图重合度超80%的词合并为一组,只选搜索量最高或最自然的一个作为目标URL的核心Title,其他词作为文章内的H2或段落变体。
- 步骤 2:建立 Silo(筒仓)结构
矩阵一定要分层:
- 顶级分类(Category):例如
/DevOps/ - 支柱核心页(Pillar Page):例如
/devops/docker-troubleshooting/(覆盖中等难度词,如“Docker常见报错大全”) - 长尾末梢页(Cluster Leaf):例如
/devops/docker-troubleshooting/docker-daemon-failed-start/(精准击穿极细长尾词)
- 顶级分类(Category):例如
三、工业化内容模板设计(拒绝空洞AI废话)
很多站长搞长尾词矩阵,用AI一键生成“首先、其次、总之”这种毫无价值的文字垃圾,算法更新一次死一批。想要长尾词排名稳、存活久,内容必须包含真实验证过的配置代码、排错日志以及直给的解决方案。
推荐直接套用以下Markdown结构进行批量产出:
# [长尾关键词]:3分钟排查与彻底解决实操指南

> **环境说明**:CentOS 7.9 / Docker 24.0.5 / Python 3.10(必须标明环境,提升权威度)

## 现象与错误日志复现
遇到该问题时,终端或系统日志(journalctl -u ...)通常会出现如下特征代码:
```bash
# 贴出真实报错片段(必须包含用户搜索报错的关键字段)
Error: failed to start daemon: Error initializing network controller: ...
核心原因剖析
出现该问题的核心原因有且仅有以下两点(直给结论,不讲技术历史废话):
- 系统防火墙(iptables/firewalld)冲突导致bridge驱动加载异常。
- 配置文件
/etc/docker/daemon.json语法错误或存在冲突键值。
经过验证的解决方案(按顺序执行)
步骤一:修正配置文件
执行以下命令备份并替换配置:
cp /etc/docker/daemon.json /etc/docker/daemon.json.bak
# 真实配置贴在这里
步骤二:重载并启动服务
...
避坑提醒与关联场景
- 注意:执行此操作前,请务必确认是否挂载外部卷...
- 相关排错参考:[链接到同分类下的另一个长尾问题URL]
实操经验:即使使用大模型批量生成,也必须在Prompt中强制要求:“必须给出真实终端命令与错误排查上下文,严禁任何形式的寒暄与理论科普”。
四、内链权重流动策略(严防“蜘蛛陷阱”)
搞矩阵最怕“页面孤岛”或者“死循环乱链”。正确的长尾内链规范只有三条红线:
- 自下而上回血:所有长尾叶子页,在正文首段或末尾,必须有一条锚文本精准链接回它所属的“支柱页(Pillar Page)”。
- 同级语义互链:只有在排错逻辑有顺承关系时,长尾A才能链长尾B。例如“Nginx 502排查”可以在文末提到“如果排查后发现是PHP-FPM假死,参考这篇《PHP-FPM内存溢出解决》”。
- 禁止全站盲目内链:不要在页脚或侧边栏搞什么“随机推荐100篇文章”,蜘蛛抓多了只会判定权重极其混乱,直接稀释垂直度。
高频关联问题拓展
Q1:长尾关键词内容矩阵发布初期,页面不收录或者收录极慢怎么办?
答:小站千万别指望搜索引擎蜘蛛主动来爬你的深层目录。
- 操作一:利用API提交。写一个Shell脚本,在文章发布落库的瞬间,直接调用百度站长平台或Google Indexing API接口推送URL。
- 操作二:更新聚合页。每次长尾文章更新,必须触发它所属父级目录页的缓存刷新,并将其提升到聚合列表的首位,保证爬虫在抓取分类首页时就能直接顺着新链接爬进去。
Q2:矩阵做了大几百篇文章,流量上来了,但跳出率高达90%,根本不转化怎么办?
答:这是长尾词矩阵的通病——意图对齐但承接断层。 很多技术人员看完代码复制走人是天经地义的。你必须在关键阻断点上做转化埋点。
- 例句模板:“如果你使用的是K8s集群环境,手动执行上述配置极易导致Pod漂移配置丢失,可直接下载已打包好的集群初始化脚本(附Github链接或公众号回复获取)”。
- 原则:给普通人最直白的解决方案,但把“高阶、自动化、免折腾”的方案做成转化承接钩子。
Q3:大量AI辅助的长尾文章,会不会被搜索引擎算法当作SPAM降权惩罚?
答:搜索引擎打压的从来不是“是不是AI写的”,而是“这个页面有没有信息增益(Information Gain)”。 满篇AI吐出来的通用车轱辘话必死无疑。只要你的长尾内容包含:
- 独特的配置代码或Shell脚本。
- 真实的报错日志和场景排查步骤。
- 结构化的FAQ格式(Schema标记)。 搜索引擎根本不会降权,反而会判定该页面具有极高的实用价值予以置顶。
结尾总结
长尾关键词内容矩阵布局不是靠蛮力盲目铺量,也不是靠运气赌大词爆款,而是一套严谨的工程化打法。从Python脚本自动化抓取下拉词,到严格归并搜索意图划分Silo目录,再到流水线式输出具有实操价值的内容骨架,最后通过规范的内链将零散的权重聚沙成塔。只要你把某一个垂直技术栈下的200个真实报错、100个配置方案用这种矩阵方式做扎实,在这个细分领域里,无论是流量沉淀还是商业转化,对手都极难对你构成降维打击。立刻停掉那些无意义的空泛更新,跑起拓词脚本,先把你的第一个分类目录打穿。