
clean_ai_fingerprint.py
这份拒绝AI垃圾内容降权自救指南的核心结论只有一句话:立刻停止任何试图通过“提示词调优让人话更自然”来糊弄算法的幻想,唯一的解法是“外科手术式物理切除死重页面 + 建立强约束的信息增益内容流水线”。被降权的站点如果舍不得删掉那几万篇毫无信息增益的AI垃圾,神仙也救不回来。
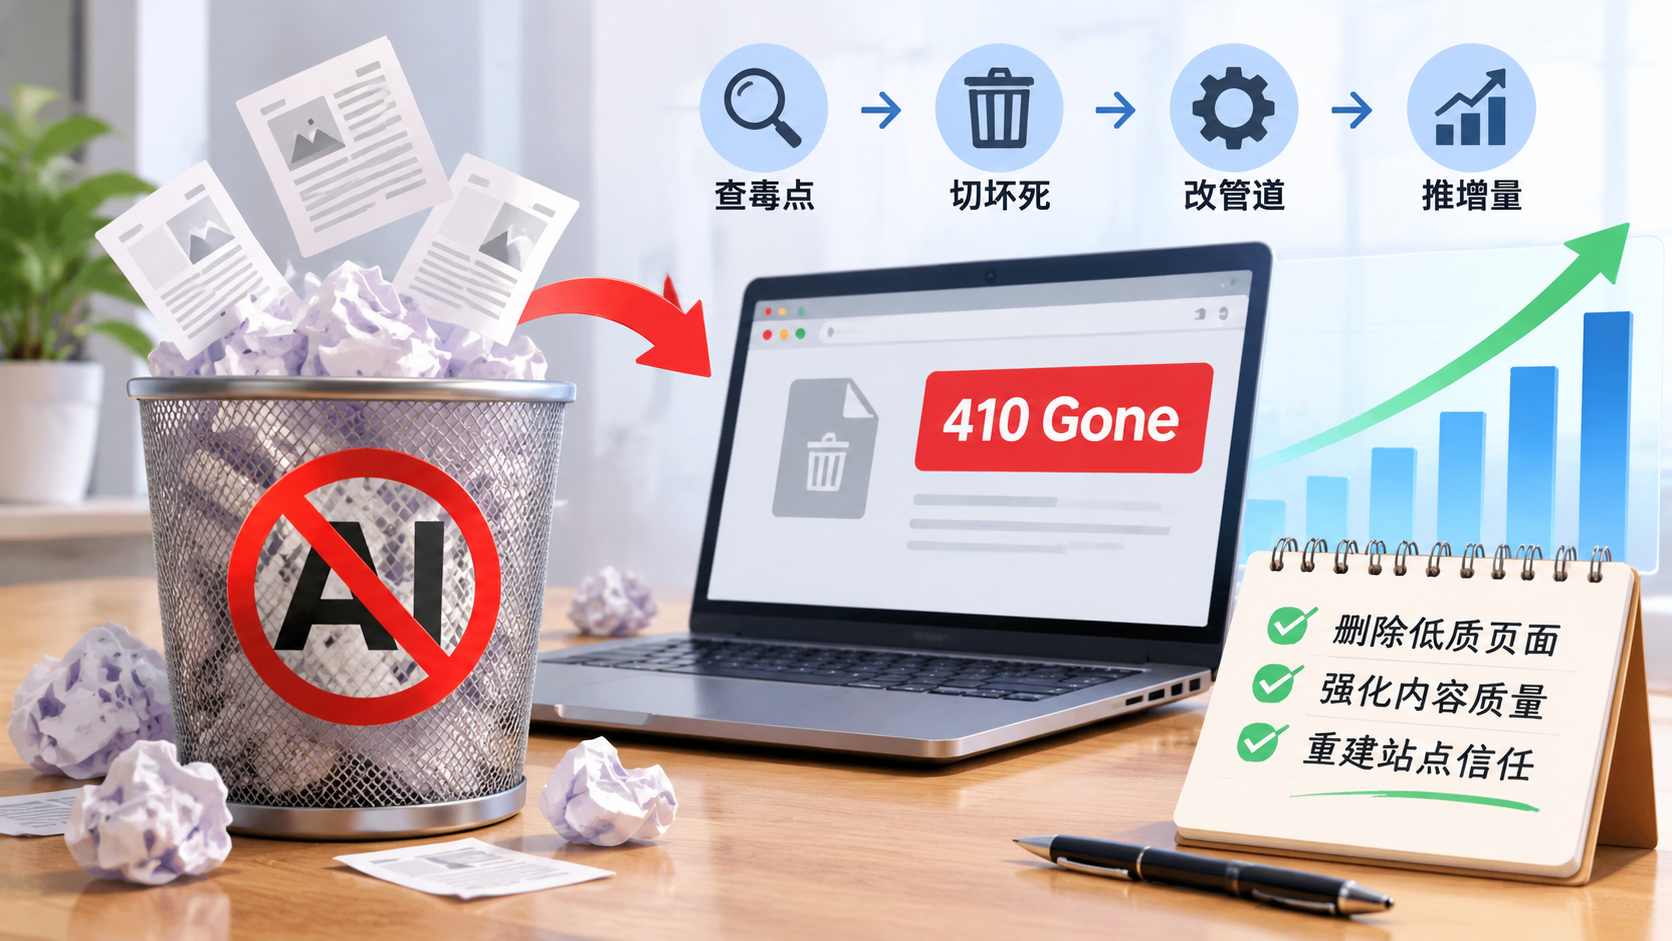
很多站长和运营用批量脚本接个ChatGPT或开源大模型API,一天怼几千篇“在当今快节奏的社会中,XX显得尤为重要……”这种正确的废话,爽了半个月,接着就是Google Helpful Content Update或者百度飓风算法直接腰斩甚至清零,蜘蛛不来、收录停滞、展现暴跌。
别慌,按下面的标准工业化救砖流程走,我经手过三个被K到只剩首页的站点,基本在4-8周内能逐步爬出算法泥潭。
核心方案速览
自救动作必须严格按照“阻断毒源 -> 切除坏死 -> 稀释负面资产 -> 重塑权重”四步走,切忌边删边继续发烂内容:
- 查毒点(Day 1):通过日志分析与站长后台导出展现断崖页,匹配“AI特征词库”,圈定待清理页面清单。
- 切坏死(Day 2-3):对垃圾内容页批量执行 HTTP 410(Gone) 或 Header/Meta
noindex,绝不留恋。 - 改管道(Day 4-7):重写Prompt工程,强制注入私有数据、真实代码或操作案例,杜绝空话。
- 推增量(Day 8及以后):每天固定产出极少量但具有绝对信息增益的干货,重构Sitemap,调用API强推,引导蜘蛛重新建立站点信任。
实操细节深度拆解
步骤一:拉取垃圾页面指纹,定位被K范围
垃圾页面有个通病:抓取频次骤降、收录后无展现、或者跳出率极高且停留时间低于10秒。
别手动看,写个Python脚本把站内文章拉出来跑正则。绝大多数未经调优的AI内容都有极其恶心的特征句式,比如“总而言之”、“综上所述”、“如同双刃剑”、“在这个数字化时代”。
# clean_ai_fingerprint.py
import re
import pandas as pd

# AI垃圾高频特征词库(根据自己行业调整)
AI_PATTERNS = [
    r"在当今.*?时代",
    r"总而言之",
    r"综上所述",
    r"正如一把双刃剑",
    r"需要注意的是,.*?(重要性|不可忽视)",
    r"扮演着不可或缺的角色"
]

def scan_content(file_path):
    df = pd.read_csv(file_path) # 包含 url, content
    toxic_urls = []

    for idx, row in df.iterrows():
        content = str(row['content'])
        hit_count = sum(1 for p in AI_PATTERNS if re.search(p, content))
        # 命中2个以上套话,且正文没有包含代码块、配置项或具体数字
        has_code = "```" in content or "<code>" in content
        if hit_count >= 2 and not has_code:
            toxic_urls.append(row['url'])

    print(f"扫描完毕,共发现 {len(toxic_urls)} 个低质AI页面待处理")
    with open("toxic_urls.txt", "w") as f:
        f.write("\n".join(toxic_urls))

if __name__ == "__main__":
scan_content("site_articles.csv")避坑点:不要以为只是百度搜狗降权,Google对这类内容杀得更狠。只要文章里充斥着“概述-三个优点-三个缺点-总结”这种千篇一律的结构,哪怕没有上面的词,也属于算法必杀范围。
步骤二:优雅切除坏死资产(Nginx与HTTP响应)
很多人的骚操作是:直接在后台把文章删了,访问直接丢404,或者直接301跳到首页。这是大忌!
- 301跳首页:相当于把垃圾页面的毒性直接引流到首页,拖死主域名。
- 普通404:搜索引擎会认为这可能是服务器暂时故障,反复来爬取确认,占用抓取配额。
最干净的做法是:直接返回 HTTP 410 Gone,明确告诉搜索引擎:“这玩意儿是我主动永久删除的,不要再来了”。
如果你的Web服务器是Nginx,将扫描出的垃圾URL集中导出一个配置文件:
# /etc/nginx/conf.d/toxic_pages.conf
# 匹配坏死URL直接返回410
location ~* ^/(blog|article)/(toxic-slug-1|toxic-slug-2|trash-ai-page-.*) {
    return 410 "Page Permanently Removed";
}
如果舍不得物理删除(例如某些页面有少量长尾流量,只是被主站牵连),可以在HTML Head里加上强硬的 noindex,只保留内链传递权重,不让它参与索引:
<!-- 在低质但暂不打算删的页面head中注入 -->
<meta name="robots" content="noindex, follow">
修改后,用 curl -I https://yourdomain.com/article/toxic-slug-1 检查返回头,必须确认为 HTTP/1.1 410 Gone。
步骤三:重塑生成管道,强制输出“信息增益”
搜索引擎降权本质是惩罚低信息增益(Information Gain)。如果你还要用AI辅助写内容,必须彻底废弃现有的Prompt,强迫模型提供事实、参数、反例、对比表格或现成配置。
丢掉你那些“写一篇关于Docker部署Nginx的文章”之类的垃圾提示词,改用具有硬性工程约束的Prompt模版:
# 具有高信息增益的生产Prompt约束规范

你是一个有10年运维经验的架构师,请写一篇关于【Nginx动静分离实战配置】的技术指南。

必须严格遵守以下执行规则:
1. 【禁止空话】:不要出现“在现代高并发架构中”、“至关重要”等任何铺垫,第一段第一句必须直接给核心配置逻辑。
2. 【必须包含一手实操】:必须包含一个生产环境真实的 nginx.conf 完整片段,标注出反向代理缓冲区设置的坑点(如 proxy_buffer_size)。
3. 【强制排错场景】:提供至少两个常见报错(例如 502 Bad Gateway 和静态资源 404)的排查思路和命令行排错步骤。
4. 【结构硬约束】:
   - 开篇核心配置清单
   - 核心参数调优对照表(Markdown表格,列名:参数名 | 默认值 | 生产推荐值 | 调优依据)
- 常见避坑记录实操标准:凡是AI生成出来的内容,你亲自读一遍,如果删掉文章里的代码/配置/数据,整篇文章就变成一堆空壳子,那这篇内容就属于及格线以上;反之,如果整篇都是文字描述,没任何实操落点,直接扔进垃圾桶。
步骤四:重新提交索引与抓取调度
批量删了垃圾、上了新内容之后,别干等蜘蛛自己来,它们的抓取额度早被你之前的垃圾内容耗尽了。
- 生成精简纯净版 Sitemap:把返回410的死链彻底踢出XML Sitemap,只保留排查后的优质存量页和新增页。
- 主动推送修复信号:调用各大搜索引擎的主动推送API,只推你重构过的高质量增量页面。
# 百度主动推送示例脚本,强制推送优质增量
curl -H 'Content-Type:text/plain' --data-binary @fresh_good_urls.txt "http://data.zz.baidu.com/urls?site=https://yourdomain.com&token=YOUR_TOKEN"
在Google Search Console里,提交新的Sitemap后,挑选5-10个核心枢纽页面(如分类页、聚合页),手动点击 Request Indexing,引导Googlebot重新计算这几个节点的抓取优先级。
高频关联问题拓展
Q1:已经被降权的URL,改好了直接原地更新,还是换个新URL发?
答:必须原地更新。
很多人怕老URL有黑历史,喜欢删了发个新路径(比如从 /post/123 改成 /post/123-new)。千万别这么干!老URL如果曾经有过权重和抓取记录,改好后原地覆盖,蜘蛛在重新爬取到高价值内容后,会触发历史修正机制;换新URL,老页面如果留着就是死链,删了换新就是重新排队审核,纯属自己给自己增加爬坑难度。
Q2:用市面上的“AI降重/过检测”工具,把内容洗一遍能解封吗?
答:纯属交智商税,别在同一个坑里跌倒两次。 降重工具的本质是同义词替换和语序重组,这只会让文章的可读性变得更差、逻辑更混乱。现在的搜索算法对AI内容的识别,根本不仅仅依赖于所谓的“困惑度(Perplexity)”和“突发性(Burstiness)”,更看重的是用户行为数据(停留时长、下滑深度、跳出率、是否二次搜索)。你把一段AI废话改得狗屁不通,即便绕过了字符层面的AI检测,用户进来看一眼就关掉,依然会被行为算法一锤定音打入冷宫。
Q3:如何用CI/CD流程防范运营或员工再次提交AI垃圾?
答:在Git Hook或发布后台加拦截门禁。 可以在内容发布系统(CMS)的API前置一层极简校验,未达标直接拒绝写入数据库:
def content_quality_gate(html_content):
    # 门禁规则1:正文总字数超过1200,但无任何格式化元素(列表、加粗、代码块),直接拦截
    has_structure = any(tag in html_content for tag in ['<ul>', '<ol>', '<pre>', '<code>', '<table>'])
    if not has_structure and len(html_content) > 1200:
        return False, "缺乏结构化信息,疑似纯文本AI垃圾,拒绝入库"

    # 门禁规则2:代码或表格密度检测
    # 针对技术/教程类站点,必须强制要求技术资产占比
    code_blocks = html_content.count("<pre>")
    if code_blocks == 0:
        return False, "实操类教程必须包含完整可复现代码或配置块"

    return True, "通过"
总结
AI确实把内容的边际生产成本干到了零,但当所有人的生产成本都是零的时候,你的零成本资产在搜索引擎眼里就是负资产。被降权不可怕,可怕的是你舍不得删库。
被AI垃圾降权后的自救核心就三点:
- 别怂,大刀阔斧干掉所有没增量的数据,全站直接410,断臂求生。
- 把AI当成代码补全和语法润色工具,而不是丢给它一个标题就让它闭门造车。
- 每一篇放出去的内容,必须包含只有真实人类在真实工作场景下才能碰到的报错、参数、图表或者真实数据。
按这套逻辑彻底清仓、重写内容管道,剩下的交给人性化的更新节奏,算法自然会撤销惩罚。