
谷歌SEO英文关键词调研实操流程:避开伪需求与零流量词的落地方案
谷歌SEO英文关键词调研实操流程的核心结论非常直白:不要迷信第三方工具导出的海量表格和虚高的搜索量,真正能落地的流程是“挖出母语者真实痛点词 -> 竞品流量页面扒皮 -> SERP人工意图与竞争度核验 -> 词库脚本清洗聚类 -> 页面映射落地”。很多新手做英文站,一上来就在工具里输个大词导出一万行数据,按搜索量从高到低排个序就开始埋头写文章,结果站建好了半年没流量,要么是关键词难度大到根本挤不进前十页,要么是老外根本不这么搜索,甚至把B端采购词和C端消费词混在一篇文章里。把调研的重心从“看工具数据”转到“看谷歌真实搜索结果页(SERP)”,才能真正跑通整套流程。
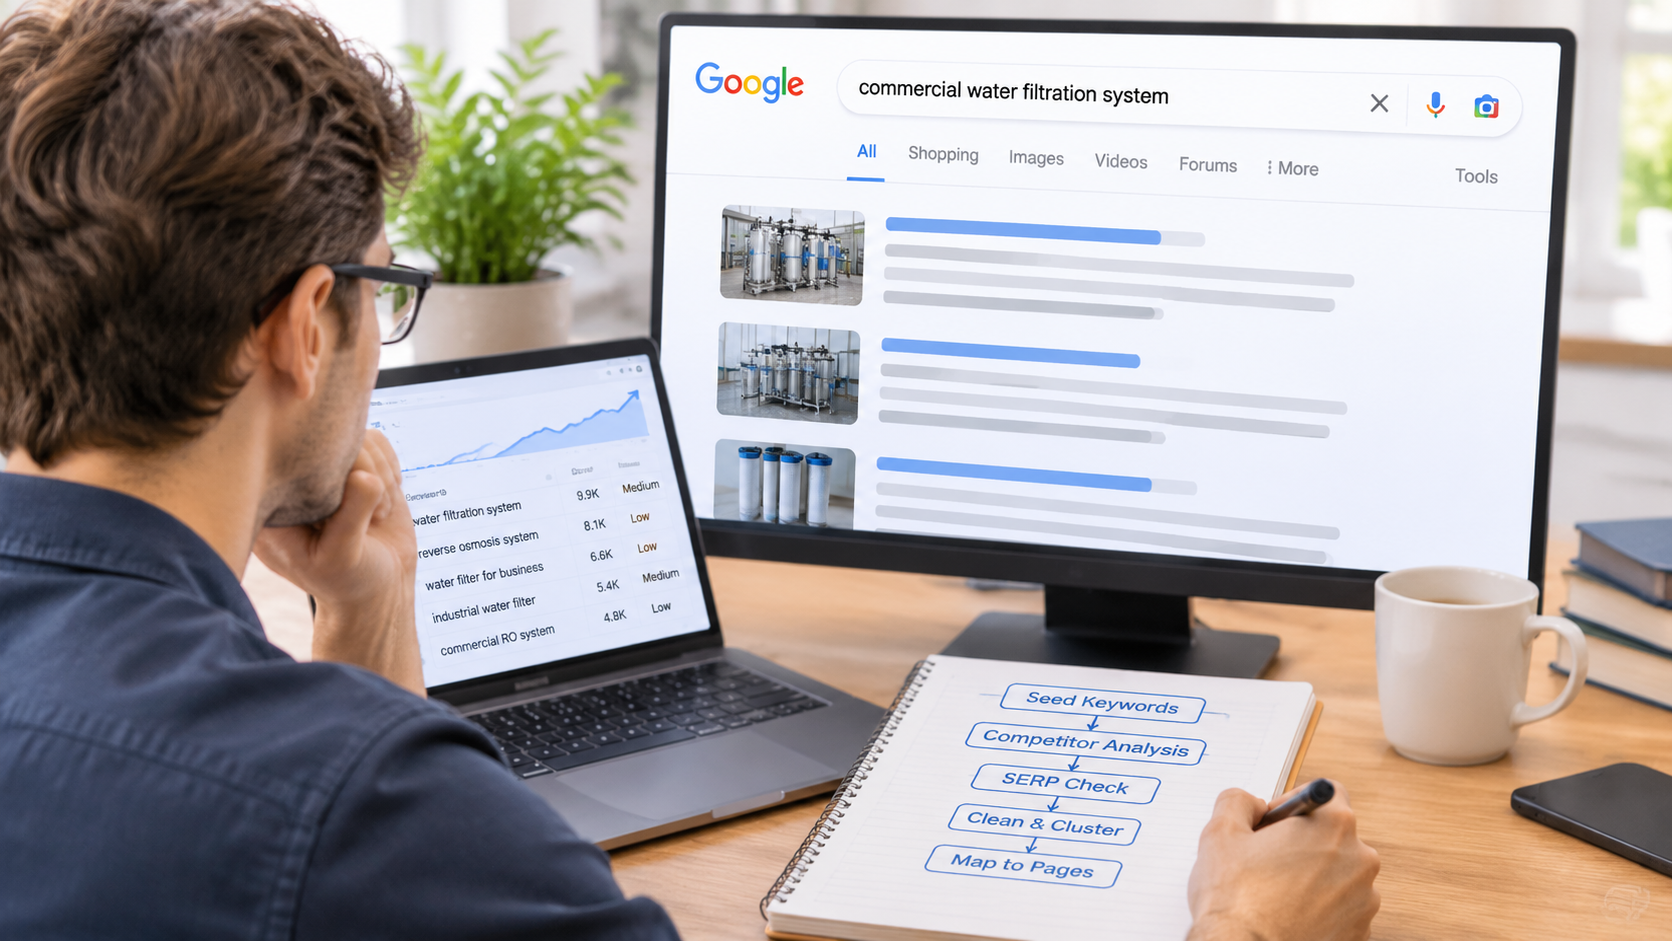
核心方案速览
一套不走弯路的谷歌SEO英文关键词调研实操流程,建议按以下五个阶段串行推进,不同体量的站点只需在难度过滤阈值上做微调即可:
- 种子词采集:放弃中式英语直译,从 Google 下拉框、People Also Ask(大家都在问)、Reddit 和 Quora 抓出老外真实讨论的词根。
- 竞品借力扩词:用 Ahrefs 或 Semrush 反查同体量竞品排名靠前的低权重页面,直接提取已被验证能拿到流量的长尾词库。
- SERP 人工核验:挂对应目标国家的干净 IP,打开浏览器无痕模式,逐一核对核心词的搜索意图与首页竞争对手的真实网页质量。
- 脚本清洗与聚类:用 Python 或表格公式过滤掉竞争对手品牌词、无关词和伪需求词,将搜索结果高度重合的词合并到同一个主题组。
- 页面意图映射:按照“一个核心意图对应一个独立页面”的原则分配到产品页、分类页或博客文章中,避免站内页面互相抢排名。
适用场景区分:
- 冷启动新站 / 低权重站:跳过高难度核心大词,主攻长尾问题词、具体报错/使用场景词、细分产品对比词。
- 成熟老站 / 已有稳定收录:重点在竞品词库中寻找自己还没覆盖的专题集群(Topic Cluster),补全高商业价值的行业大词。
实操细节深度拆解
一、 挖出母语者真实搜索的种子词
自己拍脑袋翻译中文词去查英文搜索量,是踩坑的第一步。比如国内常说的“工业净水器”,直接翻成 industrial water purifier 固然没错,但老外在具体采购或排查故障时,可能会搜 commercial reverse osmosis system 或者 heavy duty water filtration。
操作步骤与可直接套用的搜索指令: 打开 Google(注意将地区和语言切换到目标市场,例如美国 English),利用 Google 的搜索指令去社区里挖词,或者直接触发长尾联想:
# 1. 去 Reddit 找真实用户的吐槽、求助和产品推荐词
site:reddit.com "how do I" + [你的核心产品词]
site:reddit.com "best" + [你的核心产品词] "worth it"

# 2. 用星号通配符触发 Google 搜索框自动补全(把光标停在星号处查看下拉)
how to * [你的核心产品词]
[你的核心产品词] vs *
best [你的核心产品词] for *

# 3. 批量寻找同行写了但竞争可能极低的长尾标题词
allintitle: best [你的核心产品词] for [细分场景]避坑点:不要只抓“名词+名词”的干瘪词根。把老外在论坛里提问的完整句式记录下来,比如 why does my [产品] leak、alternative to [行业大牌],这些往往是转化率极高的精准长尾词。
二、 竞品扒皮与工具扩词的正确姿势
拿到十几个核心种子词后,再打开 SEO 工具(如 Semrush 的 Keyword Magic Tool 或 Ahrefs 的 Keywords Explorer)。但比直接用种子词扩词更高效的做法,是直接去偷低权重同行的数据。
操作步骤:
- 把你刚才通过搜索指令找到的那些排名靠前、但看起来网站规模很小的独立博客或小型独立站域名,扔进工具的域名分析模块(Organic Research / Site Explorer)。
- 打开该竞品的自然排名关键词列表(Organic Keywords)。
- 设置过滤条件:排名位置限定在首页(Position: 1-10),排除掉对方自己的品牌词,优先筛选那些给这个小站带来主要流量的页面。
- 点开这些高流量页面的 URL,把页面下所有参与排名的长尾词全部导出为 CSV 文件。
避坑点:千万别迷信工具里的 KD(Keyword Difficulty,关键词难度)数值。很多工具算 KD 只看首页那几个页面的外链数量(Referring Domains),根本不看域名本身的行业权威度、页面内容是否切题。经常出现一个词 KD 显示很低,但你搜一下发现首页全是 Amazon、Walmart 或者行业巨头官网的内页,虽然那些内页本身没几条外链,但凭主域权重就能把小站死死压在后面。工具数据只用来批量找词和看相对大小,不能用来做最终决策。
三、 SERP 人工核验:决定词能不能做的唯一标准
导出几千个词之后,必须挑出准备优先做的词,放到真实的 Google 搜索结果页里去验货。这是整个谷歌SEO英文关键词调研实操流程中最耗精力、但也最决定生死的一步。
核验动作与判断标准: 打开浏览器的无痕模式(确保没有登录 Google 账号且没有历史搜索缓存干扰),挂上目标国家的节点,搜索目标关键词,看前十个自然结果:
- 看搜索意图(Search Intent)是否匹配:
- 如果你想写一篇产品分类页去推销产品,结果搜出来首页前十全都是“What is...”、“How to choose...”的科普长文,说明 Google 判定用户现在只想学习而不是买单,你硬做产品页根本排不上去。
- 反之,如果首页全是电商产品页、报价单页面或软件定价页,你就别费劲写科普博客了,老老实实优化着陆页。
- 找“弱者信号”(判断小站有没有机会切入):
- 如果前十名里出现了 Reddit 帖子、Quora 问答、Medium 文章、GitHub Issue、或者排版粗糙的纯论坛页面,这属于极强的机会信号!说明 Google 在这个词下找不到足够优质的专门页面,只能把社区讨论推到首页。你只要写一篇结构清晰、真正解决问题的独立文章,极易实现反超。
- 如果首页全是各大行业媒体巨头、维基百科、政府机构(.gov)或高校(.edu),且内容极其详尽,新站直接划掉这个词,别做无用功。
四、 批量词库清洗与筛选(附可直接运行的 Python 脚本)
如果你手头从几个竞品和工具里导出了好几份 CSV 表格,动辄几千上万行,用 Excel 手工点筛选很容易卡死或者漏掉脏数据(比如竞品品牌词、色情/违规词、完全不相关的词)。用一段简单的 Python 脚本就能秒级清洗合并。
适用场景:从 Semrush 或 Ahrefs 导出了多份原始关键词 CSV,需要去重、过滤黑名单词根、保留指定搜索量与词数长度的长尾词。
import pandas as pd
import glob
import os

# 1. 批量读取当前目录下所有导出的 csv 文件(假设文件名为 export_1.csv, export_2.csv 等)
file_paths = glob.glob("./raw_keywords/*.csv")
df_list = [pd.read_csv(file) for file in file_paths]
raw_df = pd.concat(df_list, ignore_index=True)

# 注意:不同工具导出的列名不同,这里以常见格式为例,实际使用前请 print(raw_df.columns) 核对列名
# 假设列名为: 'Keyword', 'Search Volume', 'Keyword Difficulty'
raw_df.columns = [col.strip() for col in raw_df.columns]

# 2. 去重并清除缺失值
df = raw_df.dropna(subset=['Keyword']).drop_duplicates(subset=['Keyword']).copy()
df['Keyword'] = df['Keyword'].str.lower().str.strip()

# 3. 过滤黑名单词汇(填入竞争对手品牌词、免费/破解等非目标用户词)
blacklist_terms = [
    'free', 'crack', 'torrent', 'login', 'jobs', 'salary',
    'competitor_brand_a', 'competitor_brand_b'
]
pattern = '|'.join(blacklist_terms)
df = df[~df['Keyword'].str.contains(pattern, na=False)]

# 4. 计算关键词包含的单词数量,筛选长尾词(例如只看3个单词以上的词)
df['Word_Count'] = df['Keyword'].apply(lambda x: len(x.split()))
filtered_df = df[
    (df['Word_Count'] >= 3) &
    (df['Search Volume'] >= 10)  # 按需调整下限,新站不要把阈值卡得太死
]

# 5. 按搜索量降序排列并导出干净表格
filtered_df = filtered_df.sort_values(by='Search Volume', ascending=False)
os.makedirs("./output", exist_ok=True)
filtered_df.to_csv("./output/cleaned_keywords.csv", index=False, encoding='utf-8-sig')

print(f"清洗完成!原始去重词数: {len(df)},过滤后剩余精准长尾词: {len(filtered_df)}")避坑点:在使用黑名单过滤时,注意单词边界问题。比如你屏蔽 free,可能会把 gluten free(无麸质)或者 hands free(免提)这种正常产品属性词也误杀掉。如果是精确屏蔽单词,建议把正则匹配写成 \bfree\b(除非你的业务真的完全不沾这些词根)。
五、 关键词聚类(Clustering)与页面映射
清洗完的词库里,经常会出现几个长得不一样但意思差不多的词,比如 how to clean coffee maker with vinegar、cleaning coffee pot vinegar、descaling coffee machine vinegar。新手最容易犯的错,就是给这三个词分别写三篇文章。结果就是关键词内部蚕食(Keyword Cannibalization):Google 不知道该推你哪一篇文章,导致三篇文章权重分散,全挤在第二页第三页动弹不得。
实操聚类判断法则: 直接把这些长相相似的词放到 Google 里搜一遍,对比它们前十名的搜索结果 URL:
- 重合度高(前十名里有一半左右的网页是完全相同的):把这些词归为同一组,只建一个页面。挑其中搜索意图最明确、表达最自然的那个词放在页面的 Title 和 H1,其余变体词自然地融进正文的 H2 小标题或段落中。
- 重合度极低(首页结果几乎完全是两拨不同的网页):说明 Google 认为这是两个独立的需求,必须拆分成两个独立的页面分别承接。
高频关联问题拓展
1. 工具里显示搜索量为 0(Zero Search Volume)的长尾词,到底做不做?
结论:只要在 Google 下拉框或社区里真实出现过,且贴合你的高客单价产品或核心痛点,照样做。 第三方 SEO 工具的搜索量数据是靠抽样点击流和历史数据库推算出来的,天然存在滞后性,尤其是对于刚出现的新技术名词、新款产品型号、或者极其细分精准的 B2B 采购长尾词,工具里经常直接标为 0 或 N/A。实操中经常出现一个工具显示搜不到量的长尾问题词,文章发出去之后后台 Search Console 里每个月能稳定带来几十上百个极其精准的询盘流量。判断这类词有没有价值,看 Google 搜索框敲进去会不会自动提示补全、以及产品本身利润够不够支撑,而不是死盯工具上的数字。
2. 英文词的单复数、英式与美式拼写(如 customize vs customise)要分开布局吗?
不需要单独开页面。 现在的搜索引擎语义理解(NLP)已经非常成熟,Google 早就知道单复数和英美拼写变体指向的是同一个实体需求。
实操处理方式:先在目标市场做一次 SERP 核验,哪个拼写/单复数形式在当地搜索结果中占据主流,就把它作为核心词写进页面的 Title、URL slug 和 H1 里;另一个变体如果确实有部分人搜,只需要在正文介绍或 FAQ 部分自然提及一次即可。千万别为了凑关键词密度把两个拼写硬塞进同一个标题里(比如写成 Customize / Customise Tool),这样既像垃圾站,又严重拉低老外用户的点击意愿。
3. 能不能直接用 ChatGPT / Claude 等大模型来做英文关键词调研?
能用来辅助,但绝对不能用它替代数据工具和 SERP 验证。 大语言模型最大的坑在于“一本正经地胡说八道”。如果你让 AI 给你“生成高搜索量、低竞争度的英文关键词”,它给你的搜索量数字和难度评价全是在瞎编,因为它根本没有实时接入 Google Keyword Planner 或点击流数据库。
AI 在调研流程中的正确用法:
- 挖口语化表达与行业黑话:让 AI 扮演目标行业的老外采购/用户,列出他们寻找解决方案时会用的真实口语词。
- 批量做搜索意图打标与语义分组:把你清洗后的词丢给 AI,让它按照信息类、对比类、交易类进行批量分类。
可直接套用的高可用 Prompt 模板:
Role: You are a senior B2B buyer / end-user in the [填入你的具体行业,如 commercial HVAC] industry in the US.
Task: I am conducting keyword research for my website selling [填入你的核心产品].

1. Please list 20 specific pain-point phrases, technical slang, or problem-oriented queries that real practitioners actually type into Google when looking for solutions, troubleshooting, or comparing vendors. Avoid generic textbook terms.
2. Categorize each generated query into one of three search intents: [Informational], [Commercial Investigation], or [Transactional].
3. Briefly explain the underlying buyer expectation for each query in 1 sentence.

Output format: Markdown table.
结尾总结
把一整套谷歌SEO英文关键词调研实操流程跑顺之后你会发现,真正决定一个网站能不能拿到流量的,从来不是你买了多贵的会员工具,也不是你手里攒了几万行的 Excel 表格,而是你是否老老实实去看了前十名的真实搜索结果。放下对大词高流量的执念,通过社区和竞品抓准老外的真实搜索习惯,用脚本把垃圾词洗干净,再结合 SERP 意图和竞争度把词合理映射到每一个页面上。把这套流程当成建站和日常内容更新前的标准前置动作严格执行,比后期写了一堆没流量的文章再去痛苦改版重构,省力得多。