
高维向量数据库索引算法研究:向量库跑得慢?挑对索引是关键
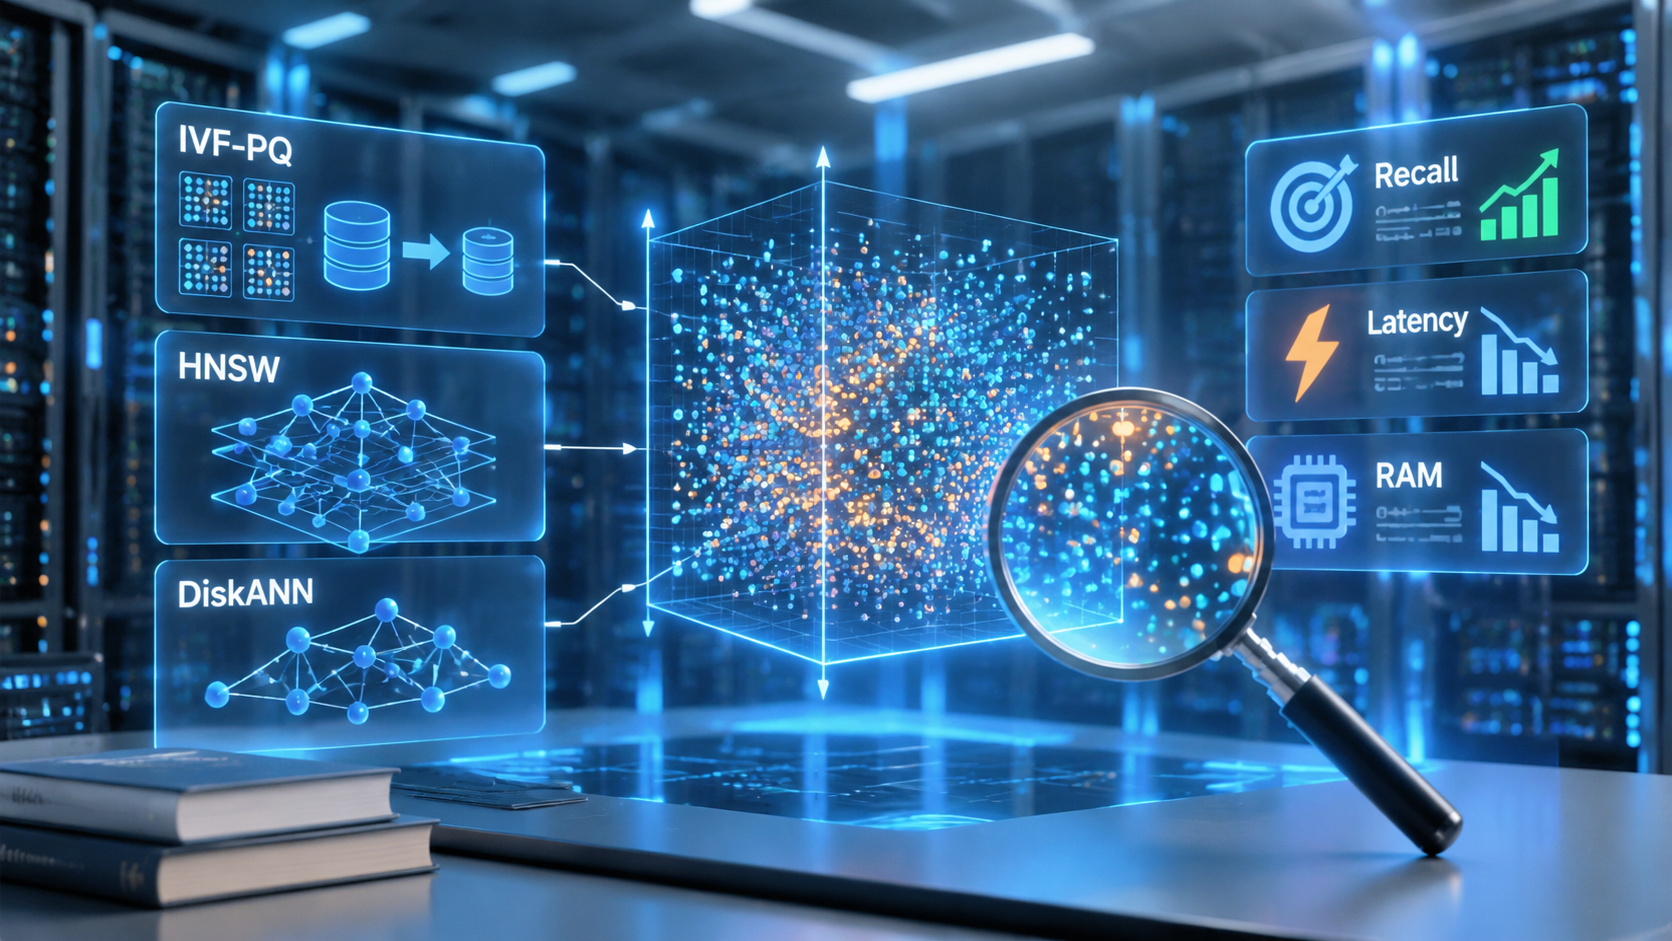
最近在帮几个做大模型应用(RAG)的团队做底层架构调优时,听到最多的抱怨就是:“向量一上千万,内存直接打爆,查询延迟飙到几百毫秒,这还怎么玩?”其实,抛开硬件配置不谈,90%的性能灾难都源于没吃透底层机制。这也是为什么高维向量数据库索引算法研究在当前生成式AI时代成了各家技术团队的必修课。搞明白向量索引不是为了发论文,而是为了在召回率(Recall)、查询延迟(QPS)以及内存开销(RAM)这个“不可能三角”中,给自己的线上业务找到那个最划算的平衡点。
一、 别再无脑暴力搜索了:维度诅咒到底怎么破?
很多刚接触向量检索的朋友,最开始用的都是最直观的FLAT(暴力检索)。原理很简单,就是拿目标向量跟库里的每一条数据算一遍余弦距离(Cosine)或欧氏距离(L2)。
在数据量只有几万条、向量维度只有128维时,FLAT表现极好,召回率100%。但现实很残酷:
- OpenAI的
text-embedding-3-large是3072维; - 开源常用的
bge-m3是1024维; - 一旦数据量冲到1000万,每次查询都要做上百亿次浮点运算。
高维空间带来的“维度灾难”会让几何直觉彻底失效——所有点之间的距离几乎都差不多大。为了在毫秒级内返回结果,学术界和工业界放弃了“绝对精确”,转向了ANN(近似最近邻搜索,Approximate Nearest Neighbor)。这正是索引算法的核心:用丢掉1%~2%召回率的微小代价,换取几十甚至几百倍的查询速度提升。
二、 主流向量索引算法横向拆解:谁是你的菜?
在真实工程落地中,我们接触最多的算法主要分为三大流派:基于树、基于量化(Compression/Quantization)、基于图(Graph)。KD-Tree这类经典树结构在维度超过30维后基本就退化成了线性扫描,这里直接略过,重点聊聊现在生产环境真正跑的三大主力。
1. IVF-PQ(倒排文件 + 乘积量化):穷鬼套餐,省内存之王
如果你的机器内存预算有限,但数据量有几千万甚至上亿,IVF-PQ是唯一的救命稻草。
- 原理:先用K-Means把高维空间聚合成几千个簇(IVF,倒排索引),查询时先定位中心点,只排查最近的几个簇;接着把长向量切成很多小段,每段用一个聚类中心ID来表示(PQ,乘积量化)。
- 优缺点:原本一个1024维的Float32向量需要4KB内存,量化后能直接压到128字节甚至更小,内存立省90%以上!代价也很明显:精度损失较多,建索引极其耗时,而且一旦数据分布剧烈变化,就得推倒重练。
2. HNSW(分层导航小世界图):性能怪兽,土豪首选
这是目前Milvus、Qdrant、ES等数据库默认首推的索引,也是大模型RAG场景下的绝对顶流。
- 原理:借用了跳表(Skip-List)的多层思想。最顶层图结构稀疏,节点间距大,用于“高速公路大跨步逼近”;越往下层越密集,到了最底层的Layer 0完成精细化搜寻。
- 优缺点:查询速度极快,在召回率做到98%以上的同时,单节点吞吐(QPS)能轻松破万。致命伤就一个——吃内存。HNSW不仅要把原向量常驻内存,还要额外存储大量的图拓扑关系(边),内存占用通常是原始数据的1.2到2倍。
3. SCaNN / NSG(变体图与混合索引):大厂自研的极致压榨
Google开源的SCaNN引入了非正交量化思想,在量化损失上更偏向于保留点积排序;NSG(单调搜索图)则进一步对图结构进行了剪枝,减少冗余路径。它们在超大规模并发场景下表现惊艳,但对运维和参数微调的工程要求极高。
核心索引算法生产指标对比表
| 索引类型 | 内存占用(RAM) | 查询延迟(Latency) | 召回率极限(Recall) | 索引构建耗时 | 适用业务场景 |
|---|---|---|---|---|---|
| FLAT | 低(仅原始数据) | 极慢(随数据线性上升) | 100% | 0(即插即用) | < 10万的小型本地检索 |
| IVF-PQ | 极低(压榨到10%~20%) | 中等(几十毫秒) | 85% ~ 95% | 极高(需全局训练) | 亿级规模、成本敏感型平台 |
| HNSW | 极高(常驻内存+边结构) | 极快(单毫秒级响应) | 95% ~ 99%+ | 中等偏高 | 毫秒级在线业务、RAG知识库 |
| DiskANN | 低(SSD存储为主) | 快(依赖NVMe随机IO) | 95% 左右 | 高 | 内存买不起但有高速SSD的折中方案 |
三、 运维视角:生产落地怎么挑?避坑三板斧
看了很多算法测试对比,一到生产环境还是抓瞎。作为负责过集群调优的老兵,建议大家遵循以下三套实操逻辑:
第一步:算算内存账,决定技术路线
先用公式粗暴预估: $$\text{基础内存} = \text{数据量} \times \text{维度} \times 4 \text{ bytes}$$
- 假设你有 2000万条 768维 的商品文本向量,裸数据就是 $20,000,000 \times 768 \times 4 \approx 61.4 \text{ GB}$。
- 如果选 HNSW,加上图结构和系统开销,必须准备至少 120GB ~ 150GB 的物理内存,否则系统分分钟OOM给你看。
- 如果服务器只有32GB内存,别犹豫,直接上 IVF-PQ 或者考虑 DiskANN(以SSD换内存)。
第二步:看更新频率,避开动态死穴
图索引(HNSW)在静态读多写少的场景下无敌,但如果你的系统频繁高并发增删改,图的动态加边、删节点重构开销非常大,会导致CPU占用长时间居高不下。
- 高频写入/实时流:推荐采用“内存Buffer(FLAT)+ 定期落盘构建大索引(IVF/HNSW)”的LSM架构。
- 低频更新/静态大库:直接上高参数构建的HNSW,把查询性能吃满。
第三步:搞懂这两个参数,调优立竿见影
在实际配HNSW时,很多人不知道怎么调参,记死这两个黄金参数:
M(每个节点的最大出度):一般设在16到64之间。值越大,高维召回上限越高,但内存和建索引时间成倍翻;通常文本类取M=16或32足够。efConstruction与efSearch(动态候选池大小):efConstruction影响建库质量,建议设在100~400,设完就不要改了;efSearch是线上运行时的调谐器。白天高峰期延迟高了,适当调小efSearch(如调到32),牺牲1%召回换取QPS翻倍;夜间低谷期调大以保证检索精度。
总结与选型决策指南
做向量数据库调优,没有哪个索引是绝对的“银弹”。高维向量数据库索引算法研究的本质,就是在算力成本、吞吐效率与召回精度之间玩“俄罗斯方块”。
- 预算充足、主打实时体验的AI问答业务,毫不犹豫选 HNSW;
- 百万级起步、动辄上亿但预算有限的爬虫监控、日志归档场景,老老实实用 IVF-PQ 节省开支;
- 如果本地机器既没大内存也没高端GPU,试试 DiskANN,在NVMe固态硬盘上也能跑出接近内存级的检索速度。
先把数据量级、更新频率和SLA指标列出来,再去选对应的算法,技术架构才不会在业务爆发时轰然倒塌。