
可解释性AI与因果推断研究:搞懂AI的想法,因果推断是关键
做了这么多年算法落地和技术运维,最怕业务方拿着报表跑过来问一句话:“模型为什么给这个用户拒贷了?”或者“为什么推荐系统今天突然抽风推这套内容?”这时候如果只是甩出一张特征权重图,对方大概率还是听不懂。其实一线技术人员心里都清楚,大部分所谓的模型解释只是在抓相关性,根本没摸到内在逻辑。这也是为什么最近两年可解释性AI与因果推断研究开始从论文堆走向实操业务——大家逐渐意识到,光靠给“黑盒”套马甲解决不了信任危机,唯有搞清楚底层真正的因果链条,AI才算真正能让人放心用。
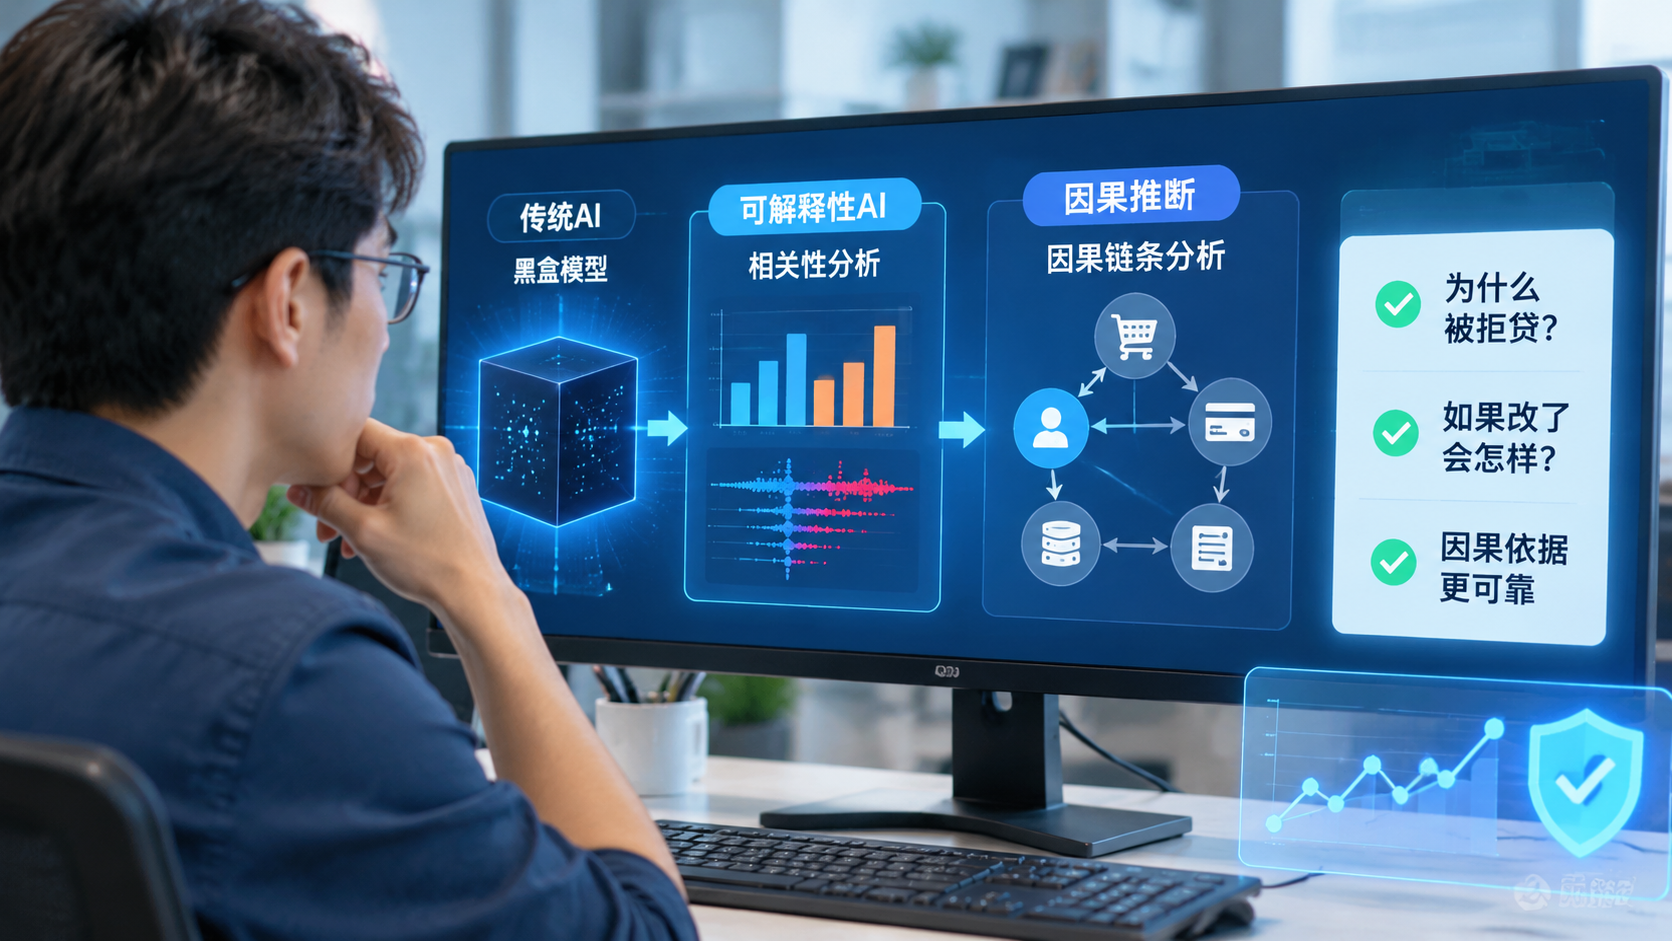
一、 传统可解释方案,为什么总觉得“差点意思”?
很多人聊到模型可解释性(XAI),第一反应就是调包:SHAP、LIME 拿来跑一遍,画个漂亮的蜂窝图或者条形图交差。
但实际部署到线上,你会发现这些工具经常“胡说八道”:
- 混淆了因果与相关:比如气温升高,雪糕销量和溺水人数同时上升。传统归因方法可能会告诉你,“溺水是因为雪糕卖多了”。这种荒谬的结论放在复杂业务里极难被察觉。
- 对抗样本脆弱:改动输入层一个对业务完全无关紧要的极小扰动,特征贡献度排名可能全盘洗牌。
- 无法指导“下一步该干什么”:业务方不仅想知道“为什么被拒”,更想知道“我改了什么才能通过”。传统归因给不出这种反事实(Counterfactual)结论。
二、 因果推断给AI补上了哪块拼图?
因果推断并不是什么新词,它在流行病学和计量经济学里早就被玩透了。把它引入可解释性AI研究,核心其实就解决三个层面的认知:
| 认知层级 | 核心动作 | 传统深度学习能做吗? | 因果可解释性怎么做? |
|---|---|---|---|
| 第一层:观察 (Association) | 看到A,预测B | 能(拟合概率分布) | “看到降价,销量上升” |
| 第二层:干预 (Intervention) | 如果强制做A,B会变吗? | 很难(受混淆变量干扰) | “如果我们把价格强制抬高10%,真实的留存是多少?” |
| 第三层:反事实 (Counterfactual) | 如果当初没做A,B现在会怎样? | 完全不能 | “如果这个用户当初没有逾期那一次,模型还会拒发信用卡吗?” |
如果AI模型只能停留在第一层,它就是一个高级的模式匹配机器;只有进入第二层和第三层,模型给出的解释才具备决策支撑价值。
三、 落地实操:如何把因果推断融进算法链路?
要把这套理论落到真实的工程架构里,别指望有现成的一键式工具,通常要分四步扎实推进:
1. 业务因果图(DAG)构建
不要一上来就搞全自动发现。最稳妥的方式是领域专家知识 + 约束因果发现算法(如 PC 算法、GES 算法)。
- 先把核心业务指标画出来:比如在风控场景下,年龄、收入、历史逾期、设备指纹之间谁指向谁。
- 把不可控变量(混淆因子)挑出来,标注清楚“禁止反向连接”的先验规则,防止算法跑出逆天逻辑。
2. 借助 SCM(结构因果模型)做归因重塑
在模型训练或解释阶段,把原本端到端的黑盒切开,套入结构因果模型:
- 消除伪相关:利用后门准则(Backdoor Criterion)控制住混淆变量,确保模型看到的特征权重是真的推动因,而不是搭便车的旁观者。
- 计算因果效应(ATE / CATE):评估某项特征对最终决策的边际因果效应,而不是统计上的边际贡献。
3. 生成可执行的“反事实解释”
这是最受业务团队欢迎的模块。例如给拒绝贷款的用户提供解释时,算法可以在因果图约束下计算:“在保持其他不可变特征(如年龄、学历)固定的情况下,用户需要降低多少负债率(可干预特征),模型判定即可从‘拒绝’变为‘通过’。”
目前业内实操中,像微软开源的 DoWhy 配合 EconML,或者针对反事实优化的 DiCE 库,都是非常顺手的脚手架。
4. 生产环境的“因果漂移”监控
传统的模型监控看的是特征分布漂移(Data Drift),比如通过 KS 检验或者 PSI 指标看输入分布变没变。但在复杂的分布式环境里,分布变了不代表模型失效。 引入因果推断后,运维监控的重点变成了:特征之间的因果机制是否发生了破裂。如果底层的因果机制没变,即使外部环境波动,模型的解释依然稳固;反之,一旦发现因果关系断裂,必须立即触发报警并重新介入训练。
四、 避坑指南:工程师最容易翻车的三个地方
- 不要妄想“纯数据驱动发现因果”:在样本量有限或存在未观测混淆变量(Unobserved Confounders)时,纯算法跑出来的因果图翻车率极高。业务先验一定要放进去做剪枝。
- 警惕计算开销:反事实推理涉及大量的优化求解,如果是毫秒级实时响应的高并发场景(如搜索推荐的即时召回),因果推断适合做离线分析、事后审计或者准实时的策略调优,千万别直接硬塞进在线计算引擎。
- 不要把相关性全盘否定:追求因果是为了安全和可解释,但如果你的首要目标只是在极短周期内刷高点击率,有时候强相关特征确实更立竿见影。两者的取舍取决于业务对“出错成本”的容忍度。
总结
可解释性AI如果脱离了因果推断,很多时候只是给黑盒外面画了层好看的贴纸,看似讲得通,实则经不起推敲。把因果推断研究扎扎实实地沉淀到建模规范和运维监控里,让系统说清楚“为什么这么判”、“改了会怎样”,AI才真正能从玩具变成让人放心的生产力工具。