
大模型微调技术PEFT与LoRA应用:别再全量微调了!单卡LoRA实战
最近好几个做业务开发的兄弟跑来问我:“公司想基于开源底座搞个垂直领域的客服/代码助手,但手里只有一张24G显存的3090,是不是根本训不动?”放在两年前,全参数微调动辄要几张A100起步,中小团队确实只能干瞪眼。但随着大模型微调技术PEFT与LoRA应用的全面普及,低成本、轻量化改造大模型早已不再是算法大厂的专属特权。
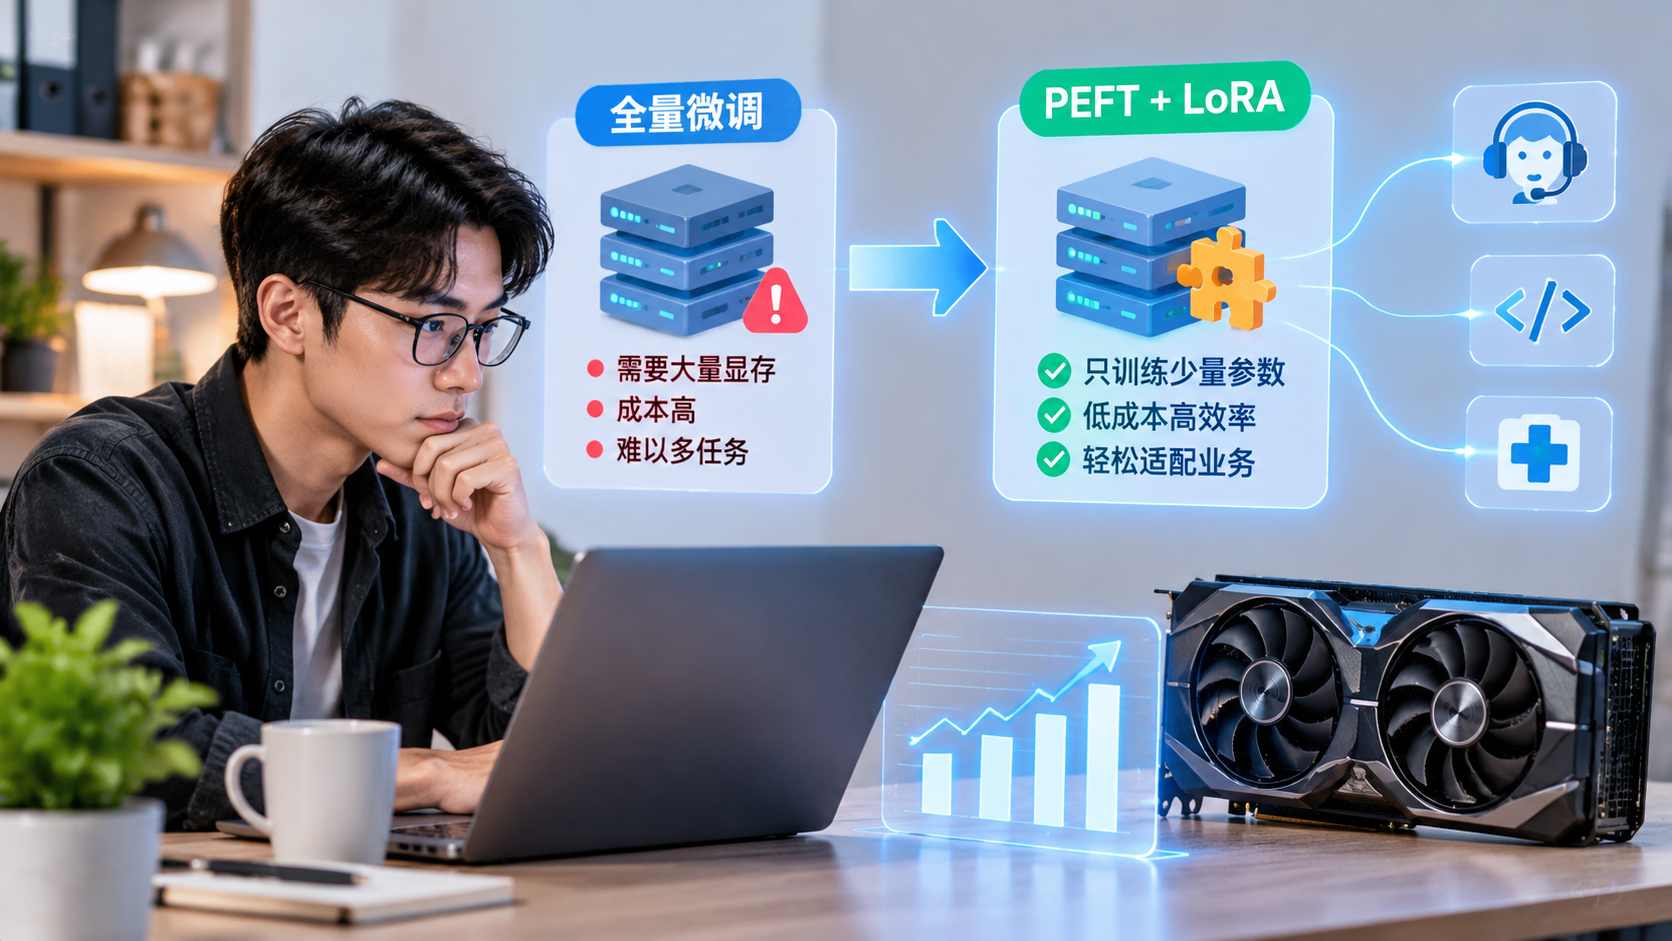
今天我就从实操和运维落地的视角,带大家把这套技术拆透,聊聊怎么用最低的硬件成本,把通用底座调教成贴合你业务的“专属专家”。
一、 为什么大家都在死磕PEFT?
先算一笔账:一个7B(70亿参数)的模型,如果做全量微调(Full Fine-Tuning):
- 模型权重占 14GB(FP16)
- 优化器状态(以AdamW为例)占 28GB~56GB
- 加上激活值(Activations)和梯度(Gradients),没个 80GB显存(A100/H800) 根本跑不起来。
更要命的是,如果你要针对5个不同的业务场景做微调,全量微调就得存5份完整的模型副本,硬盘和运维部署成本直接原地起飞。
这时候,PEFT(Parameter-Efficient Fine-Tuning,参数高效微调) 就成了唯一的解法。它的核心逻辑很简单:冻结原模型绝大部分参数,只训练极小一部分(通常不到1%)的附加参数。
大白话比喻: 全量微调就像为了给租来的房子改善采光,把整栋楼的承重墙全拆了重盖;而PEFT相当于在房间里加几盏智能补光灯,成本只有千分之一,效果却差不了多少。
二、 剥开LoRA的外衣:它到底是怎么省显存的?
在PEFT的所有流派里(Prompt Tuning、Prefix Tuning、P-Tuning等),目前工业界事实上的标准就是 LoRA(Low-Rank Adaptation,低秩自适应)。
很多人看论文里写的矩阵分解公式头大,其实原理极其直观:
假设模型某一层的核心权重矩阵是 $W_0$(维度是 $d \times k$)。在全量微调时,我们要更新一个同样大小的变量 $\Delta W$。 LoRA认为:大模型在适应特定下游任务时,参数变化的内在秩(Intrinsic Rank)其实很低。也就是说,很多维度的参数变化是冗余的。
于是,LoRA把 $\Delta W$ 拆成了两个极小的低秩矩阵相乘: $$\Delta W = B \times A$$
- 矩阵 $A$ 的维度是 $d \times r$
- 矩阵 $B$ 的维度是 $r \times k$
- 这里的 $r$ 就是所谓的“秩(Rank)”,通常设成 8、16或者32。
原始前向传播:    h = W0 * x
LoRA前向传播:   h = W0 * x + (B * A) * x * (alpha / r)
显存就是这么省下来的: 原本一个 $4096 \times 4096$ 的矩阵,有约 1670万 个参数需要计算梯度。如果取 $r=8$,那么 $A$ 加上 $B$ 的参数量只有: $(4096 \times 8) + (8 \times 4096) \approx 6.5万$ 个参数。 参数量瞬间缩水了250倍! 优化器状态和反向传播的计算量断崖式下跌,单张民用显卡自然就能跑了。
三、 实战避坑指南:LoRA核心参数怎么调?
不少新手用HuggingFace的 peft 库时,直接无脑抄网上的配置,结果要么训崩了(过拟合),要么完全学不会。下面这几个关键参数,建议根据业务场景调整:
from peft import LoraConfig

config = LoraConfig(
    r=16,                           # 秩大小:任务复杂选16-32,简单指令选8
    lora_alpha=32,                  # 缩放因子:通常设置为 2 * r
    target_modules=["q_proj", "v_proj", "k_proj", "o_proj"], # 作用模块
    lora_dropout=0.05,              # 防止过拟合的随机丢弃率
    bias="none",                    # 偏置项,一般保持"none"
    task_type="CAUSAL_LM"           # 因果语言模型(如LLaMA、Qwen)
)
1. r(Rank)和 lora_alpha 该给多少?
- 经验法则: 简单的风格变换、特定格式输出(如抽取JSON),
r=8足够;如果是医疗、法律等专业知识注入,建议拉到r=32或r=64。 - Alpha的设定:
lora_alpha相当于给LoRA权重加了一个放大系数。行业内最稳妥的搭配是保持 $\frac{\alpha}{r} = 2$。
2. target_modules 别只盯 q_proj 和 v_proj
早期LoRA论文只在Attention的Q和V矩阵上挂适配器。但实践证明,把Attention的全部层(q, k, v, o)以及MLP层(gate_proj, up_proj, down_proj)全挂上LoRA,效果远好于只挂Q、V。虽然显存占用会微涨10%~15%,但模型的理解和逻辑能力保留得更完整。
四、 生产落地:LoRA微调模型的部署策略
微调只是第一步,真正的考验在生产环境。用LoRA训练出来的产物非常小,通常只有几十兆到两三百兆(只有A和B矩阵的权重),部署时主要有两种打法:
| 部署方案 | 实现方式 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| 权重合并(Merge) | model.merge_and_unload() 将LoRA矩阵算回原权重并保存 |
零额外推理延迟,兼容vLLM、TensorRT-LLM等推理加速框架 | 多个任务需要存多份大模型底座 | 独立大业务,对响应速度(Latency)极其敏感 |
| 动态挂载(Multi-LoRA) | 显存中常驻一个Base模型,根据API请求动态加载不同的LoRA权重 | 极大节省显卡算力,单卡可同时承载数十个细分业务 | 推理框架需支持动态算子,高并发下管理较复杂 | SaaS平台、多租户系统、个性化助手 |
作为运维,如果你用 vLLM 部署,强烈推荐开启它的 multi-lora 支持。它允许在同一个服务实例里,并发调用不同的LoRA适配器,显存复用率直接拉满。
经验小结
大模型的技术演进非常快,但对于大部分中小团队和具体业务场景来说,LoRA配合PEFT依然是性价比最高、工程落地最稳妥的路径。
不要一上来就想着全量微调,也不要迷信超大规模的参数。先用几百条高质量的清洗数据,挂一个轻量级的LoRA跑一版baseline(基线),通过评测集看看模型是在“背答案”还是真的“学到了逻辑”。把数据清洗干净、超参调合理,一张消费级显卡调出来的模型,完全能在垂直场景里打出极其惊艳的表现。