
利用People Also Ask拓展问答长尾词:别买词表了,手把手教你扒PAA
做外贸独立站这六七年,我最烦看那些割韭菜的SEO课讲什么“全网拓词大法”。一堆新人兴冲冲花大几千买个Ahrefs或Semrush账号,导出一两万个Keyword Difficulty(KD)极高的大词,文章写得要吐血,半年过去流量还是个位数,询盘更是毛都没有。真正能给你带来高转化、高意向客户的,往往是那些月搜索量只有几十、但意向精准到骨子里的具体问题。今天不讲虚的宏观理论,只聊实操,教你如何彻底搞懂并利用People Also Ask拓展问答长尾词,顺便把我平时扒词和落地的流程全盘托出。
一、为什么第三方工具都比不上Google亲儿子PAA?
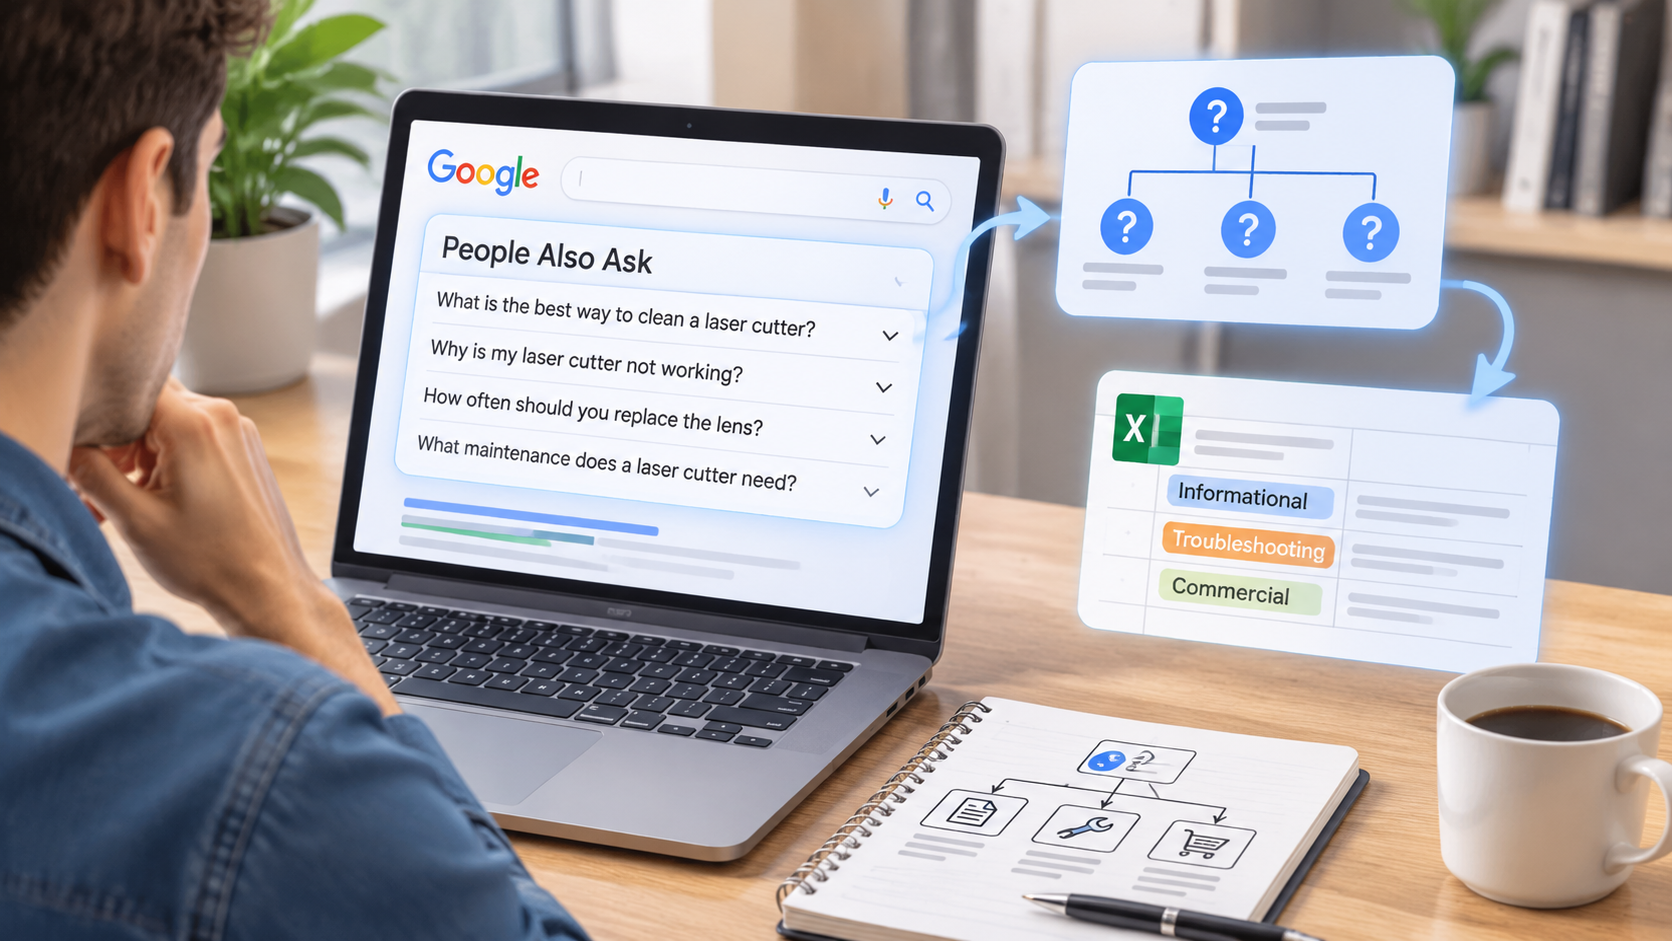
所谓的“People Also Ask”(大家还在问,简称PAA),就是你在Google搜一个词时,搜索结果中段那个带下拉箭头的小框。
第三方工具的词库再全,数据也是按月甚至按季度更新的,有严重的滞后性。但PAA不同,它是Google算法基于当前真实用户的搜索链路、会话上下文(Session Context)以及搜索意图图谱实时计算出来的。
更绝的是它的无限裂变机制: 你搜一个种子词,默认只出3到4个PAA。但你随手点开其中一个,底部立马会动态加载出另外2到3个关联更深的问题;你再点开一个,它继续裂变。这根本不是死板的数据库查询,这是Google直接把用户的思考路径一条一条掰碎了喂给你。利用好这套机制,你甚至不需要花钱买任何昂贵的SaaS工具,就能把一个细分行业的长尾问答池子彻底掏空。
二、别拿手去一个个点,教你低成本搞定批量抓取
要是靠人工在浏览器里一个个点开复制,手抽筋也搞不定几百个词。但如果去买市面上现成的采集工具,很多按查询次数收费,性价比极低。
作为平时习惯在Linux终端敲命令的人,我更倾向于直接用脚本解决。当然,市面上也有成熟方案,丰俭由人:
1. 轻量玩家:现有免运维工具
如果你不懂代码,别硬啃,推荐用现成的工具,比如 AlsoAsked.com 或者 SearchResponse.io。它们本质上也是通过Headless Chrome去模拟点击PAA的节点,然后把整张树状关系图导出来。缺点是免费额度很少,导几十个词就得掏腰包。
2. 硬核玩法:Python + Playwright/Puppeteer 自动化递归
懂点技术的站长,直接用本地环境或者找台低配的Linux VPS跑脚本。核心逻辑其实极其简单,根本不需要多复杂的算法:
# 核心伪代码逻辑示意(切记加延迟,否则极易触发Google验证码)
def scrape_paa(query, max_depth=3):
    # 1. 启动无头浏览器,访问Google SERP
    # 2. 定位 PAA 容器元素: div[jsname="yEVEwb"] 或类似特征类名
    # 3. 循环点击问题元素,触发DOM动态插入
    # 4. 监听新生成的DOM节点,将问题文本和折叠内容抓下来
    # 5. 去重后存入 SQLite 或直接写出 CSV
老站长踩坑提醒: Google对SERP页面的高频请求风控极严。如果你直接拿服务器IP裸奔狂刷,跑不过20次就会被弹reCAPTCHA,甚至直接返回429 Too Many Requests。要批量抓,要么给爬虫挂高质量的住宅代理(Residential Proxy),控制每个点击间隔在3-5秒之间;要么直接走合规的SERP API接口(如SerpApi或HasData),花点小钱买现成的解析结果,把精力留在后面的词组分类上。
三、洗词与分流:垃圾问答比没词更致命
很多人把PAA词扒下来后,一股脑全贴到网站上,这完全是在自杀。PAA里充斥着大量的意图重叠词和无意义的泛词,必须经过一道人工加自动化筛选。
我一般会把扒下来的词丢进Excel,按以下三类打标签:
| 问答词类型 | 典型特征(以工业阀门为例) | 对应落地页面承载方式 | 商业价值 |
|---|---|---|---|
| 纯信息型 (Informational) | "What is...", "Difference between X and Y" | 博客专题科普文、技术维基 (Wiki) | 低,但利于建立 Topical Authority |
| 故障/维护型 (Troubleshooting) | "Why is my valve leaking", "How to fix..." | 售后支持页面、排错指南博客 | 中,极易拿 Featured Snippet |
| 交易/对比型 (Commercial) | "Best valve for high pressure", "X vs Y price" | 产品聚合页 (Category)、深度评测页面 | 极高,询盘的主要来源 |
核心避坑点:避免关键词同质化(Cannibalization)
Google现在对“同义不同字”的理解已经非常聪明。例如:
- Question A: How to clean a laser cutting nozzle?
- Question B: What is the best way to clean laser cutter nozzles?
这俩词在PAA里经常同时出现,如果你为它俩各写一篇800字的文章,你的两个URL会在SERP里疯狂打架,最终双双掉出前50名。遇到这种词,立刻合并! 挑一个搜索量大、语感更顺的作为H2标题,另一个直接丢进正文第一句话里自然带过。
四、内容排版与结构化数据:如何把PAA做进内容里?
词拿到了,也归类了,到底该怎么把它们写到页面里?很多做外贸站的朋友直接把问答像字典一样堆在首页底部,这种上世纪的搞法早就失效了。
要想利用PAA拿到SERP顶部的“精选摘要”(Featured Snippet),你的内容排布必须遵循倒金字塔结构:
1. 答案置顶,废话删干净
外国采购商或者工程师搜一个具体故障,不是来看你抒情的。
- 错误写法: 遇到这个问题首先我们要追溯它的历史,随着现代工业的发展……(扯了三段才进主题)。
- 正确写法: 在H2或H3提出问题后,第一段必须在40到60个英文单词内直奔主题,给出确定性答案。然后再在第二段开始展开详细解释、原因分析或列出步骤(使用
<ul>或<ol>标签)。Google的抓取算法极度喜欢提取这种“直给”的段落作为Featured Snippet。
2. 必须做 Schema FAQPage 标记
虽然Google在2023年下半年对非权威站点的FAQ Rich Results(搜索结果直接展开折叠答案)做了一轮大清洗,普通商用站点展示富文本结果的概率降低了,但JSON-LD结构化代码依然是搜索引擎理解页面实体关系的核心通道。
页面底部安排3-5个与当前产品强相关的PAA问答,并注入如下格式的Schema代码:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "How often should you replace industrial air filters?",
    "acceptedAnswer": {
      "@type": "Answer",
      "text": "Typically, industrial air filters should be replaced every 3 to 6 months. However, in high-dust environments, monthly inspections and replacements are strongly recommended to prevent airflow restriction."
    }
  }]
}
</script>
五、老站长的实战总结
别去迷信那些动辄几十万词的虚假繁荣,海外流量现在越来越贵,泛词打不过大平台和维基百科。真正留给独立站的活路,就是靠深耕这些从PAA里抠出来的、充满真实使用场景的问答词。
每天花半小时,挑一个主推产品词,挖出深层的10个PAA,把它们嚼碎了融进你的产品页、分类页或者技术排错博客里。坚持跑两三个月,你会发现后台Search Console里那些千奇百怪的精准长尾词展示量会呈阶梯式往上窜,进来的流量全是带着明确采购意图或者解决问题需求的真人——这才是独立站SEO最有意思、也最见效的地方。
相关文章
- 长尾关键词布局逻辑:别死磕大词,实战长尾词布局逻辑
- 搜索意图深度对齐:搜索意图深度对齐:老站长的爆文底层逻辑
- 高转化商业词筛选方案:别盯着流量了,能变现才叫SEO
- 关键词竞争度硬核评估:避开SEO虚假指标:老站长的关键词竞争度硬核评估手册
- 语义相关词LSI优化策略:拒接无脑堆词:老站长聊透LSI语义优化
- 零位排名抢占技巧:霸占谷歌首页:零位排名实操全攻略
- 低权重站暴力蹭流法:新站没权重?老站长教你暴力蹭流
- 关键词排名骤降排查路径:排名暴跌?老站长的深夜救命手册
- 谷歌核心算法波动复盘:谷歌算法波动复盘:老站长的自救与避坑指南
- 多语言外贸站选词陷阱:避开多语言外贸站选词陷阱:老站长的跨境SEO避坑实录