
AI驱动的全栈网站开发实战:一个人用AI做网站的真实搞法
过去如果有人说“一个人三天做完一个高并发、自带SEO优化、功能完整的SaaS网站”,大家多半觉得这是吹牛。但在大语言模型深度渗透开发流程的今天,AI驱动的全栈网站开发实战已经不再是极客的技术玩具,而是切切实实降本增效的生存技能。作为长期泡在服务器架构、搜索引擎爬虫逻辑和AI工具链里的老兵,今天我想抛开那些花里胡哨的理论,站在一个“既懂代码又懂SEO和运维”的角度,把这套打通需求、编码、部署、收录的全流程实战经验完完整整拆解出来。
一、 技术选型:把AI的“舒适区”当成你的“生产力”
在开始写第一行代码前,很多新手最容易踩的坑就是随心所欲选技术栈。做AI驱动的全栈开发,核心逻辑只有一条:选择AI语料库里最成熟、最标准、最不容易出错的技术栈。
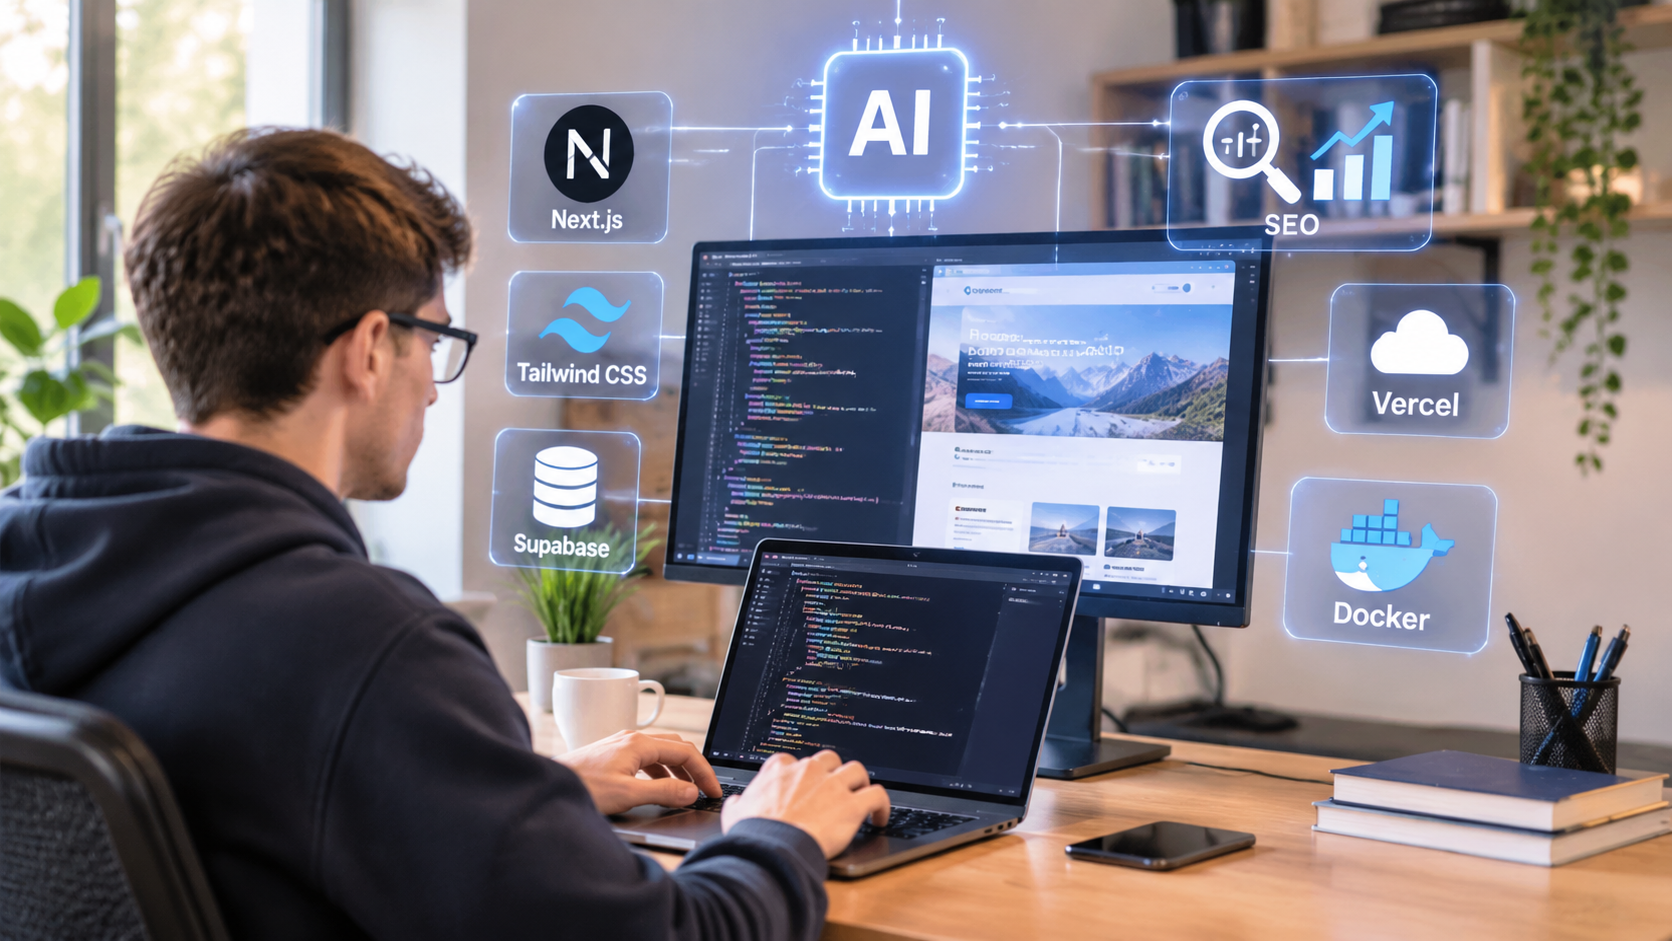
- 前端与全栈框架:首选 Next.js (App Router) 或 Astro。为什么?第一,Next.js在GitHub上的开源代码极多,GPT-4o或Claude 3.5 Sonnet对其API特性的掌握极为精准;第二,对SEO极为友好,天然支持服务端渲染(SSR)和静态站点生成(SSG),Google和百度的爬虫抓取起来毫无阻力。
- 样式与UI:Tailwind CSS + shadcn/ui。不要再让AI帮你写冗长的CSS文件了,Tailwind的原子化类名简直是为AI天生打造的,直接让AI在JSX里生成样式,错误率极低,而且加载体积小。
- 后端与数据库:Supabase (PostgreSQL) + Prisma / Drizzle ORM。Supabase直接提供了用户鉴权(Auth)、Row Level Security(行级安全)和数据库接口,配合ORM,AI可以一键生成数据模型和迁移脚本。
- 部署与基建:Vercel / Cloudflare Pages + Docker,结合自动化CI/CD,省去繁琐的Nginx配置。
二、 实操演练:如何用AI把全栈代码“榨”出来
开发过程中,切忌直接向AI扔一句“帮我写一个电商网站”,这只会得到一堆无法运行的玩具代码。真正的实战需要分步执行:
1. 结构化提示词约束上下文(.cursorrules)
以目前最主流的AI编辑器Cursor为例,必须在根目录配置规则文件。明确告诉AI:
- 语言:TypeScript(强类型可以借助编译器自动帮AI纠错);
- 规范:必须遵循函数式组件、使用Tailwind、API返回格式统一为
{ code, data, msg }; - 安全红线:严格禁止在前端代码中暴露
SUPABASE_SERVICE_ROLE_KEY等敏感凭证。
2. 数据建模与API搭建
让AI先做“数据库架构师”。
Prompt示例:“请基于Prisma设计一个博客+用户付费订阅系统的数据表,包含User、Post、Subscription模型,考虑SEO需求(需包含slug、metaTitle、metaDescription字段),给出完整的schema.prisma文件。”
拿到模型后,再让AI基于Schema编写API端点。由于有类型约束,AI生成的代码准确率能直接飙升到90%以上。
3. 前端交互与状态管理
结合成熟的UI库,用AI生成页面时,尽量“小步快跑”。先让它写骨架:Header、Hero区、内容瀑布流,再让它补充客户端交互(如SWR数据请求、表单验证与错误Toast提示)。当代码报错时,直接把控制台日志贴回给AI,它能在几秒钟内定位到是服务端渲染导致的水合报错(Hydration Error)还是空指针异常。
三、 运维护航:不让AI代码在生产环境“翻车”
AI写出的代码往往能跑,但防御性极差。运维和安全意识必须由人类把控:
- 安全审查:AI特别容易漏掉接口鉴权。所有涉及增删改查的API,必须强制让AI检查用户Session和权限,杜绝IDOR(不安全的直接对象引用)漏洞。
- 环境变量隔离:区分
.env.local与生产环境变量,自动化脚本必须确保API Key绝不上库。 - 监控与自愈:利用Sentry捕获前端异常,通过Logtail或Cloudflare Logpush收集日志。当线上出现高频报错,将报错堆栈和前后文打包丢给AI,让它直接提供Hotfix补丁,通常5分钟内就能完成故障排查与修复。
四、 SEO与增长:从开发第一天就把流量刻进代码里
很多全栈开发者做出的网站技术很炫,但根本没有流量,就是因为缺乏SEO思维。在AI全栈开发中,SEO是可以完全自动化的:
- 动态元数据与结构化数据(Schema Markup):
在Next.js中,利用AI自动编写
generateMetadata函数,根据页面内容动态提取关键词和描述;同时让AI直接生成合规的JSON-LD代码(如Article、FAQPage、Product结构化数据),让Google更容易识别富媒体摘要(Rich Snippets)。 - 程序化SEO(Programmatic SEO):
借助AI批量处理海量长尾词需求。通过写一个简单的Node.js脚本,调用LLM针对不同城市、不同行业或不同应用场景,批量生成高质量、无明显AI味道的落地页(Landing Page),并利用Next.js的
generateStaticParams预渲染成成千上万个轻量HTML页面。 - 性能压榨(Core Web Vitals):
搜索引擎极度看重页面速度。让AI帮你审查LCP(最大内容渲染)和CLS(累积布局偏移),它会建议你给图片加上
priority、用next/font优化字体加载、将非关键脚本打上defer,轻轻松松把PageSpeed跑分拉到95分以上。
五、 结语
所谓的AI驱动的全栈网站开发实战,并不是指程序员退化成只动嘴皮子的“指挥官”,而是变成了一个身兼架构师、项目经理、安全官和SEO专家的“超级个体”。AI抹平了语法记忆的壁垒和样板代码的枯燥,把真正决定网站生死的权利——业务逻辑、用户体验、系统稳定性和流量增长,交还到了开发者手里。把握好这套节奏,一个人就是一个正规军团队。
相关文章
- 非结构化文档RAG切片策略优化:非结构化文档RAG切片优化
- Dify与FastGPT私有化部署对比测评:Dify与FastGPT实测
- 大模型API接口限流与重试机制设计:大模型API限流与重试实战
- AI代码助手内网私有化接入方案:AI代码助手内网私有化实战
- 多模态模型OCR文档解析落地实战:多模态OCR文档解析实战指南
- GPU算力服务器Docker环境快速配置:GPU算力Docker快速配置
- 大模型幻觉检测与内容安全过滤:搞定大模型幻觉与内容安全过滤
- 企业级AI智能客服低代码搭建流程:企业AI智能客服低代码实操
- DeepSeek接口接入现有业务系统实操:DeepSeek接口接入实操
- Ahrefs API结合大模型挖掘内容Gap:别导表了,让AI自动扒对手词