
通用人工智能AGI演进路径:搞懂AGI到底得经历哪几步
很多人在聊到大模型时,张口闭口就是通用人工智能快来了,但如果你去问一个真正做底层算法或者搞高并发集群运维的工程师,大家通常只会苦笑。搞清楚通用人工智能AGI演进路径,不仅是学术界和头部大厂定战略的核心参照物,也是我们判断当下AI技术究竟卡在哪个具体环节的关键标尺。坦白说,从今天只会根据概率“猜下一个字”的语言模型,到真正具备自我意识、能够像人一样在未知物理世界里独立解决复杂问题的AGI,中间横跨着好几道几乎可以说是认知层面的鸿沟。
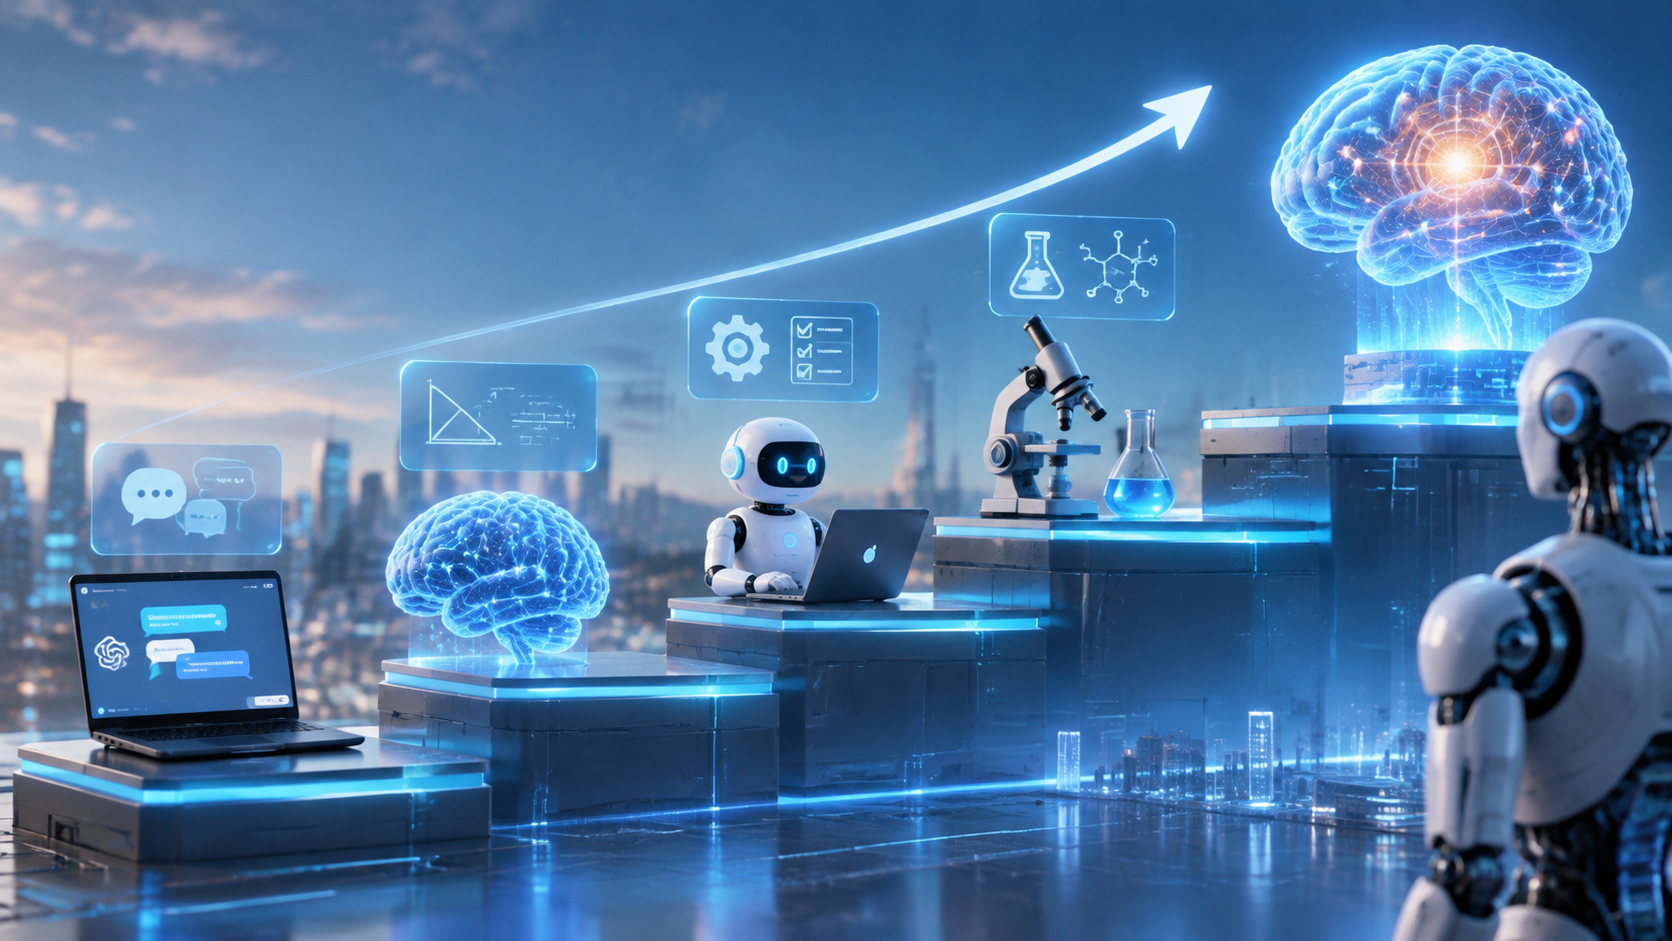
这篇文章不画大饼,结合当下的工程瓶颈与技术突破,把这条路拆解开来仔细盘盘。
一、 行业公认的五级台阶:我们究竟走到哪一步了?
OpenAI内部曾把AGI的演化划分为五个明确的层级,这个分级框架是目前行业内比较认可的锚点:
| 等级 | 名称 | 核心能力特征 | 代表产品/技术现状 | 状态 |
|---|---|---|---|---|
| Level 1 | 会话型 AI (Chatbots) | 具备流畅的自然语言交互能力,上下文理解 | ChatGPT (GPT-3.5), Claude早期版本 | 已成熟普及 |
| Level 2 | 推理者 (Reasoners) | 能进行复杂的思维链推导、自我纠错、解数学题与编程 | OpenAI o1/o3, DeepSeek R1 | 正在爆发期 |
| Level 3 | 代理人 (Agents) | 能长时间自主规划、调用系统工具、在数字世界完成端到端任务 | AutoGPT, 各类Cursor式自主编码Agent | 工程落地初期 |
| Level 4 | 创新者 (Innovators) | 能够自主提出假设、做实验、在未知领域做出科学发现 | AlphaFold, 自动化AI科学实验室探索 | 实验室萌芽期 |
| Level 5 | 组织级 (Organizations) | 能协同运作一个复杂实体(如自主运营整个科技公司) | 尚无实体案例 | 纯概念阶段 |
目前业界的现实是:大部队刚刚从Level 1完全跨进Level 2,正在死磕Level 3的稳定性。
去年大家还在迷信盲目堆参数的Scaling Law(缩放定律),觉得只要芯片够多、网页文本吃得够多,智能就会无限涌现。但事实证明,公网高质量文本已经被抓取殆尽,纯靠预训练参数扩张带来的收益正在肉眼可见地放缓。行业转向了测试时算力(Test-time Compute)与强化学习(RL)驱动的长思维链推理,这也就是为什么DeepSeek-R1和OpenAI o系列能引发如此大震动的原因——它撬开了通往下一阶段的侧门。
二、 突破瓶颈:演进路径上的三大技术路线并进
如果仅仅停留在“文本输入-文本输出”,机器永远只是一个活在服务器机房里的虚拟缸中之脑。完整的演化路径必然由以下三驾马车共同拉动:
1. 从“语言统计”转向“自建世界模型(World Models)”
图灵奖得主Yann LeCun一直公开反对纯自回归LLM能够走向AGI。人类婴儿不需要阅读几万亿token的书籍,只要推倒几次积木,就能本能理解重力、刚体碰撞、空间连续性。
- 现状痛点: 现在的模型逻辑经常出现常识性幻觉,根源在于它理解的是“语言学符号的相关性”,而非真实客观规律。
- 演进方向: 引入联合嵌入预测架构(JEPA)以及具备时空连贯性的视频生成底模(类似Sora这类尝试),让AI在大脑内部能够进行物理推演,而不是纯粹拼凑词语。
2. 从“单机文本处理”转向“具身智能(Embodied AI)”
真正的智能必须跟物理环境有闭环反馈。没有肉身,很难理解痛感、价值与生存意愿。
- 软件必须进入机器人、自动驾驶仪等物理载体中。
- 演进逻辑:数字大模型 $\rightarrow$ 机器人控制大模型(VLA架构,视觉-语言-动作) $\rightarrow$ 复杂物理世界的闭环操作与实时感知交互。
3. 神经符号AI(Neuro-Symbolic AI)的融合
深度学习是“黑盒”,擅长模糊感知和泛化直觉;传统符号AI是“白盒”,擅长严密逻辑推演、数学运算和形式化验证。
- 纯粹依靠神经网络解决不好100%确定性的安全生产问题。
- 未来必将是:用神经网络负责“直觉感知”,用符号逻辑系统充当“超级严谨的安全壳与验证器”。
三、 基础设施视角下的硬核掣肘:算力、能耗与高质量数据墙
作为技术运维人员,我们从服务器监控后台看到的数据往往最残酷。模型参数从几十B扩到几百B乃至万亿,带来的并非只是算法优化,而是物理层面的严峻挑战:
内存墙与互联带宽危机
现在的痛点不是GPU单核算力不够强,而是芯片间的数据传输速度跟不上(NVLink、RoCE网络的拓扑开销)。大规模推理的显存墙(Memory Wall)导致高并发时成本呈指数级上升。电力瓶颈直接卡死数据中心部署
算力中心的本质是能源转换器。未来千兆瓦级(Gigawatt)AI数据中心去哪里找绿电?这也是为什么海外巨头都在抢着锁定核电厂的原因。能源网络,很可能是AGI路线图上最容易被忽视的硬指标。合成数据(Synthetic Data)与数据污染
互联网上到处充斥着AI生成的垃圾内容。如果下一代模型用上一代模型生成的幻觉数据继续回炉训练,就会引发可怕的“模型自噬崩溃(Model Collapse)”。如何用形式化验证和高质量代码构建纯净的合成数据流水线,决定了后训练(Post-training)的质量上限。
四、 常见疑问答疑(FAQ)
Q:既然深度学习有极限,AGI到底什么时候能真正到来?
A: 业界理性派普遍把时间节点锁定在 2030至2035年 之间。我们大概率会在2027年前后看到各领域高度好用的Level 3 Agent系统(能够独立完成全栈项目交付或长链条科研辅助),但要达到能够自主开创新理论、无视行业边界的Level 4以上,技术体系还需要经历一次底层架构的彻底重构。
Q:我们普通人或者普通开发者,如何看懂这条演进路径?
A: 别被营销号的“下周AGI就要毁灭世界”带着走。重点盯紧三个风向标:
- 模型推理时的单Token成本与响应延迟是不是在断崖式下跌;
- 机器人(具身智能)在真实复杂非结构化环境(比如收拾混乱的厨房)里的任务成功率;
- 大模型在长达数万行的工业级代码重构中,能否不借助人工干预,一次性跑通全部单元测试。
通用人工智能不是哪一天早上醒来突然从天而降的“机械降神”,它一定是顺着上述工程与理论路径,一步一个脚印,从修剪代码、跑通机器人步态,再到解决一道道未知物理题中慢慢拼图成型的。