
神马蜘蛛User-Agent识别与放行:别乱拦了,教你搞定神马蜘蛛放行
最近帮一个做外贸转内销的朋友排查服务器,发现他网站移动端收录基本瘫痪。翻看Nginx日志才发现,他装的那套防CC防火墙把国内移动端的大户——神马搜索的爬虫,当成恶意扫描器给全拦在门外了。很多站长做国内站或者双轨多语言站点时,经常在安全策略上走极端:要么门户大开被采集狗薅秃,要么规则一刀切把正规搜索引擎打成403。今天这篇就专门聊透神马蜘蛛User-Agent识别与放行,顺便把我线上跑了几年的自动化过滤规则贴出来,省得大家继续踩坑。
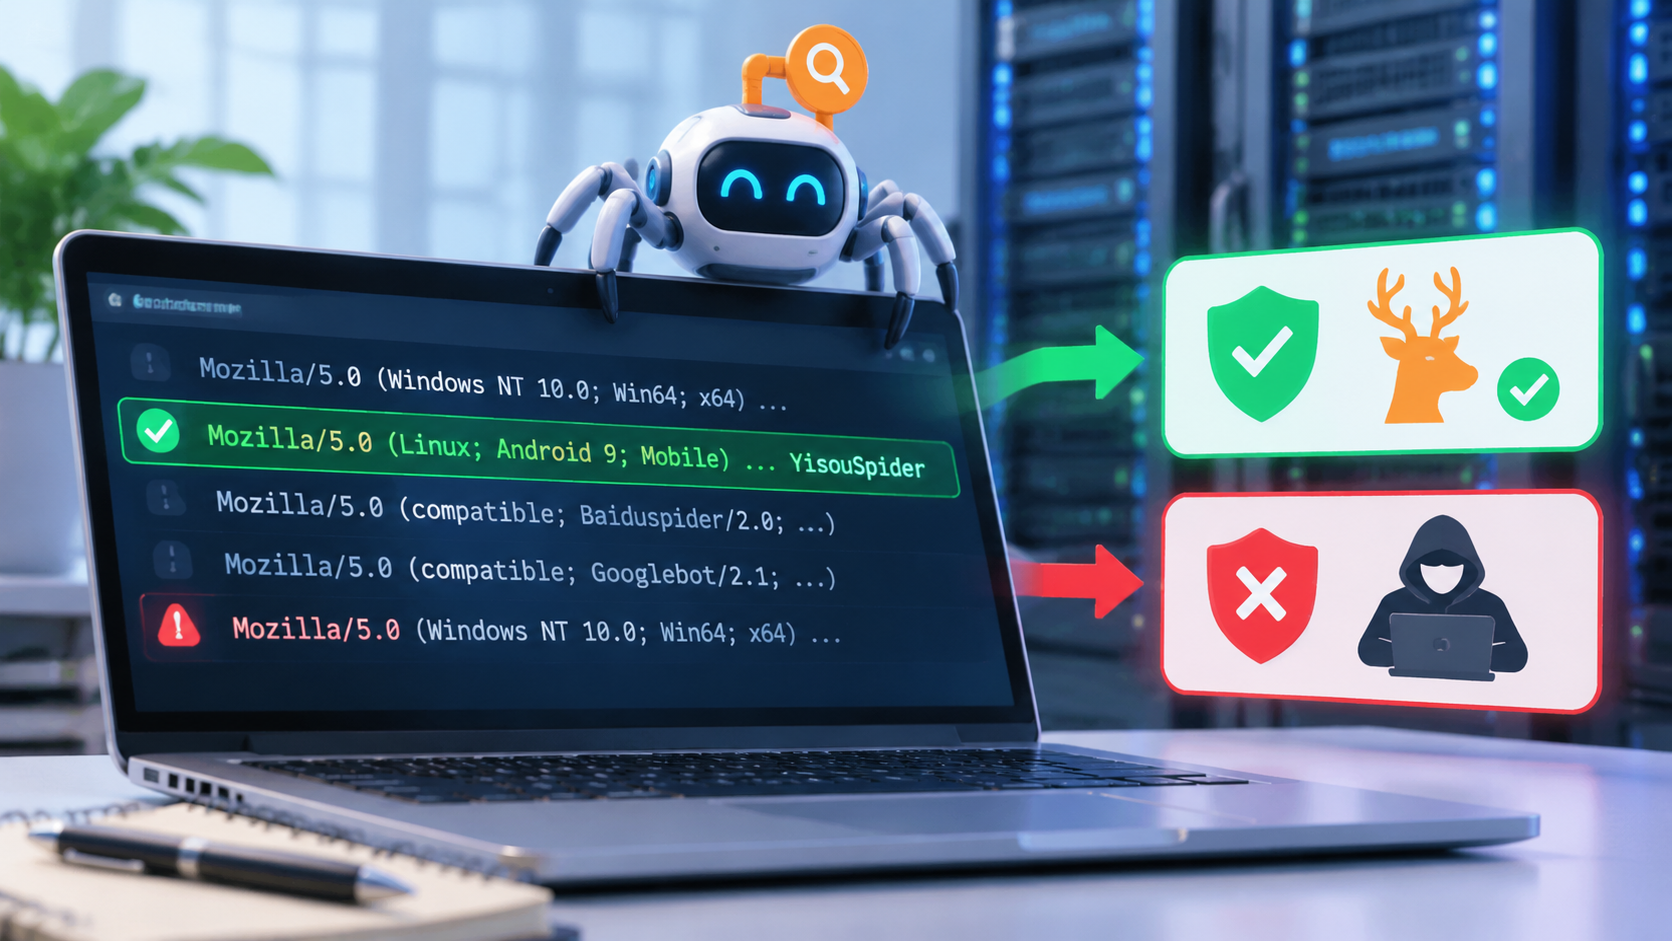
搞清正牌神马蜘蛛的UA标识
神马搜索背靠UC和阿里,国内移动端的流量权重不低。神马蜘蛛的抓取标识其实挺固定,核心关键词就是 YisouSpider。
市面上常见的正规神马爬虫UA长这样:
Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/69.0.3497.100 Safari/537.36 YisouSpider或者带移动端特征的:
Mozilla/5.0 (Linux; Android 9; Mobile) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/76.0.3809.111 Mobile Safari/537.36 YisouSpider识别重点只有一个:User-Agent字符串里必须包含 YisouSpider(大小写一定要兼容处理)。
但我必须提个醒:千万别看到UA包含YisouSpider就无脑开绿灯。
现在的低端采集脚本越来越贼,90%的爬虫脚本头都挂着神马、百度或者谷歌的UA。如果你在Nginx里单凭 $http_user_agent ~* "YisouSpider" 就直接跳过所有防刷限频规则,我保证不出三天,服务器CPU就被一帮伪装成蜘蛛的采集软件干到100%。
如何分辨“李逵”与“李鬼”?
要做到既不错杀、又不放过恶意采集,光看UA不够,得配合反向DNS或者IP段双重校验。
1. 手动验证:反向DNS查询(最准)
拿到一个疑似神马蜘蛛的IP(假设是 42.156.136.24),登录你的Linux服务器终端,直接用 host 或 dig 命令查反向解析:
host 42.156.136.24如果返回的主机名后缀是 *.sm.cn(比如 42-156-136-24.spider.sm.cn),并且你再拿这个域名反查IP能对得上,这就是正规军。
如果返回的是阿里云普通ECS、腾讯云轻量机、甚至是海外VPS的PTR记录,直接封死,这铁定是伪装UA的采集机器。
2. 常用官方IP归属段
神马蜘蛛的IP主要分布在阿里云的机房,常见网段包括但不限于:
42.156.136.0/2442.156.138.0/2442.120.160.0/24106.11.152.0/24
生产环境实操:Nginx放行与限频配置
很多运维新手喜欢在宝塔或者WAF控制台里点点鼠标,但最可靠、执行效率最高的永远是写在 Web 容器底层的规则。
下面是我在生产服务器(Debian / Ubuntu + Nginx)上的通用处理逻辑:优先放行真UA,但必须压制抓取频率,同时隔离假蜘蛛。
第一步:在 nginx.conf 的 http 块中定义白名单变量
不要把判断逻辑散落在每个 server 块里,用 map 统一处理:
http {
    # 匹配合法的搜索引擎UA,设置标记为1
    map $http_user_agent $is_legit_spider {
        default 0;
        ~*YisouSpider 1;
        ~*Baiduspider 1;
        ~*Googlebot 1;
    }

    # 针对神马等爬虫建立独立的限速池,防止它抓得太狠把数据库打挂
    limit_req_zone $binary_remote_addr zone=spider_limit:10m rate=10r/s;
}
第二步:在具体站点的 server 块做拦截与放行
server {
    listen 80;
    server_name yourdomain.com;

    # 1. 拦截空UA或明显的恶意工具UA
    if ($http_user_agent ~* "^$" ) {
        return 403;
    }

    # 2. 针对神马蜘蛛的处理策略
    location / {
        # 如果是神马蜘蛛,走专属限速通道(允许突发并发,但限制平均速率)
        if ($http_user_agent ~* "YisouSpider") {
            limit_req zone=spider_limit burst=20 nodelay;
        }

        try_files $uri $uri/ /index.php?$args;
    }
}踩坑吐槽:神马蜘蛛有时候抓取逻辑挺粗暴,半夜三更突然几百个并发扫你的聚合标签页或动态搜索页。所以就算确认是官方蜘蛛,也一定要套上一层
limit_req。真蜘蛛被限频会返回503,它收到后自己会退避放慢节奏,但如果你的PHP-FPM进程全被占满,挂掉的可是整台机器。
常见WAF防火墙放行规则写法
如果你前面挂了防护软件,没走纯Nginx规则,照着下面这个逻辑配:
1. 宝塔网站防火墙(Nginx免费/付费版)
不要直接在“User-Agent白名单”里瞎加通配符。
- 进入宝塔防火墙设置 -> 蜘蛛池/爬虫白名单。
- 勾选“神马搜索”。宝塔自带的特征库会结合IP做初步核实。
- 如果你手动写自定义规则,规则表达式写:
ARGS_USER_AGENT Contains "YisouSpider",动作选放行(白名单),但优先级要排在“黑名单IP”和“高危漏洞防护”之后。
2. Cloudflare / CDN 防火墙规则 (Custom Rules)
虽然神马主要爬国内,但有些站长用Cloudflare解析全站流量。如果神马蜘蛛抓取超时,大概率被CF的 Managed Challenge(托管质询)给卡死了。
在 Cloudflare 的 Security -> WAF -> Custom rules 增加一条:
- Rule name:
Allow-Shenma-Spider - Expression:
(http.user_agent contains "YisouSpider" and cf.client.bot) - Action:
Skip(跳过质询和其余安全规则)
注意这里一定要加上 cf.client.bot 校验。Cloudflare有自己的“已知良好爬虫数据库”,把UA匹配和Verified Bot结合起来,能直接把伪造神马UA的垃圾扫描器挡在Cloudflare边缘节点之外。
站长日常排查清单
放行配置改完以后,别扔着不管,过24小时去查下收敛情况:
- 看返回状态码:grep日志看神马爬虫的请求记录:
grep "YisouSpider" /var/log/nginx/access.log | awk '{print $9}' | sort | uniq -c健康的分布应该是绝大多数是
200,偶尔有少量304或超频时的503。如果出现大批量的403、444或502,说明你的WAF还在误伤,或者后端被它打崩了。 - 看抓取路径:神马如果一直抓后台敏感路径(如
/wp-admin/或/api/),记得在robots.txt里做明确 Disallow。正规的神马蜘蛛非常尊重robots协议。 - 定期剔除坏IP:一旦在日志里看到神马UA但是请求的是
.env、eval-stdin.php、.git/config这些扫描字典,反手就把对应IP扔进系统的iptables永久黑名单。
做网站运维不是搞学术研究,追求的永远是最低的服务器开销换最高的搜索引擎收录。老老实实把UA过滤、反向验证和限流策略搭好,既不给垃圾爬虫当温床,也绝不把正经流量拒之门外。