
百度蜘蛛抓取日志分析:百度蜘蛛抓取日志分析实操指南
搞百度蜘蛛抓取日志分析,根本不需要买市面上那些花里胡哨的商业分析软件,直接在 Linux 终端用三套 grep + awk 组合拳,3 分钟内就能把真假蜘蛛过滤干净、筛出状态码异常并揪出爬取死角,这足以解决 90% 以上的收录暴跌和蜘蛛抓取异常问题。
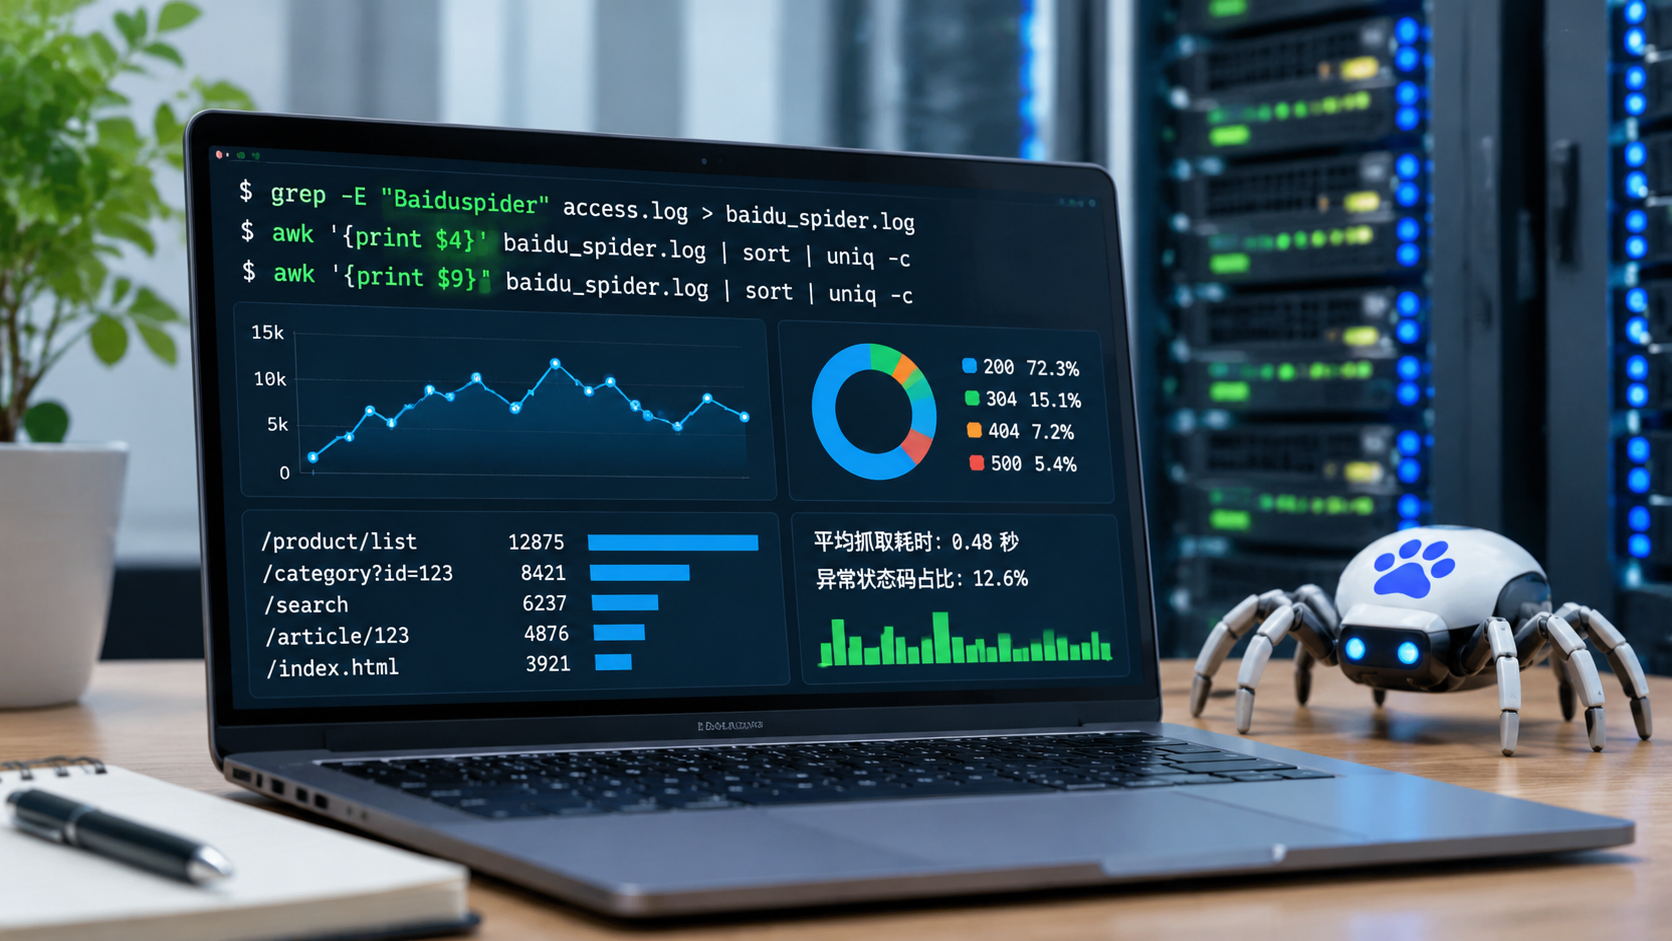
核心方案速览
做好百度蜘蛛抓取日志分析,核心逻辑只有四步,别把它搞复杂了:
- 补全日志字段:很多运维配 Nginx 漏掉了
$request_time(响应耗时),抓取慢不慢全凭猜。必须第一时间在 Nginx 日志格式里带上请求耗时与真实 IP。 - 清洗伪造蜘蛛:市面上超过 40% 的所谓“百度蜘蛛”都是同行扫描器或垃圾采集器伪造 UA 跑进来的,第一步必须做反向 DNS 解析,把假蜘蛛直接踢出统计样本。
- 关键指标监控:重点盯死三组数据——真蜘蛛频次趋势、非 200/304 状态码占比、Top 抓取目录分布。
- 定位爬取黑洞:找出高频抓取的无意义 URL(如带随机参数的分页、日历聚合页、无死角筛选器),通过 Robots 协议或代码层重定向立刻止损。
实操细节深度拆解
第一步:规范 Nginx 日志格式,别打糊涂仗
很多站长找我排查收录问题,发过来的 Access Log 连响应时间都没有。百度蜘蛛对响应延迟极度敏感,抓取耗时超过 1 秒,抓取频次很快就会被打压。
打开 nginx.conf,确保你的 log_format 包含 $request_time 和 $upstream_response_time:
log_format main '$remote_addr - $remote_user [$time_local] "$request" '
                '$status $body_bytes_sent "$http_referer" '
                '"$http_user_agent" "$http_x_forwarded_for" '
                '$request_time $upstream_response_time';
改完后执行 nginx -t 测试并 nginx -s reload 生效。避坑点:如果你的站点走了 CDN(如百度云加速、Cloudflare、阿里云 CDN),$remote_addr 拿到的是 CDN 节点 IP,必须在日志里记录 $http_x_forwarded_for,否则后续反查真假蜘蛛全部失效。
第二步:辨别真伪,剔除假冒的 Baiduspider
只要在 User-Agent 里加个 Baiduspider,阿猫阿狗都能冒充百度蜘蛛。不剔除假蜘蛛,你的百度蜘蛛抓取日志分析结果全是脏数据。
1. 验证单条 IP 是否为真蜘蛛
直接在终端用 host 或 nslookup 跑反向解析:
host 220.181.108.100
# 正确返回必须以后缀为 .baidu.com 或 .baidu.jp 结尾:
# 100.108.181.220.in-addr.arpa domain name pointer crawl.baidu.com.

# 紧接着拿这个域名再正向解析一次,确认 IP 对得上:
host crawl.baidu.com
# 必须返回原 IP 220.181.108.100,双向一致才是真蜘蛛!
2. 日志中批量过滤真蜘蛛
百度官方的真蜘蛛 IP 段虽然经常变动,但主力段长期集中在 220.181.、180.76.、116.179. 等网段。在做应急排查时,可先用正则提取带有 Baiduspider 的主力网段,再做状态分析:
# 提取今日日志中的百度蜘蛛请求,并保存到独立文件备查
grep -E "Baiduspider" /var/log/nginx/access.log | grep -E "220\.181\.|180\.76\.|116\.179\." > baidu_spider.log
第三步:终端快速排查四件套(无第三方工具依赖)
拿到纯净的百度蜘蛛抓取日志后,不需要导入 Excel,直接在服务器终端敲以下几行命令,核心瓶颈立现。
1. 统计各时间段抓取波峰,判断抓取节奏
检查蜘蛛是在持续平稳抓取,还是集中在某个时间点把服务器打崩,亦或直接断流:
awk '{print $4}' baidu_spider.log | cut -d: -f1-2 | sort | uniq -c- 输出场景分析:如果平时每小时有上万次抓取,某一天突然断崖式跌到两位数,立刻去看是否有防火墙误封、或者宝塔/CDN 的 WAF 开启了高频 CC 拦截,把百度蜘蛛 IP 误杀到了黑名单。
2. 统计 HTTP 状态码分布,排查抓取堵塞
状态码分布是百度蜘蛛抓取日志分析中最重要的体检表:
awk '{print $9}' baidu_spider.log | sort | uniq -c | sort -rn- 200:正常抓取,越多越好。
- 304:Not Modified(未修改)。很多站长以为 304 是报错,大错特错。304 意味着百度爬虫来比对过,发现内容没变,直接返回头部省带宽,这是极其健康的表现。
- 301/302:如果是大面积老链接跳新链接,检查是否有无限死循环重定向。
- 403/404:如果 404 占比超过 15%,说明站内存在死链,或者老旧的历史 URL 没做好映射,百度蜘蛛正在疯狂浪费抓取配额(Crawl Budget)。
- 500/502/503:绝对红线。只要 5xx 状态码占比升高,百度爬虫会立刻触发降频保护机制,后续抓取量直接腰斩。
3. 统计被抓取最多的 URL Top 20,识别“爬取黑洞”
很多时候蜘蛛天天来,但新文章就是不收录,原因在于爬虫全陷在无效页面里了:
awk '{print $7}' baidu_spider.log | cut -d'?' -f1 | sort | uniq -c | sort -rn | head -n 20- 踩坑实录:我曾处理过一个电商网站,百度蜘蛛每天抓 30 万次,新商品却零收录。拉出 Top 20 发现,前十全都是带各类筛选参数(如
?color=red&size=xl&sort=price)的商品聚合页。这种无意义的排列组合产生了上百万个低质 URL,把蜘蛛配额榨干了。 - 解决方案:直接在
robots.txt屏蔽对应动态参数路径,或者给页面加 Canonical 标签。
4. 统计蜘蛛抓取的平均耗时与慢请求
如果蜘蛛抓取一个页面要几秒钟,系统就会判定网站负载承载力差,主动减少抓取。
# 假设你的 Nginx 格式中倒数第二列是 $request_time
awk '{sum+=$NF; count++} END {print "平均抓取耗时:", sum/count, "秒"}' baidu_spider.log

# 抓出响应时间大于 2 秒的 URL 列表
awk '$NF > 2 {print $7, $NF}' baidu_spider.log | sort -k2 -rn | head -n 20- 优化底线:百度蜘蛛抓取的平均响应时间最好压在 0.5 秒以内,超过 1.5 秒必须排查该 URL 对应的数据库慢查询、未命中的 Redis 缓存或复杂的后端聚合接口。
高频关联问题拓展
1. 抓取量很高,但索引量和收录死活不涨?
很多站长在完成百度蜘蛛抓取日志分析后很困惑:明明每天几万个 200 状态码,为什么百度索引库就是不进?
- 原因排查:抓取(Crawl)不等于入库(Index)。日志中的 200 只能代表爬虫成功下载了 HTML 源码,随后内容会进入百度的离线清洗和索引评估流程。
- 对应动作:
- 检查抓取的是否全都是 JS 渲染的空壳。百度虽然有基于 Chromium 内核的渲染蜘蛛(
Baiduspider-render),但抓取资源配额比普通纯文本蜘蛛少得多。普通蜘蛛抓到的只是一个带<div id="app"></div>的空骨架,自然进不了索引。 - 检查页面内容质量,文本重复度是否过高(例如站内大量通过聚合标签生成的列表页)。
- 检查页面主体是否包含大量外链或广告,被百度算法命中降权。
- 检查抓取的是否全都是 JS 渲染的空壳。百度虽然有基于 Chromium 内核的渲染蜘蛛(
2. 百度移动蜘蛛与 PC 蜘蛛比例失衡
看日志里的 UA 标识,百度移动端抓取标识通常带有 Android 或 Mobile:
# 查看 PC 与移动端蜘蛛的抓取比例
grep "Baiduspider" baidu_spider.log | awk '{
    if ($0 ~ /Mobile/ || $0 ~ /Android/) mobile++
    else pc++
} END {print "移动抓取:", mobile, "PC抓取:", pc}'目前百度全面推行移动优先索引,正常情况下移动蜘蛛比例应占 70%~90%。如果你的网站 PC 蜘蛛反客为主,或者移动蜘蛛抓取量极低,必须检查网站的自适应方案。如果做了移动端独立子域名(如 m.example.com),排查 PC 到移动端的适配跳转代码是否响应了非 200/301 状态码,或者百度移动资源平台是否没绑定移动站点。
3. WAF 与 CDN 误杀百度蜘蛛
在实际运维中,最常见的一场空欢喜是:配置了过于激进的“CC防御”规则。比如某款免费防火墙规则是“单 IP 1 秒内请求超过 20 次拉黑”。百度蜘蛛并发抓取极高,一旦触发阈值,整个网段的蜘蛛 IP 全被临时拉黑,在日志中体现为瞬间涌现大量 403 状态码,紧接着抓取量直接归零。
- 排查方法:在防火墙/WAF 拦截日志里搜索是否有百度官方 IP 段的拦截记录;
- 解决办法:直接在 Nginx 或安全组中将百度蜘蛛网段加入白名单,或开启安全软件自带的“搜索引擎爬虫白名单”开关。
结尾总结
把百度蜘蛛抓取日志分析落到实处,不需要迷信昂贵的 SaaS 系统或复杂的架构。它本质就是一张服务器与搜索引擎交互的“体检心电图”。
日常运维中,建议将上述四个关键排查命令写成一个简单的定时 Shell 脚本,每天清晨跑一次前一天的日志,自动生成统计报表并通过邮件或企业微信机器人推送到群里:
- 一旦发现 5xx 状态码突增、响应时长大于 1 秒、或 总抓取量跌幅超过 50%,立即触发告警。
永远记住:收录下跌只是果,日志中的异常状态码与超时响应才是因。抓取先出问题,收录才会在两周后崩盘。盯紧日志,在蜘蛛掉头离场前把堵点通开,才是最稳妥的排障姿势。