
网站重复内容排查方法:网站重复内容全流程排查实战
做网站重复内容排查方法最快最狠的组合拳,就是“URL层规范化审计 + 文本SimHash哈希比对脚本 + 服务器日志与Sitemap交叉验证”,别一上来就去买那些大几千块一年的商业SaaS工具,纯属交智商税,几行Nginx配置加一个几十行的Python自动化脚本,就能把全站95%以上的重复死角扒得干干净净。
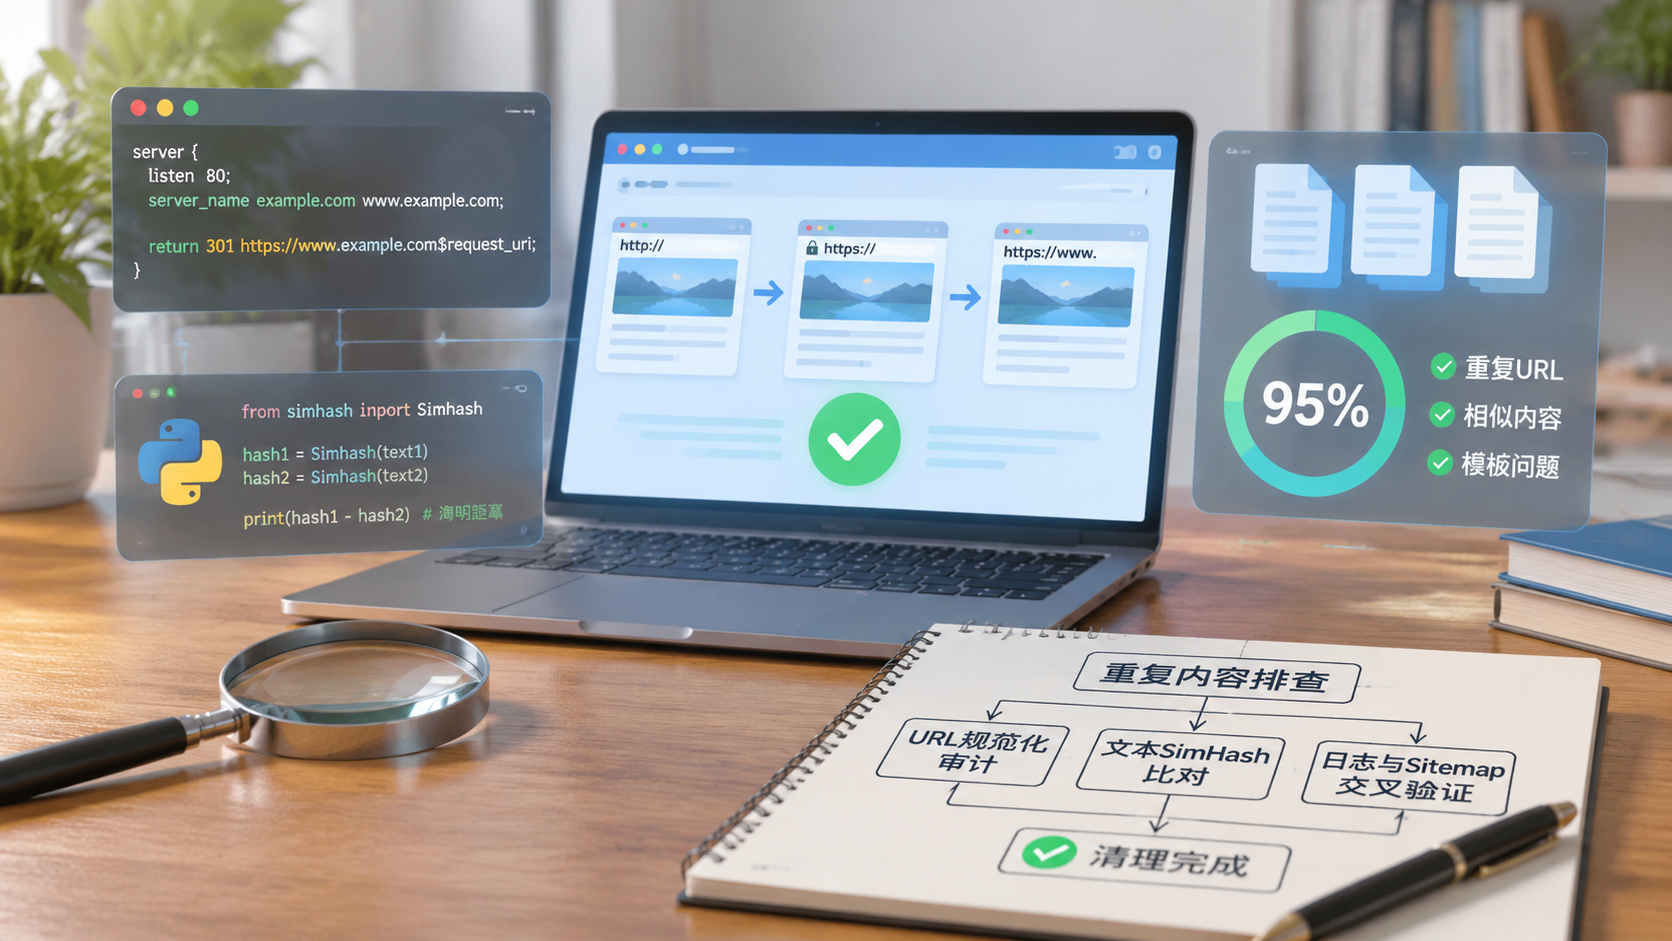
很多技术人员和站长总觉得“我每个页面数据库ID都不一样,怎么会有重复内容?”实际上,大小写混用、尾部斜杠不统一、跟踪参数泛滥、CMS伪静态规则配置失误,甚至前端模板里公共组件占比过大,都会让搜索引擎或爬虫认定你的站点充斥着海量的垃圾克隆页。这不仅极度浪费服务器抓取配额(Crawl Budget),更会导致关键业务页面被算法降权。
核心排查方案速览
快速排查不是漫无目的地抓网页,必须按层次从外到内切入:
- 第一层:URL逻辑与协议层(最容易翻车)
- 排查点:HTTP与HTTPS混跑、带www与不带www共存、URL尾部带斜杠
/与不带斜杠、大小写敏感路由、多余的追踪参数(utm_source等)。
- 排查点:HTTP与HTTPS混跑、带www与不带www共存、URL尾部带斜杠
- 第二层:动态翻页与筛选聚合层(模板类重复)
- 排查点:空筛选结果页、价格/时间正反序排序生成的不同URL、翻页后页面Title/H1未标记页码导致的模板级高度相似。
- 第三层:DOM文本相似度层(正文级重复)
- 排查点:批量采集未深度清洗的内容、多分类共用同一篇文章、多城市分站纯粹替换地名(典型的站群劣质伪原创)。
实操细节深度拆解
1. URL逻辑层自动化排查(先扫网络与路由)
先别急着写爬虫,直接用 curl 检查基础网络层的重定向状态。很多老站长配置Nginx时图省事,经常漏写状态码,导致 302 临时重定向满天飞,甚至两头都能访问(返回 200)。
在终端执行以下命令,测试基础重定向是否规范:
# 测试HTTP是否强制301跳HTTPS
curl -I http://yourdomain.com

# 测试不带www是否强制跳转到主域
curl -I http://yourdomain.com/test-page

# 测试尾部带斜杠和不带斜杠是否唯一
curl -I https://www.yourdomain.com/category
curl -I https://www.yourdomain.com/category/
避坑实操:Nginx底层统一规范配置
如果发现两边都返回 200,立即在Nginx主配置中强制301跳规范主域名,别留任何活口:
# 强制收敛到 https://www.yourdomain.com 且规范去除/保留斜杠
server {
    listen 80;
    server_name yourdomain.com www.yourdomain.com;
    return 301 https://www.yourdomain.com$request_uri;
}

server {
    listen 443 ssl http2;
    server_name yourdomain.com;
    return 301 https://www.yourdomain.com$request_uri;
    # ... ssl 证书配置 ...
}
并在所有页面HTML头部硬编码(或动态输出完全合规的)规范标签,防止参数污染:
<link rel="canonical" href="https://www.yourdomain.com/actual-content-url" />2. 文本正文相似度排查(自制Python批处理脚本)
商业工具慢且受限于页面数量上限。这里直接用 Python 的 simhash 算法批量抓取内部链接并计算内容指纹。海明距离(Hamming Distance)小于等于3,基本就可以判定为高度重复内容。
环境依赖准备:
pip install requests beautifulsoup4 simhash极速比对脚本(可直接保存运行):
import requests
from bs4 import BeautifulSoup
from simhash import Simhash

# 待检查的URL列表,可从Sitemap提取或数据库导出
urls = [
    "https://www.yourdomain.com/article/101",
    "https://www.yourdomain.com/article/102",
    "https://www.yourdomain.com/city-beijing/service",
    "https://www.yourdomain.com/city-shanghai/service"
]

headers = {'User-Agent': 'Mozilla/5.0 (Internal-Audit-Bot)'}

def get_clean_text(url):
    try:
        resp = requests.get(url, headers=headers, timeout=5)
        if resp.status_code != 200:
            return ""
        soup = BeautifulSoup(resp.text, 'html.parser')

        # 核心:必须干掉导航栏、页脚、侧边栏等全局公共元素,只留正文容器
        for element in soup(["nav", "footer", "header", "script", "style", "aside"]):
            element.extract()

        # 假设正文在 id='content' 或 class='article-body',请根据站点修改
        content_div = soup.find('div', class_='article-body') or soup.find('body')
        return content_div.get_text(strip=True) if content_div else ""
    except Exception as e:
        print(f"抓取失败 {url}: {e}")
        return ""

# 计算指纹
hashes = {}
for u in urls:
    text = get_clean_text(u)
    if text:
        hashes[u] = Simhash(text)

# 交叉比对海明距离
print("\n--- 重复内容筛查报告 ---")
url_list = list(hashes.keys())
for i in range(len(url_list)):
    for j in range(i + 1, len(url_list)):
        u1, u2 = url_list[i], url_list[j]
        # 距离越小越相似,3以内判定为严重重复
        dist = hashes[u1].distance(hashes[u2])
        if dist <= 3:
            print(f"[严重重复 Warning] 距离: {dist}")
            print(f"URL 1: {u1}")
print(f"URL 2: {u2}\n")实操避坑点:提取网页文本时,务必把全局通用模块(Header/Footer/Sidebar)全部 strip 掉。很多新手直接用 body.get_text(),结果发现全站相似度高达 80%——废话,你页面正文才200字,公用导航和备案信息就占了500字,机器自然判定全是复制黏贴。
3. CMS筛选聚合页与翻页“死循环”排查
电商站、分类信息站是重复内容的重灾区。比如多重条件筛选页:
/list?cat=1&color=red&sort=price/list?color=red&cat=1&sort=price
这两个URL参数顺序不同,返回内容完全一样,但搜索引擎会当成两个新页面抓取。
排查手段:
利用 access.log 分析蜘蛛抓取频率,找出那些蜘蛛天天来爬但毫无价值的参数URL。
# 提取百度蜘蛛/谷歌蜘蛛抓取频率前50的动态参数URL
grep -i "Googlebot" /var/log/nginx/access.log | awk '{print $7}' | cut -d'?' -f2 | sort | uniq -c | sort -nr | head -n 50
如果看到大量无意义的 sort=、sessionid= 充斥其中,直接上 robots.txt 封堵:
User-agent: *
Disallow: /*?*sort=
Disallow: /*?*order=
Disallow: /*?*sessionid=
高频关联问题拓展
1. 移动端独立站点(M站)被搜索引擎识别为PC端重复内容?
很多老架构是 www.domain.com 对应 PC 端,m.domain.com 对应移动端。如果不做双向注解,移动站分分钟被当成恶意镜像。
正确解法:在两端代码中明确互相对称的标记:
- PC 端页面头部声明对应的移动端 URL:
<link rel="alternate" media="only screen and (max-width: 640px)" href="https://m.yourdomain.com/page-1" /> - 移动端页面头部一律 canonical 指向 PC 端:
<link rel="canonical" href="https://www.yourdomain.com/page-1" />
2. CMS自动生成的翻页(Pagination)导致大量标题完全重复?
点开博客或者分类页,第1页、第2页一直到第50页,Title标签全都是《技术开发资讯 - 某某网站》,被站长后台或SEO工具大面积报警“重复Title”。
直接改模板代码修复:
在CMS模板的 <title> 逻辑中强制加上当前分页变量。
例如 PHP 原生逻辑中:
<title><?php echo $page_title; ?><?php if($paged > 1) { echo " - 第 " . $paged . " 页"; } ?> - 官方网站</title>只要加上“第X页”,既保持了列表页的语义关联,又彻底解决了页面元数据的重复冲突。
总结
网站重复内容排查方法不是等收录暴跌了才临时抱佛脚的补救措施,它本质上是一套日常的代码和架构规范治理流程。
- 先用
curl强制清理掉协议层、域名解析层、尾部斜杠不统一等低级URL重复; - 再通过带DOM过滤的
SimHash脚本,定期对核心正文做自动化文本指纹扫描,剔除低质克隆页; - 最后卡死CMS系统的筛选参数和分页规则,善用
robots.txt阻断蜘蛛爬取无意义的排序矩阵,用canonical标签做好最终托底收敛。
整套逻辑跑顺了并嵌入到你的发布系统和日常运维监控里,站内的内容架构才会清爽,爬虫抓取效率也才能真正提上去。