
站内搜索无结果词需求挖掘:挖掘站内搜索无结果词实战
站内搜索无结果词需求挖掘的最快路径,就是直接抓取搜索引擎或数据库日志中返回结果数为0的Query,按频次清洗聚类后,反手把它做成内容增补、商详补货或重定向词典。很多团队天天花大价钱买外部竞品词库、买第三方SEO数据,殊不知自己网站每天产生的大量“无结果搜索词”,才是用户拿着喇叭在你耳边喊的真实需求。
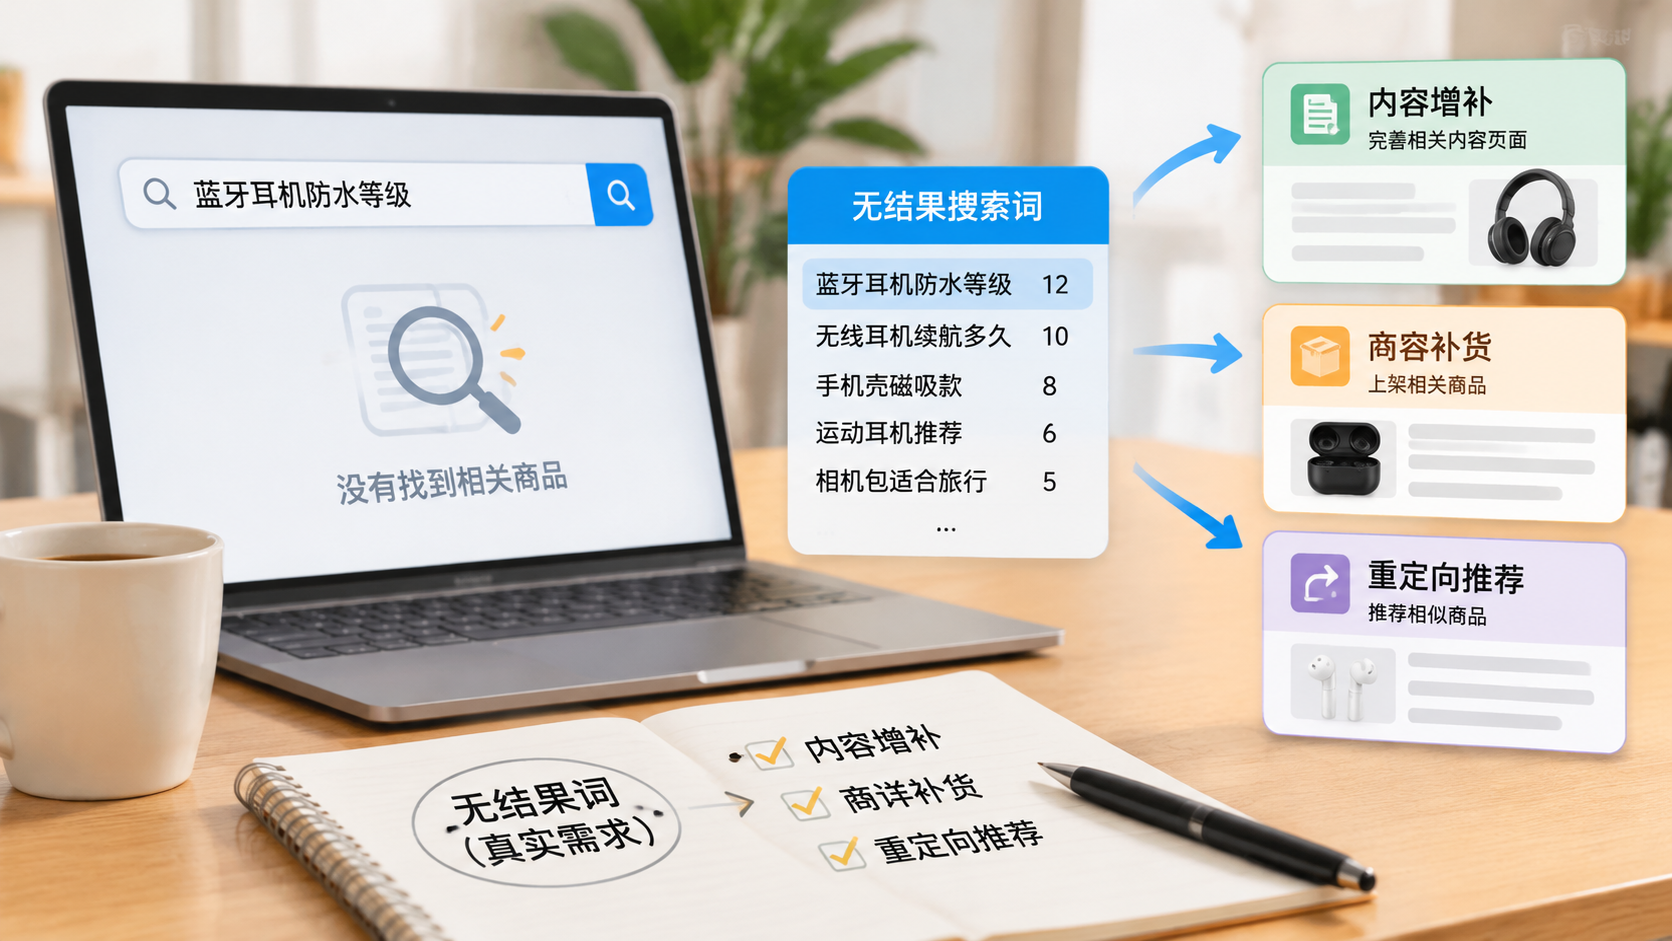
核心方案速览
不要把这件事搞得像做大数据架构一样复杂,中小站点或垂直业务按以下极简流转即可落地:
[前端/API搜索请求]
       │
       ▼
[记录搜索日志] ──(包含:Query、HitCount、UID、Time)
       │
       ▼ (HitCount == 0 且 频次过滤)
[清洗聚类脚本] ──(剔除注入攻击/清洗纯乱码/拼写归一化)
       │
       ├─► 错别字/近义词 ──► 配置搜索引擎Synonym词典 / 前端智能纠错
       ├─► 真实缺失内容 ──► 自动建档推入内容/选品需求池,批量生产页面
       └─► 替代品/下架需求 ──► 配置零结果兜底推荐逻辑,防止跳出
实操细节深度拆解
第一步:日志埋点与采集(绝不能漏掉HitCount)
大部分站长和后端在写搜索接口时,只记了“谁搜了什么”,根本没记录“搜出来多少条”。没有结果数(HitCount),你就没法直接过滤零结果。
如果是自建系统,直接在搜索逻辑执行完毕后,往数据库或异步队列抛一条日志。表结构极其简单,直接照抄这个结构:
CREATE TABLE `search_zero_query_log` (
  `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT,
  `query` varchar(128) NOT NULL DEFAULT '' COMMENT '用户搜索词',
  `hit_count` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '返回结果条数',
  `user_ip` varchar(45) NOT NULL DEFAULT '' COMMENT '用户IP,排查刷量用',
  `user_agent` varchar(255) NOT NULL DEFAULT '' COMMENT 'UA,识别爬虫',
  `created_at` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP,
  PRIMARY KEY (`id`),
  KEY `idx_hit_created` (`hit_count`,`created_at`),
  KEY `idx_query` (`query`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
后端业务层伪代码(以常见的拦截逻辑为例):
def handle_search_request(request):
    keyword = request.args.get('q', '').strip()
    if not keyword:
        return jsonify([])

    # 你的核心搜索查询逻辑(Elasticsearch/MySQL/Meilisearch)
    search_results = do_search(keyword)
    hit_count = len(search_results)

    # 异步或打点记录,注意 HitCount 为 0 也必须入库
    log_search_event(
        query=keyword,
        hit_count=hit_count,
        ip=request.remote_addr,
        ua=request.headers.get('User-Agent')
    )

return jsonify(search_results)避坑点:如果你的站点量级很大,千万别每次搜索都直接同步写MySQL,会把数据库写死锁。走Redis的RPUSH存进队列,或者直接写进Nginx的access.log自定义日志格式,后续用Filebeat收集。
第二步:数据清洗与聚类过滤(挤掉脏数据)
拿到hit_count = 0的词后,不能直接给业务人员看。因为里面充斥着三类垃圾:SQL注入/XSS探测payload、纯无意义符号乱码、以及黑客扫描器打过来的字典。
准备一个定时执行的Python脚本,做初步清洗和聚合:
import re
from collections import Counter
import pymysql

# 简单正则:过滤纯符号、过滤长度异常词
VALID_QUERY_PATTERN = re.compile(r'^[\u4e00-\u9fa5a-zA-Z0-9\s\-_]{2,30}$')
# 过滤常见注入字符
INJECTION_KEYWORDS = ['select', 'union', 'sleep(', '<script', 'eval', 'benchmark']

def is_valid_query(query):
    query_lower = query.lower()
    if not VALID_QUERY_PATTERN.match(query):
        return False
    for bad_word in INJECTION_KEYWORDS:
        if bad_word in query_lower:
            return False
    return True

def process_zero_queries():
    # 假设从昨天日志查出 hit_count = 0 的记录
    raw_logs = fetch_zero_logs_yesterday()
    cleaned_queries = []

    for item in raw_logs:
        q = item['query'].strip()
        if is_valid_query(q):
            cleaned_queries.append(q)

    # 统计词频
    query_stats = Counter(cleaned_queries)

    # 只取搜索次数大于阈值(例如>=3次)的高频无结果词
    high_intent_demands = {k: v for k, v in query_stats.items() if v >= 3}

return high_intent_demands实操经验:聚类清洗时,重点把错别字和真实需求分开。例如搜“苹果15”和“pingguo15”,本质是同一个需求;搜“老版本安装包”和“破解版”,是内容缺失。可以用开源库做基于编辑距离(Levenshtein Distance)的归并,把相似度大于0.85的词聚成一个需求工单。
第三步:需求落地的闭环打法(从数据到产出)
清洗完的站内搜索无结果词,必须落实到具体业务动作中,通常分为三条线:
1. 错别字/近义词 -> 写入搜索引擎 Synonym 词典
如果是错别字、缩写、别名,例如用户搜“显卡驱动更新器”,你的系统里叫“GPU升级工具”,导致搜不到。立刻把映射关系加进ES的同义词过滤器。
以 Elasticsearch 的同义词配置为例:
PUT /my_index
{
  "settings": {
    "analysis": {
      "filter": {
        "my_synonym_filter": {
          "type": "synonym",
          "synonyms": [
            "显卡驱动, GPU驱动",
            "pingguo, 苹果 => 苹果"
          ]
        }
      },
      "analyzer": {
        "my_synonyms_analyzer": {
          "tokenizer": "ik_max_word",
          "filter": [
            "lowercase",
            "my_synonym_filter"
          ]
        }
      }
    }
  }
}
配置之后,搜索无结果的词立刻被消化,系统自动识别,再搜就不可能为0。
2. 内容/SKU确实缺失 -> 自动进入反哺看板
如果是站点确实没有的内容:
- 资讯/技术站:直接将高频词打上标签,生成“内容生产工单”给编辑,甚至调用大模型脚本跑出首版草稿,编辑审核后直接上线。上线之后,这个页面同时吃到了站内搜索流量和站外百度/Google的SEO长尾流量。
- 电商站:高频无结果词是纯粹的“用户购买意图”,导出后直接同步采购或招商部门,告诉他们什么东西用户搜得多但没有货。
3. 页面零结果兜底(别让用户看白板)
在内容还没做出来的这几天,绝不能让用户看到“抱歉,没有找到相关内容”然后直接关网页。 在零结果页面增加兜底策略:
- 降级搜索:移除关键词中的修饰词重新查(例如搜“轻量服务器CentOS7镜像”为0,程序后台自动剥离词干,降级重搜“CentOS7”)。
- 相关推荐:基于搜索词的Category提取,展示该类目下的热门高分内容。
高频关联问题拓展
Q1:站内分词器太死板,明明库里有内容,但搜出来就是0怎么办?
踩坑现场:比如库里有“企业网站安全防护”,用户搜“企业安全防护”,因为你的分词器用了短语强匹配(AND 逻辑),导致哪怕只差一个字也是0条结果。
解决方案:调整检索策略。主查询用 minimum_should_match(最小匹配度),不要搞一刀切的全部命中。在 Elasticsearch 中修改DSL:
{
  "query": {
    "match": {
      "title": {
        "query": "企业安全防护",
        "operator": "or",
        "minimum_should_match": "75%"
      }
    }
  }
}
这样不仅能大幅压低无结果率,还能避免把不相干的内容全捞出来。
Q2:日志里每天几万个无结果词,全是被爬虫用脚本扫出来的垃圾词,怎么解?
踩坑现场:黑客拿自动化工具跑扫描,或者SEO爬虫拿外面的长尾词典在你的站内搜索框疯狂测试,导致提取出来的无结果词全是无意义的长尾废词。 排查与处理:
- 核对IP与Cookie:分析无结果词日志,按IP聚合。单个IP每分钟搜索超过20次的,99%是脚本,统计时直接按IP黑名单过滤。
- 前端加轻量校验:搜索框加简单的人机验证,或者在搜索表单中放一个隐藏的
honeypot(蜜罐)字段。正常用户看不到,爬虫盲填了这个字段的一律不记入数据分析池。
Q3:高频无结果词是竞品的名字,我们网站根本不可能有,怎么处理?
解决方案:不要删掉,这是黄金截流机会。 很多用户会在你的站内搜友商的软件名、产品名。你可以建一个“竞品对比”或者“替代方案”页面。
- 例句页面标题:“从[竞品A]迁移到[我们产品]的完整操作指南” 或 “[竞品A]与[本产品]功能对比”。 当用户在站内搜竞品时,展示这个页面,既消化了无结果词,又精准截留了高意向的转化人群。
结尾总结
站内搜索无结果词需求挖掘,本质上是全站最低成本的“产品与内容需求雷达”。用户在站内搜索框敲下回车的那一秒,是其主动表达意图最强烈的时刻;而返回0条结果,则是用户体验最糟糕、跳出率最高的一刻。
别让用户的需求无声无息地溜走。把hit_count = 0的日志捞起来,洗掉垃圾,加进词典,反哺内容。每天花10分钟扫一眼高频零结果列表,你的网站内容规划和选品方向,就再也不需要闭门造车了。
相关文章
- 长尾关键词挖掘实操:自动化挖掘长尾词的实操打法
- 落地页转化漏斗优化:落地页转化漏斗优化实操指南
- 全站死链排查与404重定向:全站死链清洗与404重定向实操
- CDN缓存命中率调优:CDN缓存命中率拉满实战
- Core Web Vitals性能达标方案:Core Web Vitals实操达标方案
- 网站TTFB首字节耗时排查:网站TTFB首字节耗时排查实战
- 恶意爬虫拦截与服务器防刷策略:恶意爬虫拦截与服务器防刷实战
- 聚合标签页内链权重布局:聚合标签页内链权重布局实战
- 百度API主动推送与快速收录配置:搞定百度API主动推送与快速收录
- Google Search Console抓取错误修复:GSC抓取错误实战排查与修复