
面包屑导航SEO设置:面包屑导航SEO实操指南
做面包屑导航SEO设置,核心逻辑就两句话:前端展示必须用符合语义化的有序列表,后端代码必须无脑注入 JSON-LD 规范的结构化数据。别再用几个 <span> 标签中间加个斜杠糊弄事了,那样做搜索引擎不仅抓不准你的层级结构,Search Console(GSC)里还拿不到富媒体结果展示(Rich Snippets)。
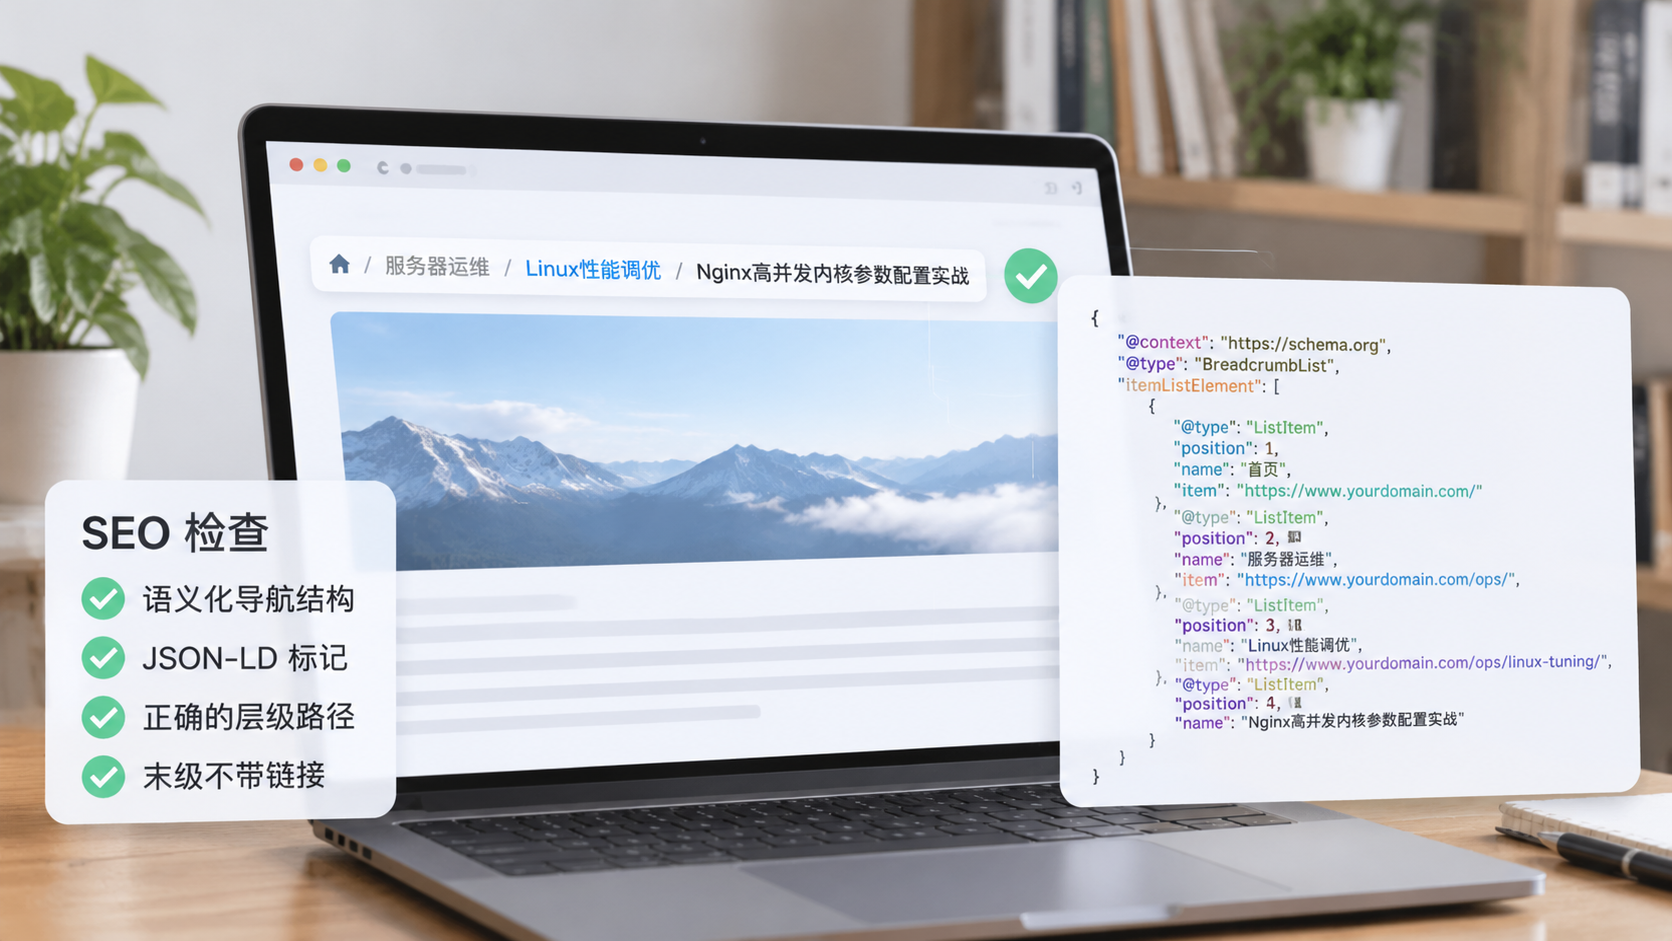
核心方案速览
做好面包屑的 SEO 配置,直接对照下表四项标准执行,别搞花架子:
| 检查维度 | 核心要求 | 常见致命错误 |
|---|---|---|
| 数据标记 | 强制使用 Schema.org 的 BreadcrumbList (JSON-LD) |
还在用十年前废弃的 Data-Vocabulary 协议 |
| DOM 结构 | 使用 <nav> + <ol> 语义化标签 |
全程 div 套 span,缺乏父子从属关系 |
| 路径设计 | 严格基于逻辑层级(首页 > 父类 > 子类 > 详情) | 按用户浏览历史(History-based)瞎跳 |
| 末级处理 | 当前页仅展示文本,不可带超链接 | 最后一级指向当前 URL,形成无效自闭环重定向 |
实操细节深度拆解
1. 结构化数据配置:直接套用 JSON-LD 模板
别去折腾复杂的 Microdata 标签内嵌了,代码极难维护且改动前端样式容易破坏标记。直接在页面 <head> 或 <body> 底部注入 JSON-LD,搜索引擎解析最快、最稳定。
标准生产级代码模板:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BreadcrumbList",
  "itemListElement": [
    {
      "@type": "ListItem",
      "position": 1,
      "name": "首页",
      "item": "https://www.yourdomain.com/"
    },
    {
      "@type": "ListItem",
      "position": 2,
      "name": "服务器运维",
      "item": "https://www.yourdomain.com/ops/"
    },
    {
      "@type": "ListItem",
      "position": 3,
      "name": "Linux性能调优",
      "item": "https://www.yourdomain.com/ops/linux-tuning/"
    },
    {
      "@type": "ListItem",
      "position": 4,
      "name": "Nginx高并发内核参数配置实战"
    }
  ]
}
</script>
实操避坑点:
- 必须使用绝对路径:
item字段里的 URL 必须是https://...开头的完整路径,写/ops/这种相对路径,Googlebot 经常抓取解析报错。 - 最后一级的链接处理:看到上面第 4 级没有?当前所在页面(末级)只给
name,不写item。写了等于自己链自己,不仅浪费爬取配额,部分搜索引擎还会判定结构混乱。 position严禁断层:必须从 1 开始递增,切忌动态循环时把position弄成 0 或者跳过数字。
2. 前端 DOM 结构:丢掉伪语义化代码
很多前端图省事,写出这种“垃圾代码”:
<!-- 错误示范:别这么写! -->
<div class="breadcrumb">
  <a href="/">首页</a> > <a href="/cat/">分类</a> > 正文标题
</div>
这样写不仅对屏幕阅读器极其不友好,爬虫也只能靠瞎猜来建立层级关系。同时,中间那个 > 直接硬编码在 HTML 里,有时还会被搜索引擎误识别成标题的一部分。
正规的 HTML5 语义化写法:
<nav aria-label="Breadcrumb" class="breadcrumb-container">
  <ol class="breadcrumb-list">
    <li class="breadcrumb-item">
      <a href="/">首页</a>
    </li>
    <li class="breadcrumb-item">
      <a href="/ops/">服务器运维</a>
    </li>
    <li class="breadcrumb-item">
      <a href="/ops/linux-tuning/">Linux性能调优</a>
    </li>
    <!-- 最后一级:纯文本,加 aria-current 标记当前页 -->
    <li class="breadcrumb-item current" aria-current="page">
      Nginx高并发内核参数配置实战
    </li>
  </ol>
</nav>
配套 CSS 处理分隔符(禁止在 HTML 节点里手打 > 或 /):
.breadcrumb-list {
  display: flex;
  flex-wrap: wrap;
  list-style: none;
  padding: 0;
  margin: 0;
}
.breadcrumb-item + .breadcrumb-item::before {
  display: inline-block;
  padding: 0 8px;
  color: #6c757d;
  content: "/"; /* 用伪元素生成分隔符,不污染文本节点 */
}
.breadcrumb-item a {
  text-decoration: none;
  color: #0066cc;
}
.breadcrumb-item.current {
  color: #333333;
}
3. 复杂业务场景的层级映射策略
平铺直叙的博客好做,但在电商或多标签内容站中,往往一个产品同时属于多个分类(比如:一款显示器既属于“数码办公”,又属于“电竞外设”)。
很多新手在这里犯大忌:直接根据用户的点击路径动态生成面包屑。 用户从电竞分类点进去,面包屑显示:首页 > 电竞外设 > 显示器; 用户从办公分类点进去,面包屑显示:首页 > 数码办公 > 显示器。
这在 SEO 上等于自杀,会导致同一 URL 出现多套不同的结构化数据,直接造成爬虫困惑。
解决策略:主分类锁定机制
- 唯一化原则:不管从哪个入口点进详情页,面包屑导航必须固定展现主分类(Primary Category)路径。
- 配合 Canonical 标签:面包屑的层级路径必须和该页面的
rel="canonical"URL 保持完全一致的归属逻辑。 - 标签(Tags)绝不下场:永远不要把文章 Tag 拼进面包屑里。面包屑代表的是树状目录树(Directory Tree),标签是网状交叉,混在一起会让站点信息架构彻底崩塌。
高频关联问题与避坑指南
Q1:移动端屏幕太窄放不下,能直接用 display: none 隐藏吗?
答:能隐藏视觉展示,但别隐藏 DOM,且必须保留 JSON-LD。 移动端由于宽度限制,常见的合格做法有两个:
- CSS 横向滚动:
overflow-x: auto; white-space: nowrap;,用户可以单指滑动看层级,DOM 完全保留。 - 局部折叠:仅保留“首页”和上一级分类,中间层级省略。
避坑提醒:如果你为了省事,在移动端模板里直接把整个面包屑组件的 HTML 给
v-if="false"删了,并且没挂载 JSON-LD,那么在 Google “移动优先索引(Mobile-First Indexing)”机制下,你的面包屑权重在蜘蛛眼里直接等于零。
Q2:单页应用(SPA)动态渲染面包屑,爬虫抓得到吗?
答:有极高概率抓漏。 很多用 Vue/React 写的网站,面包屑是靠路由监听在前端二次渲染出来的。虽然现代搜索引擎具备渲染 JS 的能力,但对 API 响应慢的页面,渲染超时就会抓成空标签。 解决办法:
- 必须在 SSR(服务端渲染,如 Next.js/Nuxt.js)阶段把 HTML 和 JSON-LD 一并吐出来。
- 只要首屏源码(View-Source)里看不到
<script type="application/ld+json">,这套面包屑导航SEO设置在大型工程里就是不及格的。
Q3:上线后怎么验证设置是否生效?
实操自检三步走:
- Google 富媒体结果测试:上线前把代码贴到 Google Rich Results Test 工具里跑一遍,必须显示绿色的“Breadcrumbs”且零错误、零警告。
- 实时 URL 检查:上线后在 GSC 里面输入目标 URL 点击“测试实际网址”,看抓取到的 HTML 代码里 JSON-LD 是否完整。
- 等待 SERP 替换:通常 1-2 周内,Google 搜索结果原本展示长 URL 的地方,会替换为
域名 > 分类 > 子类形式的清晰文本路径。
结尾总结
面包屑导航在网站全局结构中从来不是可有可无的装饰品。一套规范的面包屑导航SEO设置,对外是向搜索引擎低成本透传站点层级树状图、收割 SERP 富媒体点击率的利器;对内是理顺内链权重流动、降低深层页面跳失率的关键绳索。严格落实“HTML 语义化 + 独立 JSON-LD 注入 + 绝对路径锁定 + 主分类归一”四大原则,其余乱七八糟的冗余优化手段,直接忽略即可。