
网站HTTP502和504错误排查:网站报502和504?教你快速搞定
做运维和站长最怕的是什么?不是需求变了,而是大半夜手机突然狂响,告警群里疯狂刷屏,打开网页一看,赫然显示着“502 Bad Gateway”或者“504 Gateway Timeout”。不仅老板在后面催,百度的抓取频次肉眼可见地下滑,连日常的SEO收录也跟着遭殃。面对这种情况,系统化的网站HTTP502和504错误排查就显得尤为关键。这两个状态码虽然看着像“孪生兄弟”,而且都发生在网关层,但背后的底层病因和解决手段却截然不同。今天咱们就抛开那些晦涩的学术定义,用人话聊聊怎么又快又准地排查并彻底搞定它们。
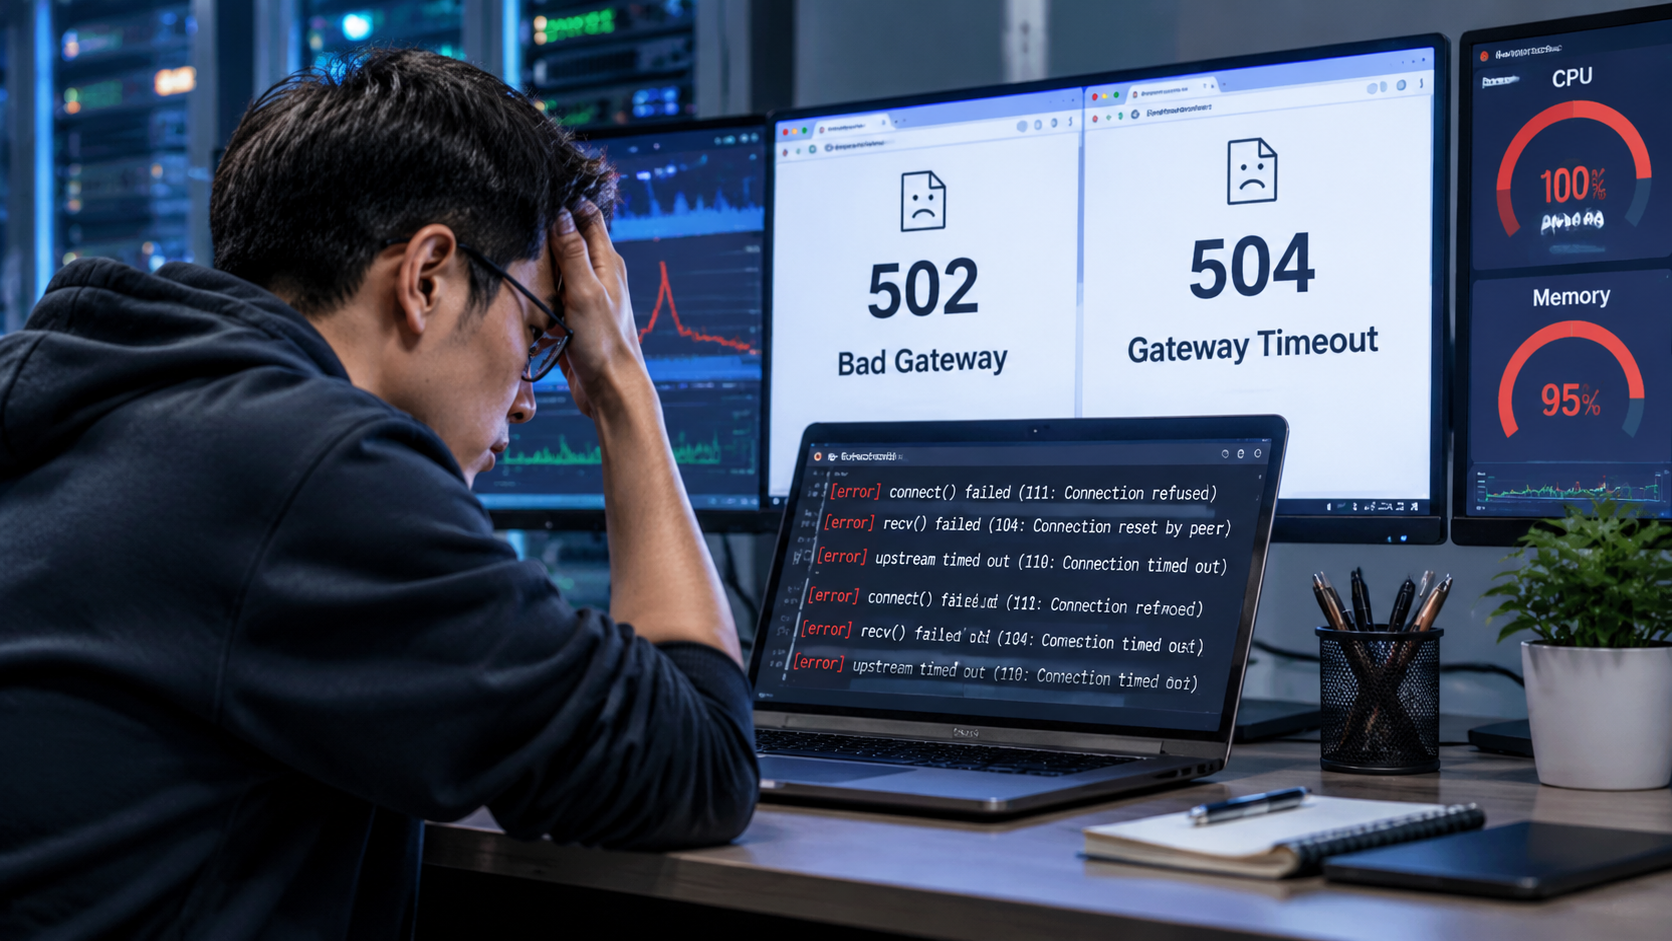
一、 502与504的本质区别:厨师晕倒了还是出餐太慢了?
要搞定排查,首先得弄清楚两者的逻辑差异。现在的网站架构基本都是“代理服务器(如 Nginx、CDN)+ 后端应用(如 PHP-FPM、Node.js、Java、Python)”的模式。
- HTTP 502(Bad Gateway 错误网关): 相当于服务员(Nginx)去后厨找厨师(后端程序)端菜,结果发现厨师直接倒在地上不省人事,或者端出来一盘根本没法吃的废料。也就是说,网关收到了来自上游服务器的“无效响应”。常见原因:后端程序崩溃挂了、进程被杀、端口配置错了。
- HTTP 504(Gateway Timeout 网关超时): 相当于服务员去了后厨,厨师还在那慢悠悠地切菜,服务员等了半小时实在等不及了,只能转头跟客人说“超时了”。也就是说,上游服务能工作,但没能在规定时间内把数据交出来。常见原因:慢SQL、死锁、外部API卡住、服务器CPU/内存跑满。
二、 故障排查第一步:别盲目改配置,先顺藤摸瓜看“案发现场”
很多新手一看到502/504,第一反应是去网上搜几行 Nginx 配置复制粘贴,然后疯狂重启服务器,结果越改越乱。正确的排查必须遵循自外向内的链路追踪:
1. 查看 Nginx 的 error.log(最关键的线索)
不要猜,日志会直接告诉你答案:
- 如果看到
connect() failed (111: Connection refused):说明 Nginx 找不到后端服务,后端应用压根没启动,或者端口/Socket 文件写错了——典型 502。 - 如果看到
recv() failed (104: Connection reset by peer):说明后端服务处理到一半突然崩溃退出了(比如 PHP 触发了 Fatal error 内存爆了)——典型 502。 - 如果看到
upstream timed out (110: Connection timed out):说明后端完全来不及处理,请求超时了——典型 504。
2. 检查服务器底层资源消耗
很多时候错误并不是代码写错了,而是服务器被“榨干”了。
- 输入
top或htop:看看 CPU 占用是不是 100%?负载(Load Average)是不是远远高出核心数? - 输入
free -m:看看可用内存还剩多少?是不是触发了系统的 OOM Killer(内存溢出杀进程机制)?一旦内存跑满,Linux 系统为了自保,往往会直接干掉消耗内存最多的后端进程(比如 php-fpm 或 java),瞬间造成 502。 - 输入
iostat或iotop:检查磁盘 I/O 是不是被占满了。
三、 核心场景的精准“下药”方案
场景 1:高并发引发的 502 错误(后端进程被打爆)
这是电商搞活动、文章被大号转载引流时最容易发生的情况。流量瞬间涌入,后端的处理进程(以 PHP-FPM 为例)全部被占满。
- 解决方案:
- 调整后端进程池大小。比如修改
php-fpm.conf,调大pm.max_children、pm.start_servers,允许同时处理更多的并发连接。 - 如果服务器内存不够支撑更多的子进程,千万不要硬调,否则会直接宕机。此时最应该做的是加一层 Redis 缓存,或者在 Nginx 层配置限流(
limit_req_zone),宁可让一部分请求排队,也不能让整个站点彻底雪崩。
- 调整后端进程池大小。比如修改
场景 2:数据库慢查询导致的 504 超时
这是 504 错误最常见的元凶。用户访问一个页面,后端需要去数据库取数据,结果这个页面包含了一个没有走索引的大表查询,或者遭遇了数据库死锁,整整跑了60秒都没出结果,Nginx 默认等到 60 秒就直接给用户扔出了 504。
- 解决方案:
- 开启数据库慢查询日志(Slow Query Log),找出执行时间超过 1 秒或 2 秒的 SQL。
- 给关联字段加索引,或者优化复杂的多表联查。
- 临时救急方案:如果某些后台导出报表操作确实需要跑几分钟,可以适当调大 Nginx 的超时阈值:
proxy_connect_timeout 300s;
proxy_send_timeout 300s;
proxy_read_timeout 300s;
# 如果是 PHP 环境
fastcgi_read_timeout 300s;
注:调大超时时间只是治标,绝不能当作常规优化手段,否则并发一来,超时请求堆积,服务器死得更快。
场景 3:使用了 CDN(如 Cloudflare)或反向代理引发的错误
现在很多网站都在最前面套了 CDN。有时访客看到的是 CDN 返回的带有 CDN 标志的 502/504 页面。
- 排查方式:
- 绕过 CDN,修改本地
hosts文件,直接将域名解析到源站服务器的真实 IP 上去访问。 - 如果直接连源站是正常的,挂上 CDN 就报 502,很可能是源站的防火墙(如 iptables、fail2ban、云厂商安全组)把 CDN 节点的回源 IP 给当作恶意爬虫给封禁了。把 CDN 官方提供的 IP 段加入白名单即可。
- 绕过 CDN,修改本地
四、 从 SEO 与站长视角看:如何把损失降到最低?
在搜索引擎算法里,持续的 502 和 504 是毁灭性的打击。以百度和 Google 为例,爬虫在抓取网页时如果连续遭遇多次 5xx 错误,算法会迅速判定该网站不稳定、不可信,进而主动降低爬取频次,接着就是快照回退、索引剔除、关键词排名断崖式下滑。
作为站长,遇到这种大面积错误时,排查之余一定要做两件事:
- 如果正在大规模维护排查: 千万不要让它一直飘着 502/504,应该在 Nginx 前端直接返回 503 Service Unavailable 状态码,并附带
Retry-After响应头。搜索引擎对 503 非常友好,知道你这是“临时维护”,不仅不会立刻降权,还会隔一段时间再来抓取。 - 配置静态降级页或使用 Stale Cache(陈旧缓存): 在 CDN 或 Nginx 开启类似
proxy_cache_use_stale error timeout http_502 http_504;的配置。一旦后端挂了或者超时了,Nginx 可以先拿以前缓存好的旧静态页面应付访客和爬虫,保证页面始终能打开,为后端的排查修复争取到极其宝贵的黄金时间。
总结
排查 502 和 504 并不神秘,核心思路无非是:先查日志定性(找原因),再看资源定量(看瓶颈),接着优化链路与配置(做解决),最后做好兜底降级(保SEO)。按照这个逻辑链条一层层剥离,不管面对多复杂的架构,你都能在最短时间内让网站满血复活。
相关文章
- 长尾关键词挖掘实操:自动化挖掘长尾词的实操打法
- 落地页转化漏斗优化:落地页转化漏斗优化实操指南
- 全站死链排查与404重定向:全站死链清洗与404重定向实操
- CDN缓存命中率调优:CDN缓存命中率拉满实战
- Core Web Vitals性能达标方案:Core Web Vitals实操达标方案
- 网站TTFB首字节耗时排查:网站TTFB首字节耗时排查实战
- 恶意爬虫拦截与服务器防刷策略:恶意爬虫拦截与服务器防刷实战
- 聚合标签页内链权重布局:聚合标签页内链权重布局实战
- 百度API主动推送与快速收录配置:搞定百度API主动推送与快速收录
- Google Search Console抓取错误修复:GSC抓取错误实战排查与修复